Benchmarks · 21. Oktober 2026
Hippocampus bei SECQUE: 81 % Erfolgsquote, die höchste von fünf Retrieval-Systemen
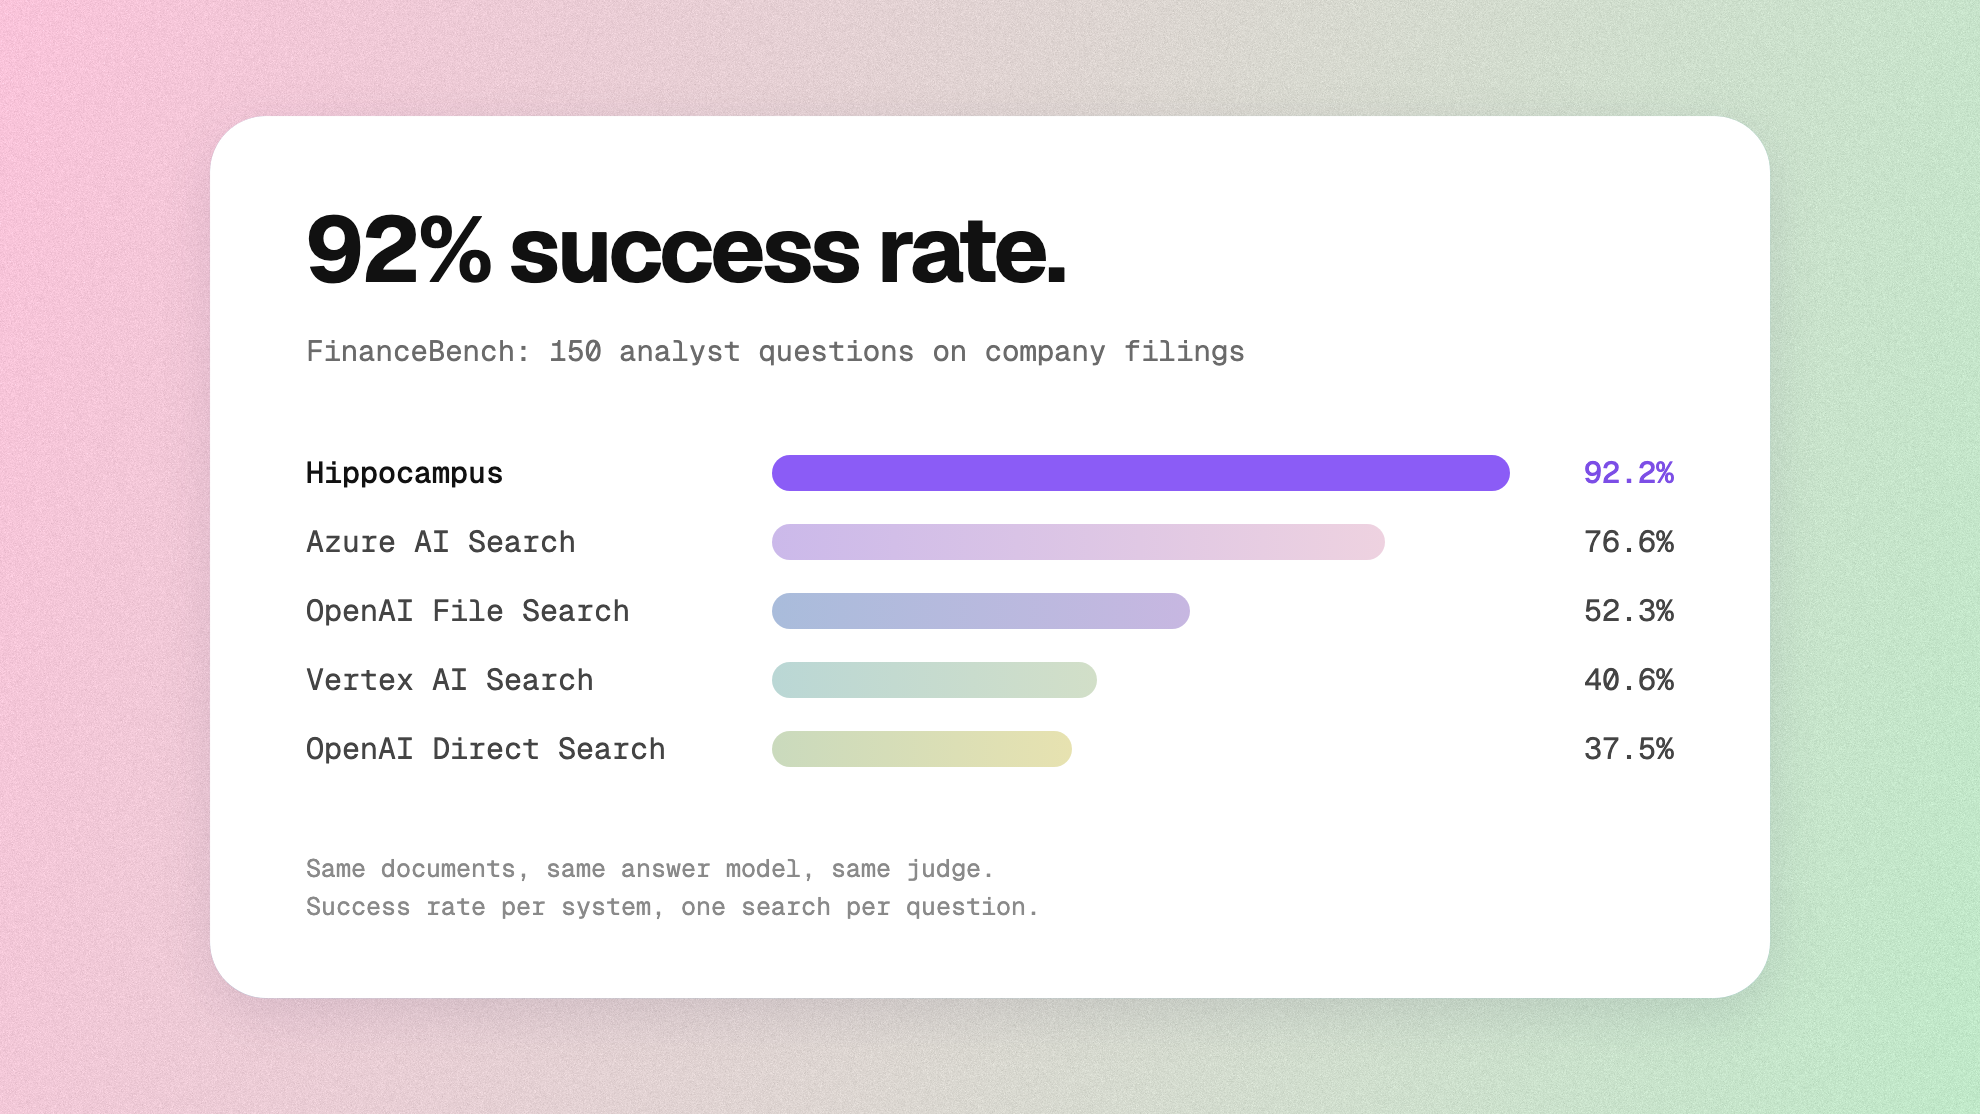
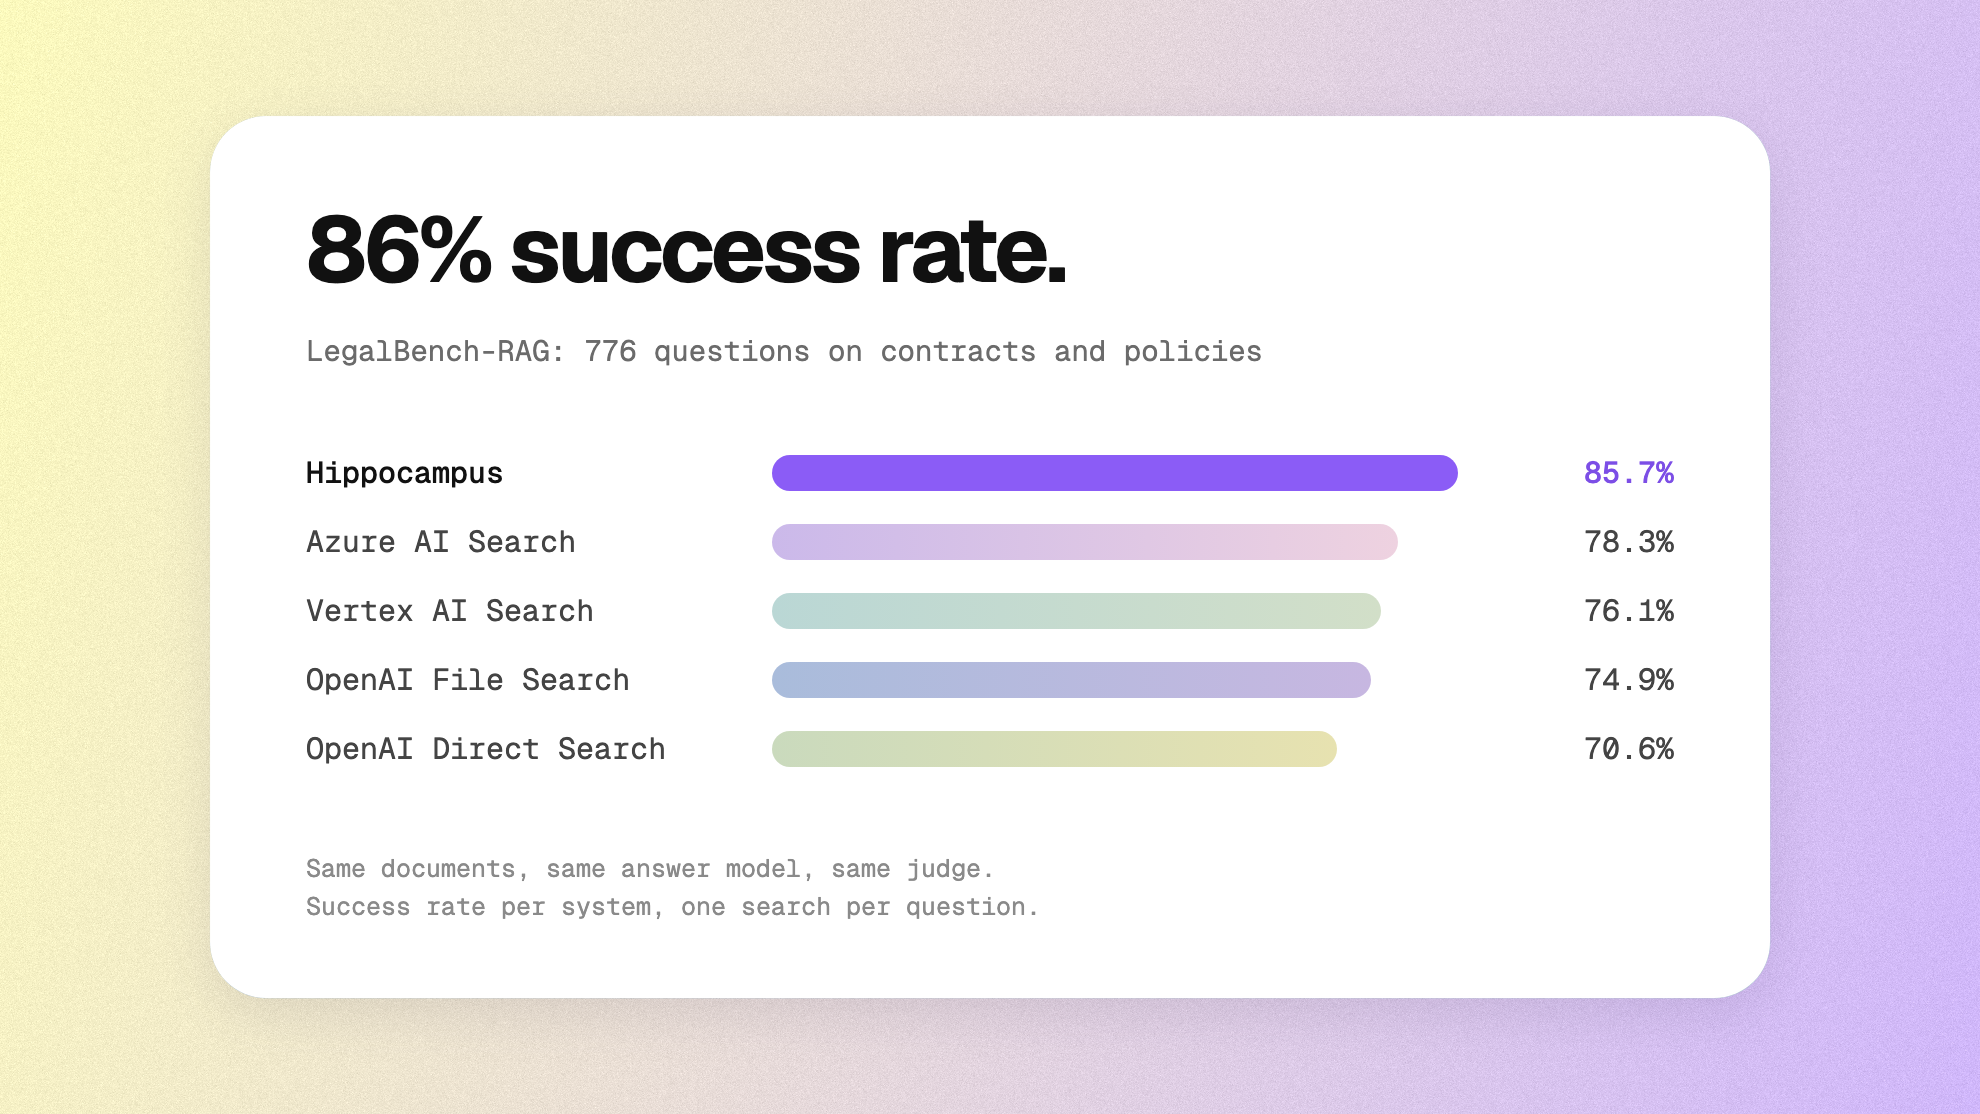
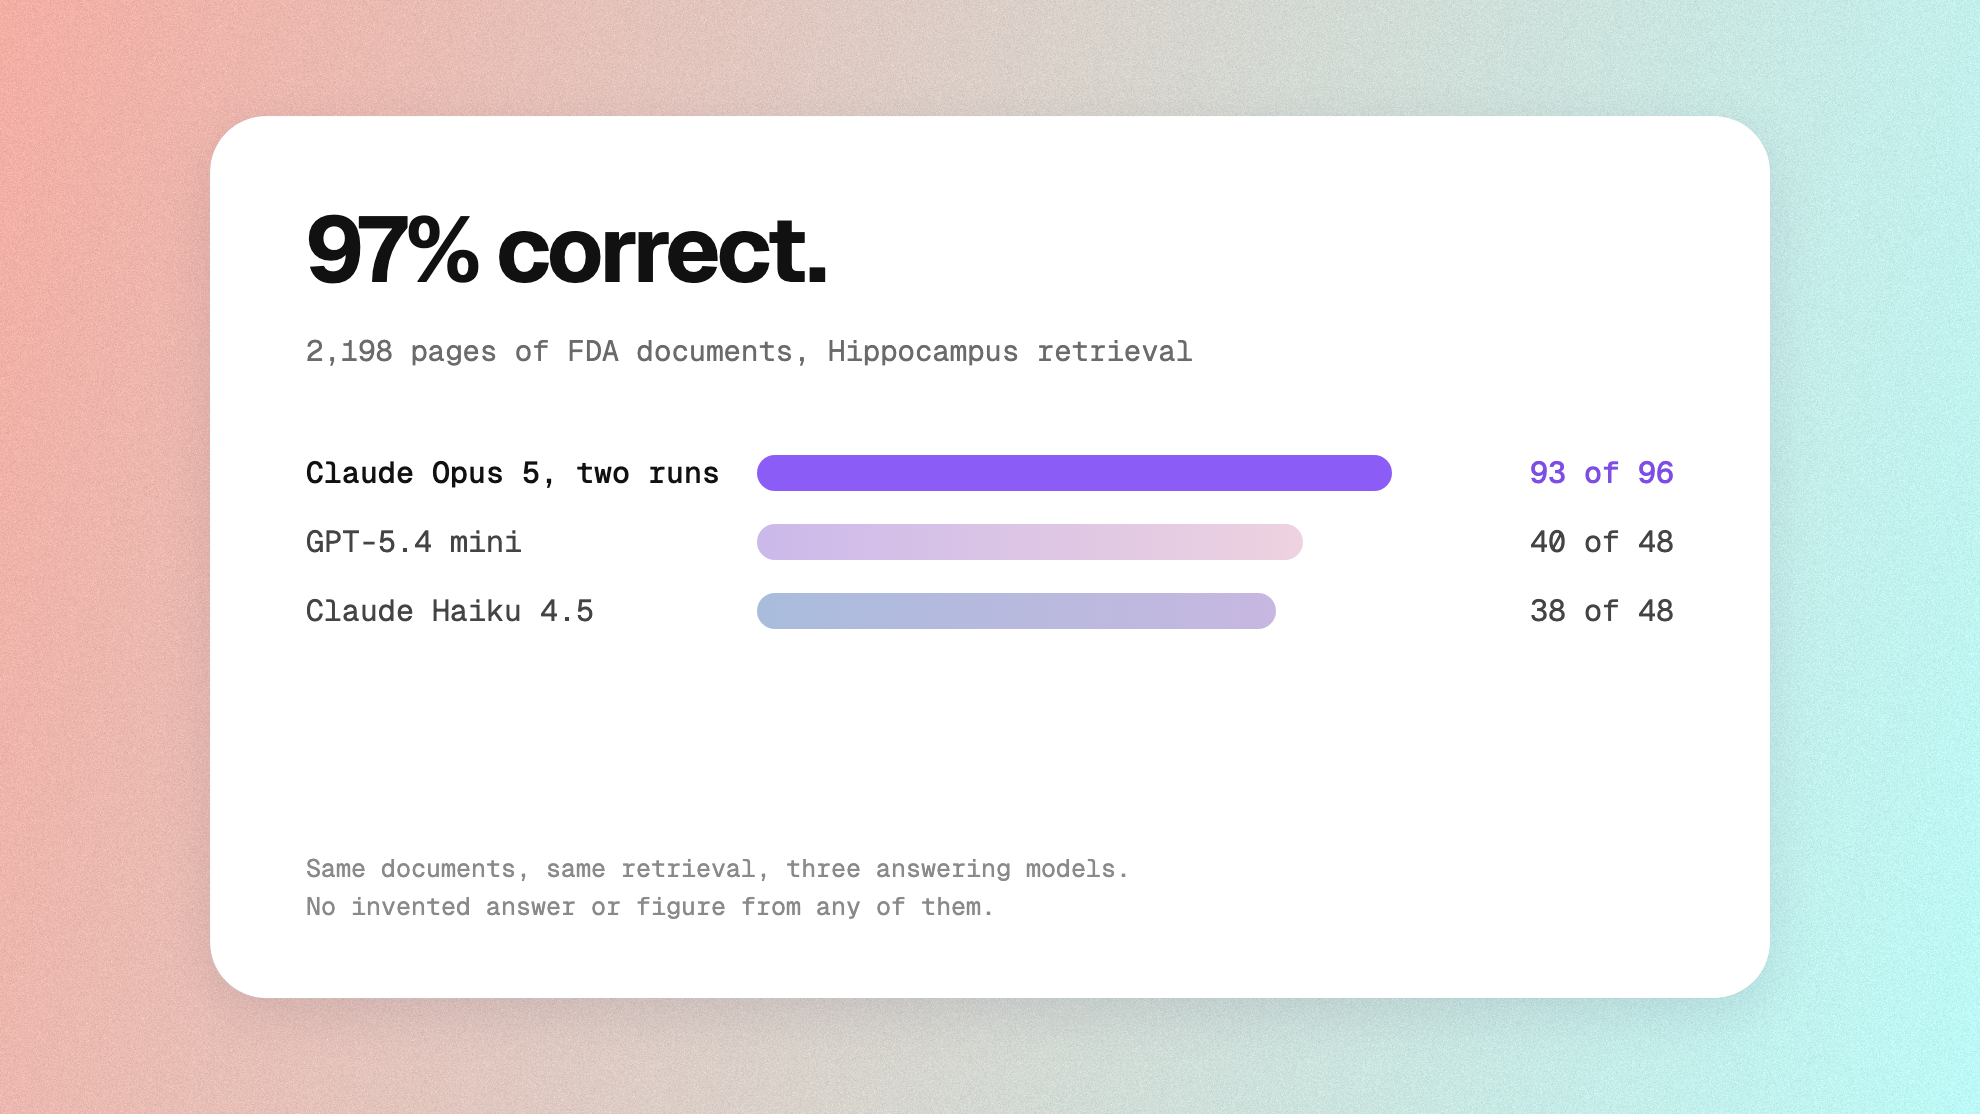
Bei SECQUE erreicht Hippocampus eine Erfolgsquote von 81 %, die höchste von fünf Retrieval-Systemen und 23 Prozentpunkte vor dem nächstbesten System, Azure AI Search, mit 58 %.
Auf dieser SeiteDer Test
Der Test
SECQUE von Ben Yoash und Kollegen stellt 565 Expertenfragen, die quer durch die Finanzabschlüsse von 45 SEC-Berichten vergleichen und rechnen: Verhältniszahlen, Trends, Risiken. Eine Antwort braucht oft mehrere Passagen und eine Berechnung. Er ist einer der Tests in unserem Benchmark-Bericht, Version 3.1, vom 20. Oktober 2026.
So lesen Sie die Zahlen
- Erfolgsquote: der Anteil der von einer perfekten Suche lösbaren Fragen, den jedes System löst. Eine perfekte Suche heißt hier: Das Antwortmodell erhält zu jeder Frage deren eigene Belegseiten; die Fragen, die es trotzdem verfehlt (eine falsche Referenzantwort, eine mehrdeutige Frage oder eine, die selbst mit den richtigen Seiten zu schwer ist), bleiben unberücksichtigt.
- Richtig beantwortet (alle Fragen): Jede Frage zählt, nichts wird herausgefiltert. Eine Antwort ist richtig, wenn der Richter sie als übereinstimmend mit der Referenzantwort des Datensatzes bewertet. Hippocampus 67 %, Azure AI Search 48 %.
- Gefundene Belegpassagen: der Anteil der zur Antwort nötigen Passagen, den die Suche gefunden hat, im Durchschnitt.
- Zur Einordnung: Ohne Dokumente beantwortet das Antwortmodell 26,4 % der Fragen aus dem Gedächtnis richtig. Mit den richtigen Seiten sind es 71,7 %.
Ergebnisse
| System | Erfolgsquote | Richtig beantwortet (alle Fragen) | Gefundene Belegpassagen |
|---|---|---|---|
| Hippocampus | 81,2 % | 67,3 % | 85 % |
| Azure AI Search | 58,0 % | 47,6 % | 46 % |
| OpenAI File Search | 46,2 % | 37,2 % | 37 % |
| Vertex AI Search | 44,7 % | 36,6 % | 33 % |
| OpenAI Direct Search | 36,0 % | 29,9 % | 30 % |
- Direktvergleich mit Hippocampus: Azure AI Search 134 : 23 (p < 10⁻¹⁹), OpenAI File Search 186 : 16 (p < 10⁻³⁷), Vertex AI Search 196 : 23 (p < 10⁻³⁴), OpenAI Direct Search 224 : 13 (p < 10⁻⁵⁰). Jedes Paar stellt die Fragen, die Hippocampus richtig beantwortet hat und das andere System nicht, dem umgekehrten Fall gegenüber (zweiseitiger Vorzeichentest).
Die Referenzantworten sind lang, daher kann eine Antwort richtig sein und trotzdem einen ihrer Punkte verfehlen; etwa 13 % der Fragen (71 von 565) sind strittig.
Erfolgsquote bei SECQUE, fünf Retrieval-Systeme
Von den Fragen, die das Antwortmodell mit den richtigen Seiten richtig beantwortet, ist jeder Balken der Anteil, den ein System mit seiner eigenen Suche richtig beantwortet.
- Hippocampus 81,2 %
- Azure AI Search 58,0 %
- OpenAI File Search 46,2 %
- Vertex AI Search 44,7 %
- OpenAI Direct Search 36,0 %
Tabellenansicht: jede Zahl hinter dem Diagramm
| Name | Wert | Hinweis |
|---|---|---|
| Hippocampus | 81,2 % | |
| Azure AI Search | 58,0 % | |
| OpenAI File Search | 46,2 % | |
| Vertex AI Search | 44,7 % | Ein Suchfehler bei 1 Frage, als nicht übereinstimmend gezählt |
| OpenAI Direct Search | 36,0 % |
Richtig beantwortet bei SECQUE, alle Fragen gezählt
Jeder Balken ist der Anteil aller Fragen, die in Übereinstimmung mit der Referenz beantwortet wurden; das Antwortmodell allein und mit den richtigen Seiten dienen zur Einordnung.
- Hippocampus 67,3 %
- Azure AI Search 47,6 %
- OpenAI File Search 37,2 %
- Vertex AI Search 36,6 %
- OpenAI Direct Search 29,9 %
- Zur Einordnung: das Antwortmodell mit den richtigen Seiten 71,7 %
- Zur Einordnung: das Antwortmodell allein, ohne Dokumente 26,4 %
Tabellenansicht: jede Zahl hinter dem Diagramm
| Name | Wert | Hinweis |
|---|---|---|
| Hippocampus | 67,3 % | |
| Azure AI Search | 47,6 % | |
| OpenAI File Search | 37,2 % | |
| Vertex AI Search | 36,6 % | Ein Suchfehler bei 1 Frage, als nicht übereinstimmend gezählt |
| OpenAI Direct Search | 29,9 % | |
| Zur Einordnung: das Antwortmodell mit den richtigen Seiten | 71,7 % | |
| Zur Einordnung: das Antwortmodell allein, ohne Dokumente | 26,4 % |
Unsere Fehler
Eine automatisierte Prüfung hat die 185 Fragen untersucht, die Hippocampus nicht richtig beantwortet hat: 64 echte Fehler, 56 mehrdeutige Fragen, 35 Probleme mit der Referenz und 30 Antworten, die richtig, aber weniger vollständig als die Referenz waren. Echte Fehler machen 11 % aller Fragen aus. Die Prüfung hilft beim Einordnen der Fehler; sie ist kein menschliches Urteil.
Geschwindigkeit
Hippocampus ist hier das genaueste System, nicht das schnellste. Im Median dauert eine Suche 1,8 Sekunden in Hippocampus, 0,4 Sekunden in Azure AI Search, 0,3 Sekunden in Vertex AI Search und 1,7 Sekunden in OpenAI Direct Search. Diese Zeiten stammen aus Version 2.4 des Berichts und umfassen nur die Suche.
Für eine einfache Antwort aus einem klar abgegrenzten Dokument reicht eine schnelle Cloud-Suche oft aus. Wenn eine Antwort mehrere Passagen braucht, wie bei SECQUE, bringt die zusätzliche Zeit ein anderes Ergebnis: 81 % gegenüber 58 % für den besten Cloud-Dienst und 46 % für OpenAI File Search.
So haben wir getestet
Jedes System hat dieselben Dateien indexiert und pro Frage eine Suche ausgeführt. Dasselbe Antwortmodell (GPT-5.4 mini) schrieb jede Antwort, derselbe Richter (Claude Sonnet 5) bewertete sie. Alle Einstellungen und Prompts finden Sie auf der Nachweisseite im Tab „Finanzen“.
Der Datensatz
SECQUE stammt von Ben Yoash et al., abrufbar unter huggingface.co/datasets/nogabenyoash/SecQue, lizenziert unter MIT. Wir verwenden den Datensatz wie veröffentlicht und berichten nur Ergebnisse: Keine Frage, Antwort oder Passage wird hier wiedergegeben.