Benchmarks · 21 de octubre de 2026
Hippocampus en SECQUE: tasa de éxito del 81 %, la más alta de cinco sistemas de recuperación
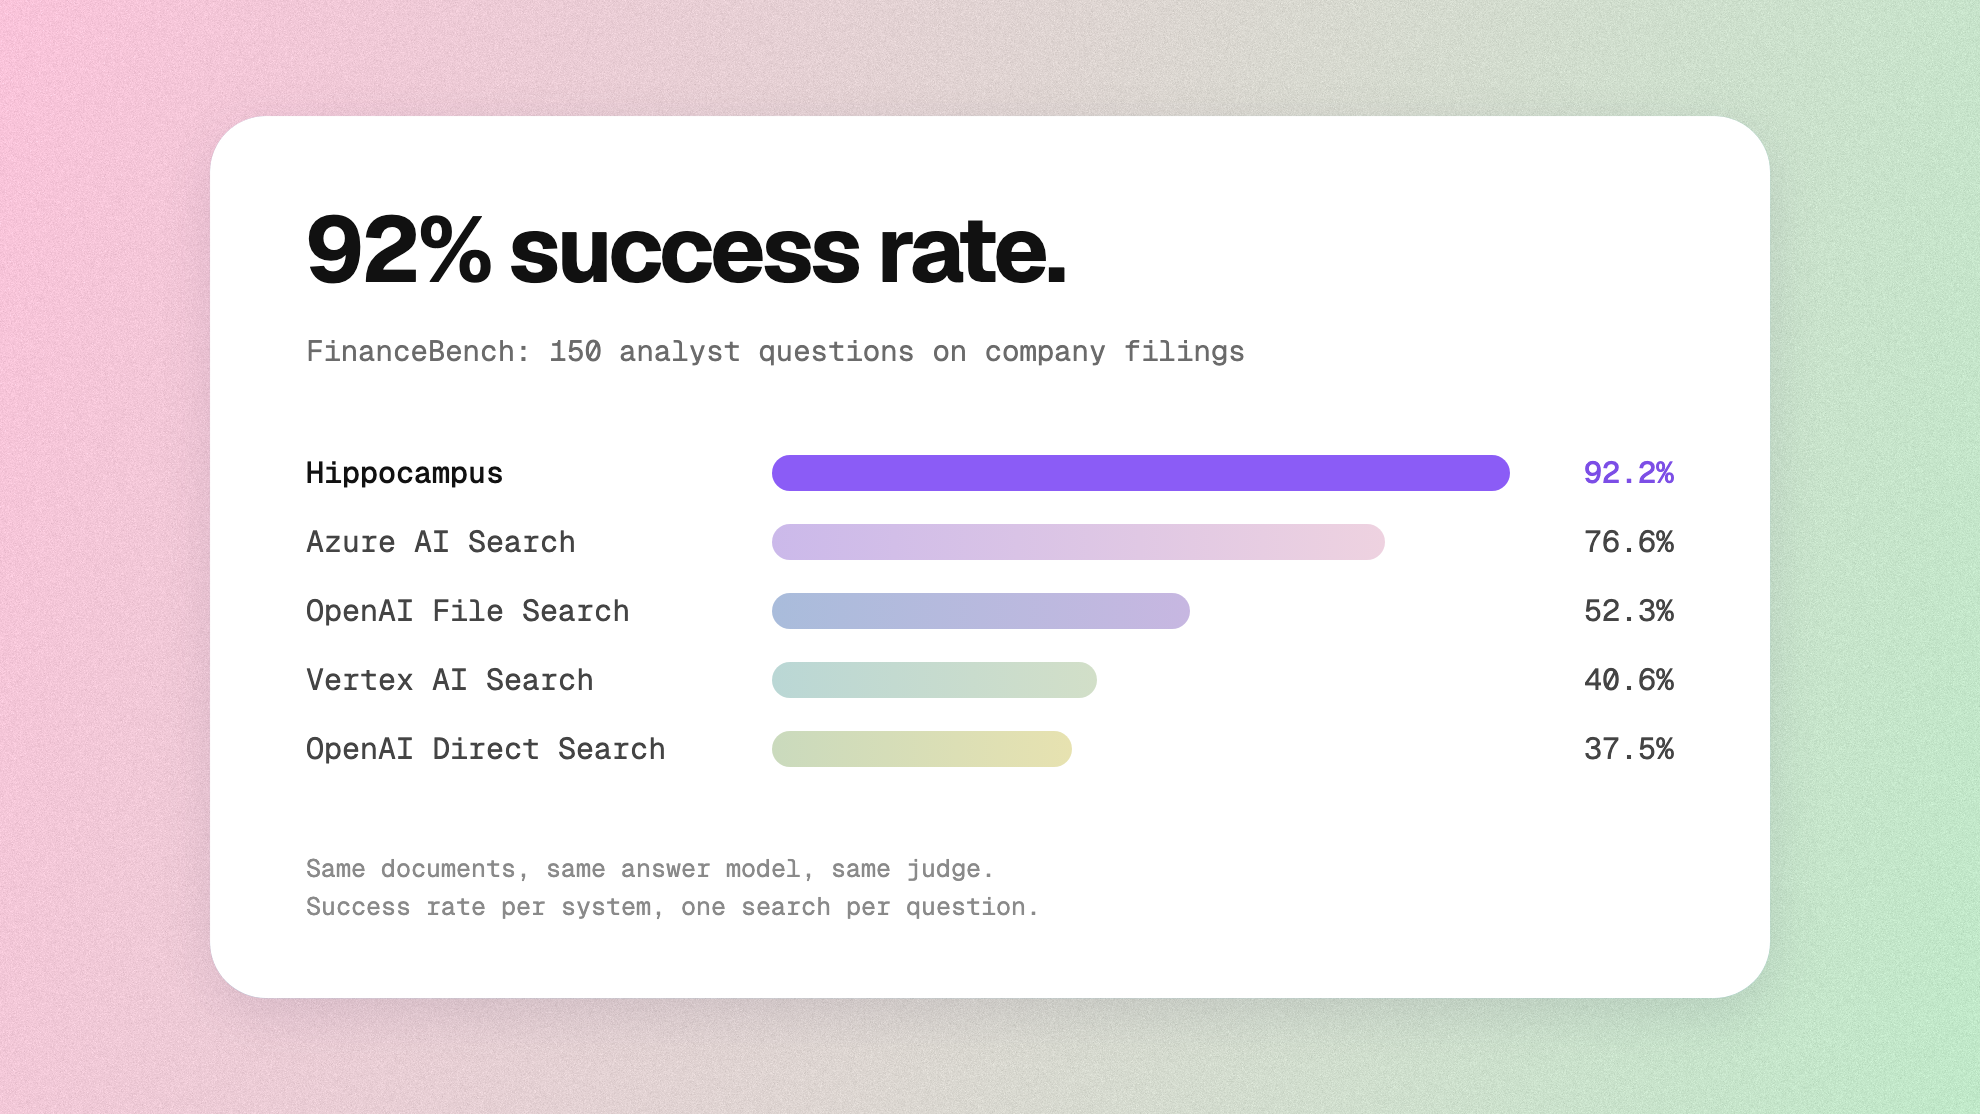
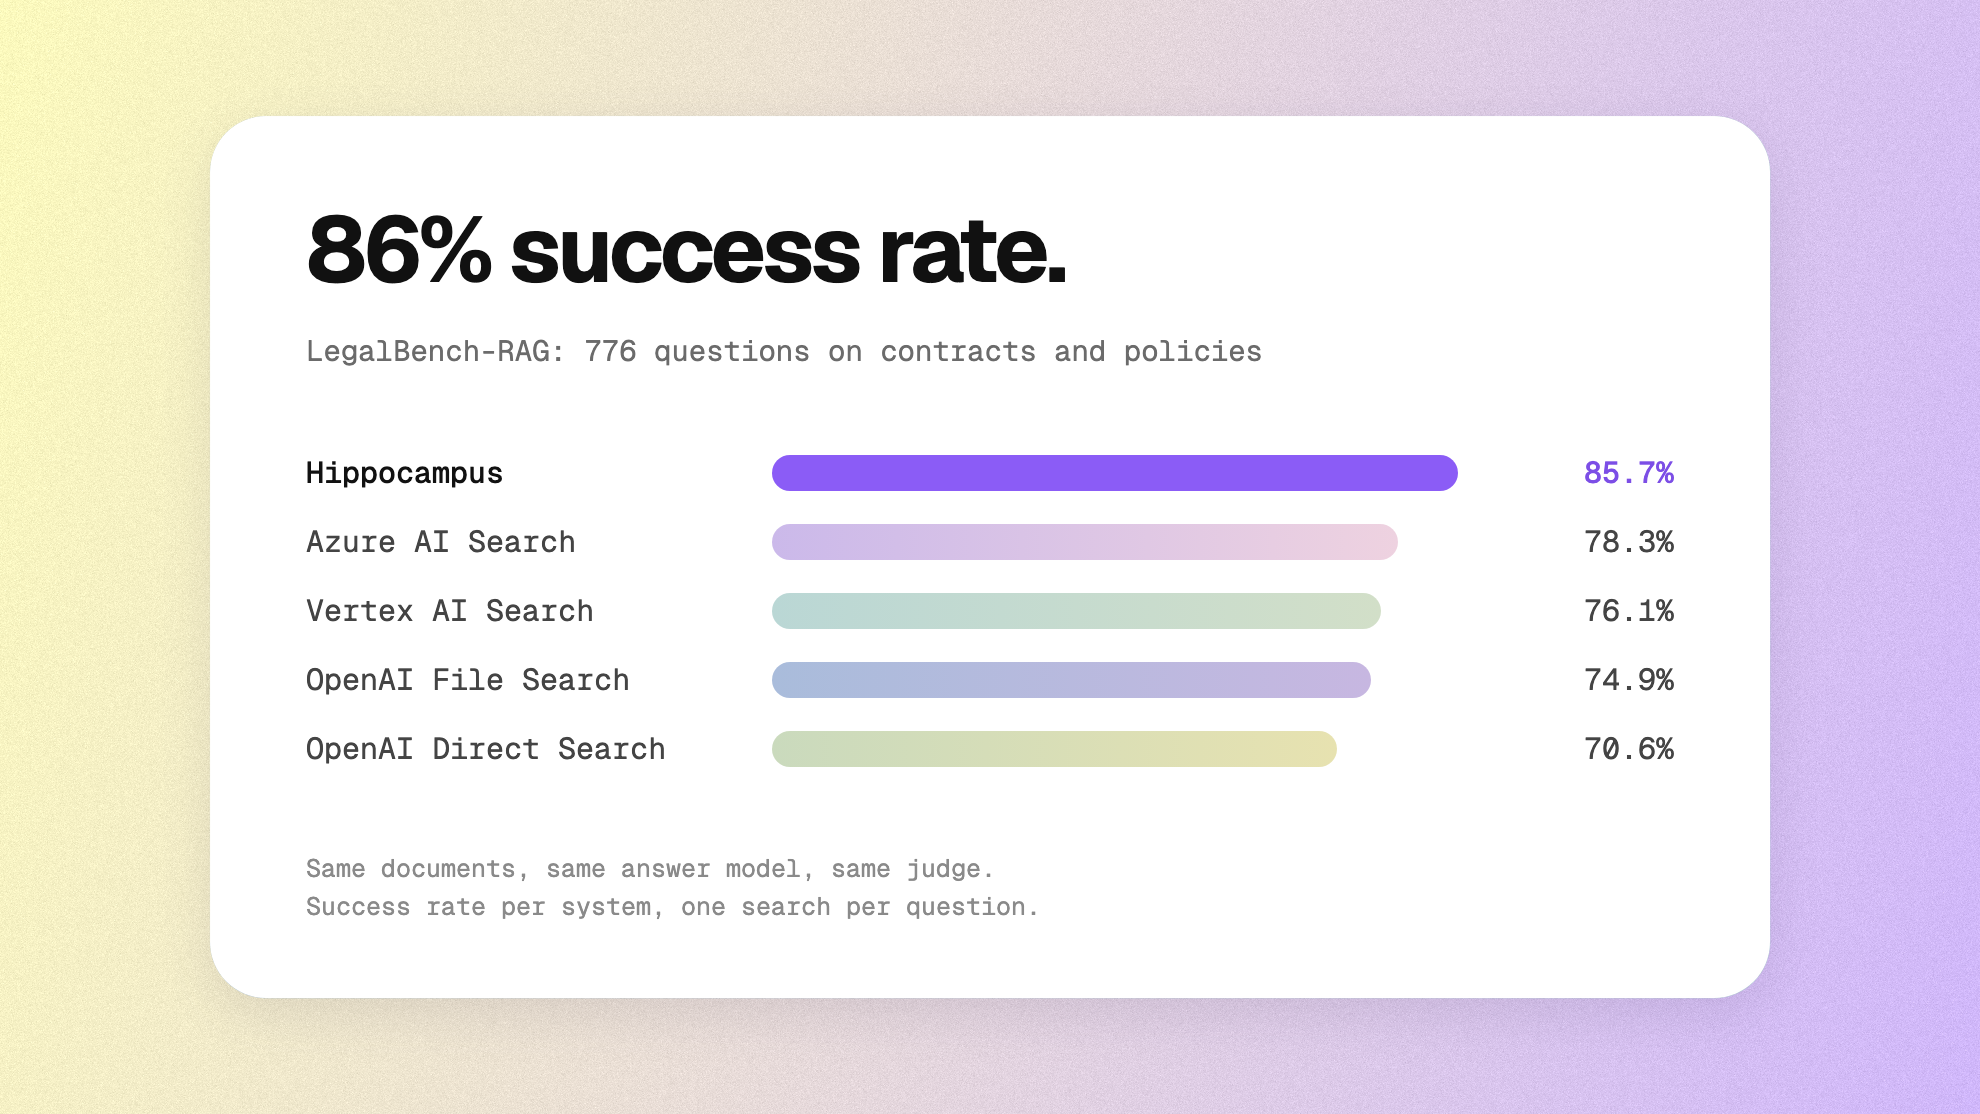
En SECQUE, Hippocampus tiene una tasa de éxito del 81 %, la más alta de cinco sistemas de recuperación y 23 puntos por delante del siguiente, Azure AI Search, con un 58 %.
En esta páginaLa prueba
La prueba
SECQUE, de Ben Yoash y sus colegas, plantea 565 preguntas de expertos que comparan y calculan a partir de los estados financieros de 45 informes presentados ante la SEC: ratios, tendencias, riesgo. Una respuesta a menudo necesita varios pasajes y un cálculo. Es una de las pruebas de nuestro informe de benchmarks, versión 3.1, del 20 de octubre de 2026.
Cómo leer las cifras
- Tasa de éxito: de las preguntas que resolvería una búsqueda perfecta, la proporción que resuelve cada sistema. Aquí, una búsqueda perfecta consiste en entregar al modelo de respuesta las páginas de evidencia de cada pregunta; las preguntas que aun así falla (una respuesta de referencia errónea, una pregunta ambigua o una demasiado difícil incluso con las páginas correctas) quedan fuera.
- Respuestas correctas (todas las preguntas): cuentan todas las preguntas, sin filtrar ninguna. Una respuesta es correcta cuando el juez la considera conforme a la respuesta de referencia del conjunto de datos. Hippocampus 67 %, Azure AI Search 48 %.
- Evidencia encontrada: la proporción de los pasajes necesarios para responder que encontró la búsqueda, de media.
- Como referencia: sin documentos, el modelo de respuesta acierta el 26,4 % de memoria. Con las páginas correctas, acierta el 71,7 %.
Resultados
| Sistema | Tasa de éxito | Respuestas correctas (todas las preguntas) | Evidencia encontrada |
|---|---|---|---|
| Hippocampus | 81,2 % | 67,3 % | 85 % |
| Azure AI Search | 58,0 % | 47,6 % | 46 % |
| OpenAI File Search | 46,2 % | 37,2 % | 37 % |
| Vertex AI Search | 44,7 % | 36,6 % | 33 % |
| OpenAI Direct Search | 36,0 % | 29,9 % | 30 % |
- Cara a cara frente a Hippocampus: Azure AI Search 134 : 23 (p < 10⁻¹⁹), OpenAI File Search 186 : 16 (p < 10⁻³⁷), Vertex AI Search 196 : 23 (p < 10⁻³⁴), OpenAI Direct Search 224 : 13 (p < 10⁻⁵⁰). Cada par enfrenta las preguntas que Hippocampus acertó y el otro sistema no, con el caso inverso (prueba de los signos bilateral).
Las respuestas de referencia son largas, así que una respuesta puede ser correcta y aun así omitir uno de sus puntos; alrededor del 13 % de las preguntas (71 de 565) son discutibles.
Tasa de éxito en SECQUE, cinco sistemas de recuperación
De las preguntas que el modelo de respuesta acierta cuando recibe las páginas correctas, cada barra es la proporción que un sistema acierta con su propia búsqueda.
- Hippocampus 81,2 %
- Azure AI Search 58,0 %
- OpenAI File Search 46,2 %
- Vertex AI Search 44,7 %
- OpenAI Direct Search 36,0 %
Vista de tabla: cada recuento detrás del gráfico
| Nombre | Valor | Nota |
|---|---|---|
| Hippocampus | 81,2 % | |
| Azure AI Search | 58,0 % | |
| OpenAI File Search | 46,2 % | |
| Vertex AI Search | 44,7 % | Un error de búsqueda en 1 pregunta, contado como no coincidente |
| OpenAI Direct Search | 36,0 % |
Aciertos en SECQUE, todas las preguntas contadas
Cada barra es la proporción de todas las preguntas respondidas conforme a la referencia, con el modelo de respuesta solo y con las páginas correctas entregadas como escala.
- Hippocampus 67,3 %
- Azure AI Search 47,6 %
- OpenAI File Search 37,2 %
- Vertex AI Search 36,6 %
- OpenAI Direct Search 29,9 %
- Como referencia: el modelo de respuesta con las páginas correctas 71,7 %
- Como referencia: el modelo de respuesta solo, sin documentos 26,4 %
Vista de tabla: cada recuento detrás del gráfico
| Nombre | Valor | Nota |
|---|---|---|
| Hippocampus | 67,3 % | |
| Azure AI Search | 47,6 % | |
| OpenAI File Search | 37,2 % | |
| Vertex AI Search | 36,6 % | Un error de búsqueda en 1 pregunta, contado como no coincidente |
| OpenAI Direct Search | 29,9 % | |
| Como referencia: el modelo de respuesta con las páginas correctas | 71,7 % | |
| Como referencia: el modelo de respuesta solo, sin documentos | 26,4 % |
Nuestros fallos
Una auditoría automatizada revisó las 185 preguntas que Hippocampus no respondió correctamente: 64 fallos reales, 56 preguntas ambiguas, 35 problemas de la referencia y 30 correctas pero menos completas que la referencia. Los fallos reales son el 11 % de todas las preguntas. La auditoría es una ayuda para leer los fallos, no un veredicto humano.
Velocidad
Aquí Hippocampus es el más preciso, no el más rápido. En la mediana, una búsqueda tarda 1,8 segundos en Hippocampus, 0,4 segundos en Azure AI Search, 0,3 segundos en Vertex AI Search y 1,7 segundos en OpenAI Direct Search. Estos tiempos proceden de la versión 2.4 del informe y cubren solo la búsqueda.
Para una respuesta sencilla en un único documento claramente distinto, una búsqueda rápida en la nube suele bastar. Cuando una respuesta necesita varios pasajes, como en SECQUE, el tiempo extra se traduce en un resultado distinto: un 81 % frente al 58 % del mejor servicio en la nube y al 46 % de OpenAI File Search.
Cómo lo probamos
Todos los sistemas indexaron los mismos archivos e hicieron una búsqueda por pregunta. El mismo modelo de respuesta (GPT-5.4 mini) y el mismo juez (Claude Sonnet 5) se encargaron de todas las respuestas. La configuración completa y los prompts están en la página de pruebas, en la pestaña Finanzas.
El conjunto de datos
SECQUE es de Ben Yoash et al., en huggingface.co/datasets/nogabenyoash/SecQue, con licencia MIT. Lo usamos tal como se publicó y solo informamos de puntuaciones: aquí no se reproduce ninguna pregunta, respuesta ni pasaje.