Benchmarks · 17 de septiembre de 2026
Hippocampus con documentos GLP-1 de la FDA: 97 % de aciertos con Claude Opus 5
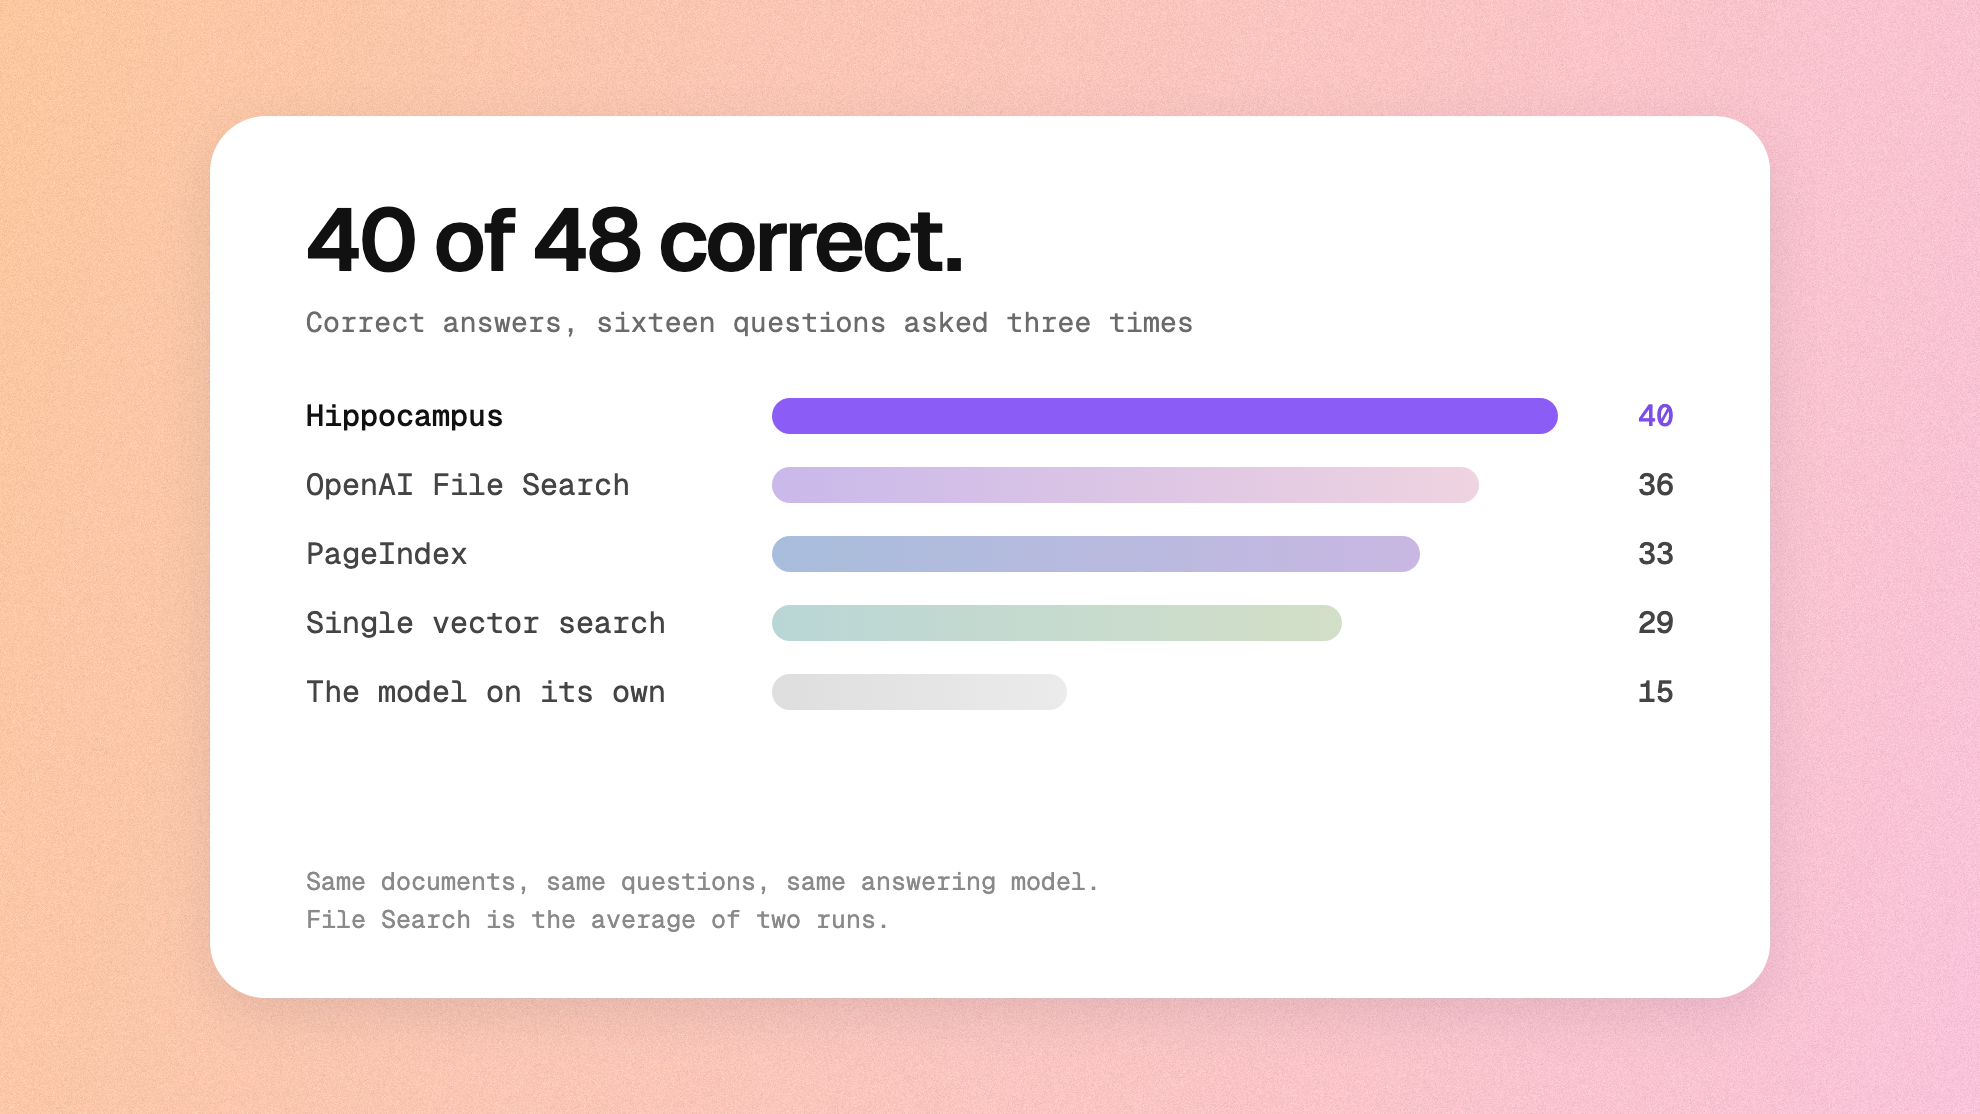
Sobre 2.198 páginas de documentos públicos de la FDA, Hippocampus acertó 93 de 96 respuestas (97 %) con Claude Opus 5 como modelo de respuesta, y no inventó nada. Con un mismo modelo pequeño redactando todas las respuestas de cinco sistemas, Hippocampus acertó 40 de 48, el máximo de la comparación.
En esta páginaLa prueba
La prueba
Diez documentos públicos sobre tres terapias GLP-1 para el control del peso: Saxenda y Wegovy, de Novo Nordisk, y Zepbound, de Eli Lilly. Revisiones clínicas y multidisciplinares de la FDA de 230 a 390 páginas, información de prescripción, expedientes de aprobación y el ensayo STEP 1 en el New England Journal of Medicine. La misma medida aparece en varios lugares, para distintos ensayos y momentos, así que una respuesta correcta depende del pasaje correcto, no solo del documento correcto.
Dieciséis preguntas de expertos, redactadas con un cliente: 8 fáciles (datos concretos), 4 de dificultad media (comparaciones entre documentos) y 4 difíciles (síntesis entre las terapias, más una pregunta de control que los documentos no pueden responder, en la que lo correcto es rechazarla). Cada pregunta se formuló tres veces, en conversaciones independientes.
Presentamos dos ejecuciones:
- La comparación (17 de septiembre de 2026): cinco sistemas y un único modelo de respuesta pequeño, GPT-5.4 mini, para todos ellos.
- La ejecución con modelo de frontera (del 16 al 17 de septiembre de 2026): Hippocampus con Claude Opus 5 respondiendo, el conjunto completo dos veces, más dos modelos de bajo coste.
Cómo leer las cifras
- Correctas: un modelo evaluador independiente comparó cada respuesta con la respuesta de referencia, tres votos, veredicto por mayoría. Rechazar la pregunta de control cuenta como correcto.
- Ponderada: las preguntas fáciles cuentan una vez, las medias dos y las difíciles tres.
- Acierto en todas las repeticiones: de las 16 preguntas, las respondidas correctamente en cada repetición; en el caso de Claude Opus 5, en los seis intentos de ambas ejecuciones.
- Fuente encontrada: la recuperación alcanzó al menos un documento que contiene la respuesta.
- Coste: por respuesta.
La comparación: cinco sistemas, un modelo pequeño
| Sistema | Correctas de 48 | Ponderada | Fáciles (24) | Medias (12) | Difíciles (12) |
|---|---|---|---|---|---|
| Hippocampus | 40 | 79 % | 23 | 8 | 9 |
| PageIndex | 33 | 65 % | 19 | 6 | 8 |
| OpenAI File Search, media de 2 ejecuciones | 36 | 64 % | 24 | 6,5 | 5,5 |
| Búsqueda en vector store de OpenAI | 29 | 46 % | 21 | 6 | 2 |
| Sin documentos | 15 | 25 % | 12 | 0 | 3 |
OpenAI File Search se ejecutó dos veces con la misma configuración y obtuvo 38 y 34, así que la distancia entre Hippocampus y File Search queda dentro de la variación entre ejecuciones. Las distancias con PageIndex, con el vector store y con el modelo solo son mayores.
Las consultas directas son fáciles para todos. La diferencia está en las comparaciones y la síntesis: de las 24 respuestas medias y difíciles, Hippocampus acertó 17, incluida la pregunta de control; PageIndex, 14; File Search, 12 de media (14 y 10), y el vector store, 8.
PageIndex rechazó la pregunta de control todas las veces. Hippocampus dijo cada vez que los documentos no permiten establecer una clasificación y, en dos de tres respuestas, ofreció el orden de aprobación como una aproximación señalada expresamente como tal. File Search dio una clasificación en 4 de 6 intentos; el vector store, en 1 de 3.
Respuestas correctas por dificultad, un modelo pequeño para todos los sistemas
Cada barra cuenta las respuestas correctas de 24: a la izquierda las 8 preguntas fáciles, a la derecha las 4 medias y las 4 difíciles, cada una formulada tres veces.
Preguntas fáciles, de 24
- Hippocampus 23 de 24
- PageIndex 19 de 24
- OpenAI File Search, media de 2 ejecuciones 24 de 24
- Búsqueda en OpenAI vector store 21 de 24
- Sin documentos 12 de 24
Preguntas medias y difíciles, de 24
- Hippocampus 17 de 24
- PageIndex 14 de 24
- OpenAI File Search, media de 2 ejecuciones 12 de 24
- Búsqueda en OpenAI vector store 8 de 24
- Sin documentos 3 de 24
Vista de tabla: cada recuento detrás del gráfico
| Grupo | Nombre | Valor | Nota |
|---|---|---|---|
| Preguntas fáciles, de 24 | Hippocampus | 23 de 24 | |
| Preguntas fáciles, de 24 | PageIndex | 19 de 24 | Nuestra adaptación del enfoque de búsqueda en árbol publicado |
| Preguntas fáciles, de 24 | OpenAI File Search, media de 2 ejecuciones | 24 de 24 | Media de dos ejecuciones idénticas |
| Preguntas fáciles, de 24 | Búsqueda en OpenAI vector store | 21 de 24 | |
| Preguntas fáciles, de 24 | Sin documentos | 12 de 24 | El conocimiento propio del modelo |
| Preguntas medias y difíciles, de 24 | Hippocampus | 17 de 24 | Incluye la pregunta de control |
| Preguntas medias y difíciles, de 24 | PageIndex | 14 de 24 | |
| Preguntas medias y difíciles, de 24 | OpenAI File Search, media de 2 ejecuciones | 12 de 24 | Media de dos ejecuciones: 14 y 10 |
| Preguntas medias y difíciles, de 24 | Búsqueda en OpenAI vector store | 8 de 24 | |
| Preguntas medias y difíciles, de 24 | Sin documentos | 3 de 24 |
La ejecución con modelo de frontera: la misma recuperación, tres modelos de respuesta
| Modelo de respuesta | Correctas | Acierto en todas las repeticiones | Inventadas | Fuente encontrada | Coste |
|---|---|---|---|---|---|
| Claude Opus 5, dos ejecuciones | 93 de 96 | 15 de 16 | 0 | 100 % | 0,61 $ |
| GPT-5.4 mini | 40 de 48 | 11 de 16 | 0 | 98 % | 0,12 $ |
| Claude Haiku 4.5 | 38 de 48 | 11 de 16 | 0 | 93 % | 0,09 $ |
Claude Opus 5 obtuvo 47 y 46 de 48 en dos ejecuciones separadas por unas horas, y rechazó la pregunta de control 6 de 6 veces. La diferencia de una respuesta es la medida honesta de la repetibilidad. La ejecución se configuró para la precisión, no para el ahorro: razonamiento extendido y tantas búsquedas como necesitara cada pregunta. Los modelos de bajo coste, con la misma recuperación, responden correctamente entre 38 y 40 de 48, con un coste de 0,09 $ a 0,12 $ por respuesta, y nunca inventan una respuesta.
Preguntas acertadas siempre, tres modelos de respuesta sobre Hippocampus
Cada barra cuenta las preguntas, de 16, respondidas correctamente en todas las repeticiones, con la misma recuperación de Hippocampus y un modelo de respuesta distinto.
- Claude Opus 5, dos ejecuciones 15 de 16
- GPT-5.4 mini 11 de 16
- Claude Haiku 4.5 11 de 16
Vista de tabla: cada recuento detrás del gráfico
| Nombre | Valor | Nota |
|---|---|---|
| Claude Opus 5, dos ejecuciones | 15 de 16 | Los seis intentos; 93 de 96 respuestas correctas |
| GPT-5.4 mini | 11 de 16 | Tres intentos; 40 de 48 respuestas correctas |
| Claude Haiku 4.5 | 11 de 16 | Tres intentos; 38 de 48 respuestas correctas |
El fallo
Los tres fallos de Opus provienen de una sola pregunta: qué señales de seguridad comparten las tres terapias. Para las tres se notifica un aumento de la frecuencia cardíaca, pero la FDA lo recoge en Advertencias y precauciones para Saxenda y Wegovy y en Reacciones adversas para Zepbound. Una respuesta que compara solo las listas de advertencias concluye, a partir de una premisa cierta, que la señal no es compartida. Preguntados de memoria, dos de los tres modelos de frontera se equivocaron en la ubicación, en sentidos opuestos.
Hippocampus guía ahora al modelo para que busque en los documentos de cada producto antes de afirmar que algo no aparece. Con ese cambio, Hippocampus consideró compartida la señal en 3 de 6 repeticiones; la versión anterior, en 1 de 6.
Salvedades
- Las configuraciones de Hippocampus probadas con GPT-5.4 mini el 16 y 17 de septiembre obtuvieron entre 37 y 40 de 48. La comparación muestra una ejecución que obtuvo 40, realizada ese mismo día más temprano en el servicio desplegado, por separado de los demás sistemas.
- La guía de búsqueda que Hippocampus da al modelo se afinó en ejecuciones anteriores sobre estas mismas dieciséis preguntas. Los demás sistemas se ejecutaron con los valores por defecto del proveedor más una instrucción de una frase: responder solo a partir del material.
- El modelo evaluador de la comparación es GPT-5. El modelo de respuesta y dos de los sistemas probados también son de OpenAI.
- Antes de la comparación, se corrigieron tres respuestas de referencia contrastándolas con los documentos fuente, y todos los sistemas se calificaron con el mismo conjunto corregido.
- PageIndex se ejecutó como nuestra adaptación de su método publicado de búsqueda en árbol: un paso, hasta seis secciones, 12.000 caracteres por sección. No se usaron los servicios propios de recuperación y chat de PageIndex.
- Unas 410 de las 2.198 páginas no tienen capa de texto, incluidas las 300 páginas de una revisión farmacológica de 2009. El vector store de OpenAI no contenía texto de esa revisión; Hippocampus y PageIndex leyeron las páginas escaneadas. Ningún sistema citó esa revisión, y la única pregunta que se apoya en ella también puede responderse desde una ficha técnica.
- Tres repeticiones separan el comportamiento estable del azar. No dan un intervalo de confianza.
Velocidad
Son tiempos de una respuesta completa, incluidas todas las búsquedas que el modelo decidió hacer. En la comparación, Hippocampus tardó una mediana de 20 segundos, frente a entre 5 y 8 segundos en los demás sistemas con documentos, y más de dos minutos en su 5 % más lento. Las respuestas que necesitaron una sola búsqueda tardaron unos 10 segundos; las lentas fueron comparaciones y síntesis, en las que el modelo buscó muchas veces. Con Claude Opus 5, la mediana fue de 46 segundos.
Cómo lo probamos
Todos los sistemas trabajaron con los mismos diez PDF y las mismas dieciséis preguntas. En Hippocampus, el modelo busca en la colección tantas veces como necesite, con recuperación jerárquica (patente en trámite), y cita documento, sección y página para cada afirmación. El método completo está en la página de pruebas, en la pestaña Salud.
Los documentos son públicos. Podemos cargar los mismos diez en un espacio de trabajo de Hippocampus independiente, para que hagas tus propias preguntas con el modelo que elijas. Las preguntas y las respuestas de referencia pertenecen al cliente con el que se redactaron; con su acuerdo, repasamos con las partes cualificadas cada respuesta evaluada bajo acuerdo de confidencialidad.