Investigación · 17 de septiembre de 2026
Hippocampus, OpenAI File Search y PageIndex comparados sobre 2.198 páginas de documentos de la FDA
Los mismos documentos, las mismas preguntas, el mismo modelo de respuesta. Hippocampus, OpenAI File Search y PageIndex sobre 2.198 páginas de documentos de la FDA, con GPT-5.4 mini redactando todas las respuestas. Ejecución del 17 de septiembre de 2026.
El informe completo de la FDA, con esta comparación y la ejecución con modelo de frontera, está en Hippocampus con documentos de la FDA.
En esta páginaResultado
Resultado
Dieciséis preguntas de expertos sobre diez evaluaciones públicas de la FDA, fichas técnicas y una publicación de un ensayo, cada una planteada tres veces. Todos los sistemas respondieron con el mismo modelo pequeño, así que la única diferencia entre las filas es cómo encontró cada sistema el material.
| Sistema | Correctas de 48 | Puntuación ponderada | Difíciles y medias (de 24) | Respuesta mediana |
|---|---|---|---|---|
| Hippocampus | 40 | 79 % | 17 | 20 s |
| OpenAI File Search, media de dos ejecuciones | 36 (38 y 34) | 64 % | 12 | 7 s |
| PageIndex | 33 | 65 % | 14 | 8 s |
| Vector store de OpenAI, búsqueda única | 29 | 46 % | 8 | 5 s |
| Sin documentos, solo el modelo | 15 | 25 % | 3 | 2 s |
La puntuación ponderada cuenta las preguntas fáciles una vez, las medias dos veces y las difíciles tres veces.
Hippocampus respondió correctamente 40 de 48, el mejor resultado de la comparación. OpenAI File Search obtuvo una media de 36 en dos ejecuciones idénticas, y esas dos ejecuciones se diferenciaron en cuatro respuestas, así que la distancia entre las dos primeras filas está dentro de la variación entre ejecuciones. Las distancias con PageIndex, con una búsqueda vectorial única y con el modelo solo son mayores.
Respuestas correctas de 48, un modelo pequeño para cada sistema
Cada barra cuenta las respuestas correctas de 48: dieciséis preguntas, cada una planteada tres veces.
- Hippocampus 40 de 48
- OpenAI File Search, media de dos ejecuciones 36 de 48
- PageIndex 33 de 48
- Vector store de OpenAI, búsqueda única 29 de 48
- Sin documentos, solo el modelo 15 de 48
Vista de tabla: cada recuento detrás del gráfico
| Nombre | Valor | Nota |
|---|---|---|
| Hippocampus | 40 de 48 | |
| OpenAI File Search, media de dos ejecuciones | 36 de 48 | Dos ejecuciones idénticas: 38 y 34 |
| PageIndex | 33 de 48 | Nuestra adaptación del enfoque publicado de búsqueda en árbol |
| Vector store de OpenAI, búsqueda única | 29 de 48 | |
| Sin documentos, solo el modelo | 15 de 48 |
Dónde está la diferencia
Las consultas de un solo dato son fáciles para todos. Cada sistema con acceso a los documentos obtuvo de 19 a 24 de las 24 respuestas de un solo dato, y el modelo solo acertó la mitad de memoria, ya que son documentos públicos.
La diferencia está en la comparación y la síntesis. En las 24 respuestas de dificultad media y alta, Hippocampus obtuvo 17, PageIndex 14, File Search 12 de media (14 en una ejecución, 10 en la otra) y la búsqueda vectorial única 8. Todas las respuestas que cambiaron entre las dos ejecuciones de File Search correspondían a estas preguntas.
Respuestas correctas por dificultad, un modelo pequeño para cada sistema
Cada barra cuenta las respuestas correctas de 24: a la izquierda las 8 preguntas fáciles, a la derecha las 4 de dificultad media y las 4 difíciles, cada una planteada tres veces.
Preguntas fáciles, de 24
- Hippocampus 23 de 24
- PageIndex 19 de 24
- OpenAI File Search, media de dos ejecuciones 24 de 24
- Vector store de OpenAI, búsqueda única 21 de 24
- Sin documentos, solo el modelo 12 de 24
Preguntas de dificultad media y alta, de 24
- Hippocampus 17 de 24
- PageIndex 14 de 24
- OpenAI File Search, media de dos ejecuciones 12 de 24
- Vector store de OpenAI, búsqueda única 8 de 24
- Sin documentos, solo el modelo 3 de 24
Vista de tabla: cada recuento detrás del gráfico
| Grupo | Nombre | Valor | Nota |
|---|---|---|---|
| Preguntas fáciles, de 24 | Hippocampus | 23 de 24 | |
| Preguntas fáciles, de 24 | PageIndex | 19 de 24 | Nuestra adaptación del enfoque publicado de búsqueda en árbol |
| Preguntas fáciles, de 24 | OpenAI File Search, media de dos ejecuciones | 24 de 24 | Media de dos ejecuciones idénticas |
| Preguntas fáciles, de 24 | Vector store de OpenAI, búsqueda única | 21 de 24 | |
| Preguntas fáciles, de 24 | Sin documentos, solo el modelo | 12 de 24 | El conocimiento propio del modelo |
| Preguntas de dificultad media y alta, de 24 | Hippocampus | 17 de 24 | Incluye la pregunta de control |
| Preguntas de dificultad media y alta, de 24 | PageIndex | 14 de 24 | |
| Preguntas de dificultad media y alta, de 24 | OpenAI File Search, media de dos ejecuciones | 12 de 24 | Media de dos ejecuciones: 14 y 10 |
| Preguntas de dificultad media y alta, de 24 | Vector store de OpenAI, búsqueda única | 8 de 24 | |
| Preguntas de dificultad media y alta, de 24 | Sin documentos, solo el modelo | 3 de 24 |
La pregunta sin respuesta
Una pregunta pide una clasificación que los documentos no pueden respaldar: qué terapia se enfrentará primero a la competencia de genéricos. La respuesta correcta es declinar. PageIndex declinó todas las veces. Hippocampus dijo cada vez que los documentos no permiten una clasificación real y, en dos de tres respuestas, ofreció el orden de aprobación como aproximación indicada de forma explícita. File Search dio una clasificación como respuesta en cuatro de seis intentos.
Páginas escaneadas
Unas 410 de las 2.198 páginas no tienen capa de texto, entre ellas las 300 páginas de una revisión de farmacología de 2009. El vector store de OpenAI no contenía texto de esa revisión. Hippocampus y PageIndex leen ambos las páginas escaneadas durante la ingesta. Ningún sistema llegó a citar esa revisión, y la única pregunta que se apoya en ella también se puede responder a partir de una ficha técnica.
Velocidad
Hippocampus es aquí el sistema más lento: una mediana de 20 segundos por respuesta frente a 5 a 8 en los demás, y más de dos minutos en su 5 % más lento. Las respuestas con una sola búsqueda tardaron unos 10 segundos. Las lentas eran preguntas de comparación y síntesis, en las que el modelo buscó muchas veces y leyó más de la fuente antes de responder. Son tiempos de una respuesta completa, con el modelo buscando tantas veces como necesita. Una sola búsqueda de Hippocampus tarda 1,8 segundos de mediana en nuestro informe de benchmark posterior.
Por qué un modelo pequeño
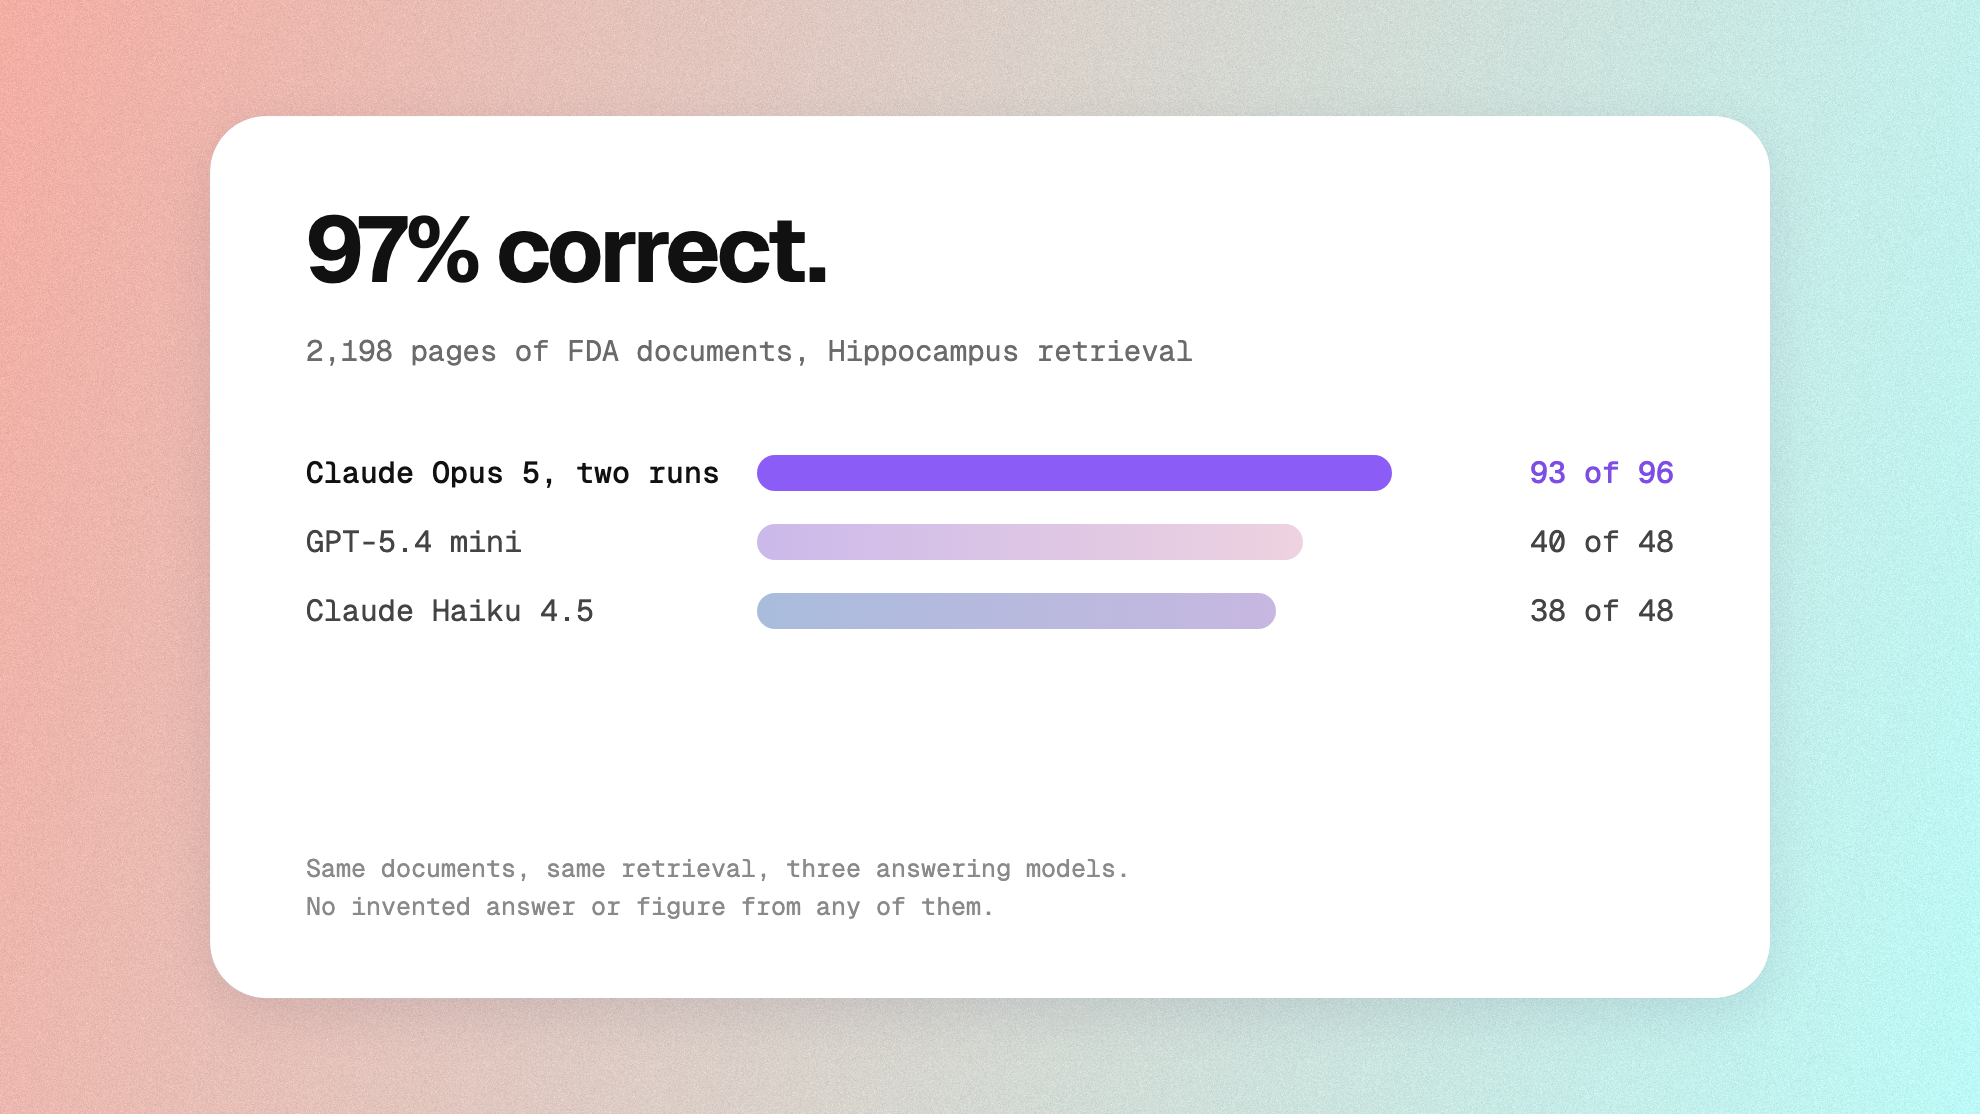
OpenAI File Search solo funciona con modelos de OpenAI. Para mantener fijo el modelo de respuesta en todos los sistemas, todos usaron GPT-5.4 mini. Hippocampus no está atado a un modelo: con Claude Opus 5 respondiendo, la misma configuración obtuvo 93 de 96 en este conjunto de preguntas. Los demás sistemas no se ejecutaron con Opus, así que esa cifra no es una comparación. Está en marcha una comparación con un modelo puntero de OpenAI respondiendo en todos los sistemas.
Lo que esta comparación no muestra
- Las configuraciones de Hippocampus probadas con estas preguntas el 16 y el 17 de septiembre obtuvieron entre 37 y 40 de 48. La tabla muestra una ejecución que obtuvo 40, hecha antes ese mismo día en el servicio desplegado, por separado de los demás sistemas.
- La guía de búsqueda que Hippocampus da al modelo se afinó en ejecuciones anteriores con estas mismas dieciséis preguntas. Los demás sistemas se ejecutaron con la configuración por defecto de cada proveedor más una instrucción de una frase para responder solo a partir del material.
- El modelo evaluador es GPT-5, tres votos, veredicto por mayoría. El modelo de respuesta y dos de los sistemas probados también son de OpenAI.
- Nuestra configuración de PageIndex es una adaptación de su enfoque publicado de búsqueda en árbol: un paso, hasta seis secciones, 12.000 caracteres por sección. No se usaron los servicios propios de recuperación y chat de PageIndex. Esos límites pueden perjudicar a las respuestas repartidas en muchas secciones o situadas en tablas largas.
- File Search se ejecutó dos veces. Los demás sistemas se ejecutaron una vez, así que diferencias de unas pocas respuestas pueden deberse solo a la variación.
Preguntas y respuestas
Los documentos son públicos. El conjunto de preguntas y las respuestas de referencia pertenecen al cliente con el que se redactaron; con su acuerdo, repasamos cada respuesta evaluada con las partes cualificadas bajo NDA.
*Ejecuciones comparativas del 17 de septiembre de 2026. 16 preguntas, tres intentos cada una, sobre 10 documentos públicos de la FDA (2.198 páginas). Modelo de respuesta GPT-5.4 mini para cada sistema. Evaluación con GPT-5, tres votos, veredicto por mayoría, en una evaluación diseñada y realizada por Thalius. Se conservan los registros de cada respuesta.