Forschung · 17. September 2026
Hippocampus, OpenAI File Search und PageIndex im Vergleich auf 2.198 Seiten FDA-Dokumenten
Dieselben Dokumente, dieselben Fragen, dasselbe Antwortmodell. Hippocampus, OpenAI File Search und PageIndex auf 2.198 Seiten FDA-Dokumenten, mit GPT-5.4 mini als Verfasser jeder Antwort. Durchlauf am 17. September 2026.
Der vollständige FDA-Bericht, mit diesem Vergleich und dem Durchlauf mit dem Frontier-Modell, steht in Hippocampus mit FDA-Dokumenten.
Auf dieser SeiteErgebnis
Ergebnis
Sechzehn Expertenfragen zu zehn öffentlichen FDA-Bewertungen, Fachinformationen und einer Studienpublikation, jede dreimal gestellt. Jedes System antwortete über dasselbe kleine Modell, sodass sich die Zeilen nur darin unterscheiden, wie jedes System das Material gefunden hat.
| System | Korrekt von 48 | Gewichtete Punktzahl | Schwer und mittel (von 24) | Mediane Antwortzeit |
|---|---|---|---|---|
| Hippocampus | 40 | 79 % | 17 | 20 s |
| OpenAI File Search, Durchschnitt aus zwei Durchläufen | 36 (38 und 34) | 64 % | 12 | 7 s |
| PageIndex | 33 | 65 % | 14 | 8 s |
| OpenAI Vector Store, einzelne Suche | 29 | 46 % | 8 | 5 s |
| Keine Dokumente, nur das Modell | 15 | 25 % | 3 | 2 s |
Die gewichtete Punktzahl zählt leichte Fragen einfach, mittlere doppelt und schwere dreifach.
Hippocampus beantwortete 40 von 48 richtig, die meisten im Vergleich. OpenAI File Search kam über zwei identische Durchläufe im Durchschnitt auf 36, und diese beiden Durchläufe unterschieden sich um vier Antworten; der Abstand zwischen den beiden obersten Zeilen liegt also innerhalb der Schwankung zwischen Durchläufen. Die Abstände zu PageIndex, zu einer einzelnen Vektorsuche und zum Modell allein sind größer.
Korrekte Antworten von 48, ein kleines Modell für jedes System
Jeder Balken zählt die korrekten Antworten von 48: sechzehn Fragen, jede dreimal gestellt.
- Hippocampus 40 von 48
- OpenAI File Search, Durchschnitt aus zwei Durchläufen 36 von 48
- PageIndex 33 von 48
- OpenAI Vector Store, einzelne Suche 29 von 48
- Keine Dokumente, nur das Modell 15 von 48
Tabellenansicht: jede Zahl hinter dem Diagramm
| Name | Wert | Hinweis |
|---|---|---|
| Hippocampus | 40 von 48 | |
| OpenAI File Search, Durchschnitt aus zwei Durchläufen | 36 von 48 | Zwei identische Durchläufe: 38 und 34 |
| PageIndex | 33 von 48 | Unsere Adaption des veröffentlichten Baumsuche-Ansatzes |
| OpenAI Vector Store, einzelne Suche | 29 von 48 | |
| Keine Dokumente, nur das Modell | 15 von 48 |
Wo der Unterschied liegt
Nachschlagefragen sind für alle leicht. Jedes System mit Dokumentenzugriff kam bei den 24 Antworten auf Einzelfakten auf 19 bis 24, und das Modell allein beantwortete die Hälfte aus dem Gedächtnis, da es sich um öffentliche Dokumente handelt.
Der Unterschied zeigt sich bei Vergleich und Synthese. Bei den 24 mittleren und schweren Antworten erreichte Hippocampus 17, PageIndex 14, File Search im Durchschnitt 12 (14 im einen Durchlauf, 10 im anderen) und die einzelne Vektorsuche 8. Jede Antwort, die sich zwischen den beiden Durchläufen von File Search änderte, betraf eine dieser Fragen.
Korrekte Antworten nach Schwierigkeit, ein kleines Modell für jedes System
Jeder Balken zählt die korrekten Antworten von 24: links die 8 leichten Fragen, rechts die 4 mittleren und 4 schweren Fragen, jede dreimal gestellt.
Leichte Fragen, von 24
- Hippocampus 23 von 24
- PageIndex 19 von 24
- OpenAI File Search, Durchschnitt aus zwei Durchläufen 24 von 24
- OpenAI Vector Store, einzelne Suche 21 von 24
- Keine Dokumente, nur das Modell 12 von 24
Mittlere und schwere Fragen, von 24
- Hippocampus 17 von 24
- PageIndex 14 von 24
- OpenAI File Search, Durchschnitt aus zwei Durchläufen 12 von 24
- OpenAI Vector Store, einzelne Suche 8 von 24
- Keine Dokumente, nur das Modell 3 von 24
Tabellenansicht: jede Zahl hinter dem Diagramm
| Gruppe | Name | Wert | Hinweis |
|---|---|---|---|
| Leichte Fragen, von 24 | Hippocampus | 23 von 24 | |
| Leichte Fragen, von 24 | PageIndex | 19 von 24 | Unsere Adaption des veröffentlichten Baumsuche-Ansatzes |
| Leichte Fragen, von 24 | OpenAI File Search, Durchschnitt aus zwei Durchläufen | 24 von 24 | Durchschnitt aus zwei identischen Durchläufen |
| Leichte Fragen, von 24 | OpenAI Vector Store, einzelne Suche | 21 von 24 | |
| Leichte Fragen, von 24 | Keine Dokumente, nur das Modell | 12 von 24 | Das eigene Wissen des Modells |
| Mittlere und schwere Fragen, von 24 | Hippocampus | 17 von 24 | Einschließlich der Kontrollfrage |
| Mittlere und schwere Fragen, von 24 | PageIndex | 14 von 24 | |
| Mittlere und schwere Fragen, von 24 | OpenAI File Search, Durchschnitt aus zwei Durchläufen | 12 von 24 | Durchschnitt aus zwei Durchläufen: 14 und 10 |
| Mittlere und schwere Fragen, von 24 | OpenAI Vector Store, einzelne Suche | 8 von 24 | |
| Mittlere und schwere Fragen, von 24 | Keine Dokumente, nur das Modell | 3 von 24 |
Die Frage ohne Antwort
Eine Frage verlangt eine Rangfolge, die die Dokumente nicht stützen können: welche Therapie zuerst Generika-Konkurrenz bekommt. Die richtige Antwort ist, das abzulehnen. PageIndex lehnte jedes Mal ab. Hippocampus sagte jedes Mal, dass die Dokumente keine echte Rangfolge stützen, und bot in zwei von drei Antworten die Reihenfolge der Zulassungen als ausdrücklich gekennzeichneten Ersatzwert an. File Search gab in vier von sechs Versuchen eine Rangfolge als Antwort.
Gescannte Seiten
Etwa 410 der 2.198 Seiten haben keine Textebene, darunter alle 300 Seiten eines pharmakologischen Reviews von 2009. Der Vector Store von OpenAI enthielt keinen Text aus diesem Review. Hippocampus und PageIndex lesen beide gescannte Seiten beim Import. Kein System zitierte am Ende dieses Review, und die eine Frage, die darauf zurückgreift, lässt sich auch aus einer Fachinformation beantworten.
Geschwindigkeit
Hippocampus ist hier das langsamste System: im Median 20 Sekunden pro Antwort gegenüber 5 bis 8 bei den anderen, und über zwei Minuten für seine langsamsten 5 %. Antworten mit einer einzelnen Suche dauerten etwa 10 Sekunden. Langsam waren die Vergleichs- und Synthesefragen, bei denen das Modell viele Male suchte und mehr von der Quelle las, bevor es antwortete. Das sind Zeiten für eine ganze Antwort, bei der das Modell so oft sucht, wie es nötig ist. Eine einzelne Hippocampus-Suche dauert in unserem späteren Benchmark-Bericht im Median 1,8 Sekunden.
Warum ein kleines Modell
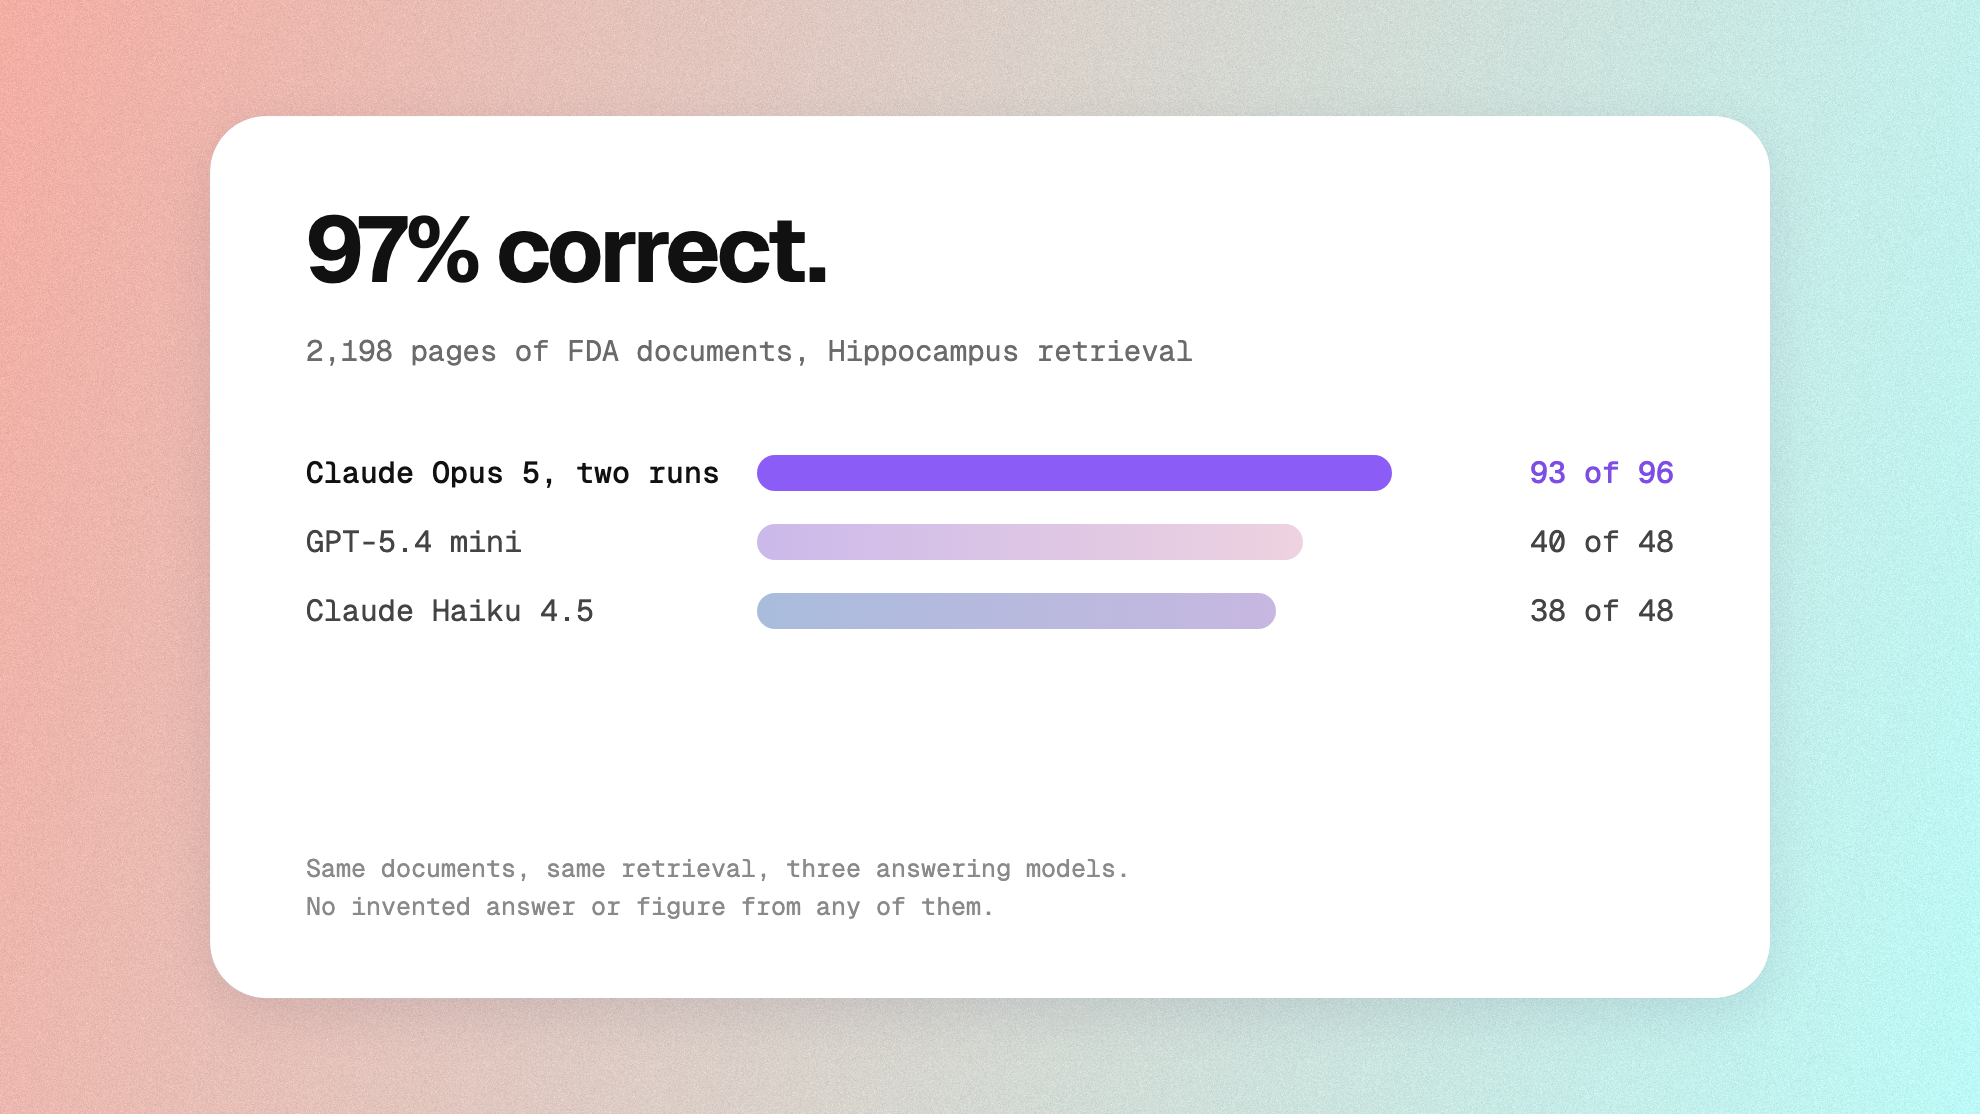
OpenAI File Search funktioniert nur mit OpenAI-Modellen. Um das Antwortmodell über alle Systeme gleich zu halten, nutzten alle GPT-5.4 mini. Hippocampus ist an kein Modell gebunden: Mit Claude Opus 5 als Antwortmodell erreichte dieselbe Konfiguration auf diesem Fragensatz 93 von 96. Die anderen Systeme liefen nicht mit Opus, daher ist diese Zahl kein Vergleich. Ein Vergleich mit einem OpenAI-Spitzenmodell als Antwortmodell für jedes System läuft.
Was dieser Vergleich nicht zeigt
- Hippocampus-Konfigurationen, die am 16. und 17. September mit diesen Fragen getestet wurden, erreichten zwischen 37 und 40 von 48. Die Tabelle zeigt einen Durchlauf mit 40, früher am selben Tag auf dem produktiven Dienst gemacht, getrennt von den anderen Systemen.
- Der Suchleitfaden, den Hippocampus dem Modell mitgibt, wurde in früheren Durchläufen mit denselben sechzehn Fragen verfeinert. Die anderen Systeme liefen mit den Voreinstellungen der Anbieter plus einer Anweisung in einem Satz, nur aus dem Material zu antworten.
- Das Bewertungsmodell ist GPT-5, drei Stimmen, Mehrheitsentscheid. Das Antwortmodell und zwei der getesteten Systeme stammen ebenfalls von OpenAI.
- Unser PageIndex-Setup ist eine Adaption ihres veröffentlichten Baumsuche-Ansatzes: ein Schritt, bis zu sechs Abschnitte, 12.000 Zeichen pro Abschnitt. Die eigenen Retrieval- und Chat-Dienste von PageIndex wurden nicht genutzt. Diese Grenzen können Antworten benachteiligen, die über viele Abschnitte verteilt sind oder in langen Tabellen stehen.
- File Search lief zweimal. Die anderen Systeme liefen einmal, daher können Unterschiede von wenigen Antworten allein aus der Schwankung kommen.
Fragen und Antworten
Die Dokumente sind öffentlich. Der Fragensatz und die Referenzantworten gehören dem Kunden, mit dem sie geschrieben wurden; mit seinem Einverständnis gehen wir mit qualifizierten Parteien unter NDA jede bewertete Antwort durch.
*Vergleichsläufe vom 17. September 2026. 16 Fragen, je drei Versuche, über 10 öffentliche FDA-Dokumente (2.198 Seiten). Antwortmodell GPT-5.4 mini für jedes System. Bewertung durch GPT-5, drei Stimmen, Mehrheitsentscheid, in einer von Thalius konzipierten und durchgeführten Evaluierung. Aufzeichnungen zu jeder Antwort werden aufbewahrt.