Recherche · 17 septembre 2026
Hippocampus, OpenAI File Search et PageIndex comparés sur 2 198 pages de documents de la FDA
Mêmes documents, mêmes questions, même modèle de réponse. Hippocampus, OpenAI File Search et PageIndex sur 2 198 pages de documents de la FDA, GPT-5.4 mini rédigeant chaque réponse. Exécution du 17 septembre 2026.
Le rapport FDA complet, avec cette comparaison et l'exécution avec le modèle de pointe, se trouve dans Hippocampus sur des documents de la FDA.
Sur cette pageRésultat
Résultat
Seize questions d'experts portant sur dix évaluations publiques de la FDA, des notices et une publication d'essai clinique, chacune posée trois fois. Chaque système a répondu avec le même petit modèle, de sorte que la seule différence entre les lignes est la manière dont chaque système a trouvé le contenu.
| Système | Bonnes réponses sur 48 | Score pondéré | Difficiles et moyennes (sur 24) | Réponse médiane |
|---|---|---|---|---|
| Hippocampus | 40 | 79 % | 17 | 20 s |
| OpenAI File Search, moyenne de deux exécutions | 36 (38 et 34) | 64 % | 12 | 7 s |
| PageIndex | 33 | 65 % | 14 | 8 s |
| OpenAI vector store, recherche unique | 29 | 46 % | 8 | 5 s |
| Sans documents, le modèle seul | 15 | 25 % | 3 | 2 s |
Le score pondéré compte une fois les questions faciles, deux fois les moyennes et trois fois les difficiles.
Hippocampus a répondu correctement à 40 questions sur 48, le meilleur résultat de la comparaison. OpenAI File Search a obtenu 36 en moyenne sur deux exécutions identiques, et ces deux exécutions différaient de quatre réponses ; l'écart entre les deux premières lignes reste donc dans la variation d'une exécution à l'autre. Les écarts avec PageIndex, avec une recherche vectorielle unique et avec le modèle seul sont plus importants.
Bonnes réponses sur 48, un petit modèle pour chaque système
Chaque barre compte les bonnes réponses sur 48 : seize questions, chacune posée trois fois.
- Hippocampus 40 sur 48
- OpenAI File Search, moyenne de deux exécutions 36 sur 48
- PageIndex 33 sur 48
- OpenAI vector store, recherche unique 29 sur 48
- Sans documents, le modèle seul 15 sur 48
Vue tableau : chaque décompte derrière le graphique
| Nom | Valeur | Remarque |
|---|---|---|
| Hippocampus | 40 sur 48 | |
| OpenAI File Search, moyenne de deux exécutions | 36 sur 48 | Deux exécutions identiques : 38 et 34 |
| PageIndex | 33 sur 48 | Notre adaptation de l'approche publiée de recherche arborescente |
| OpenAI vector store, recherche unique | 29 sur 48 | |
| Sans documents, le modèle seul | 15 sur 48 |
Où se situe la différence
Les recherches ponctuelles sont faciles pour tout le monde. Chaque système ayant accès aux documents a obtenu de 19 à 24 des 24 réponses portant sur un fait unique, et le modèle seul en a trouvé la moitié de mémoire, puisqu'il s'agit de documents publics.
L'écart se creuse sur la comparaison et la synthèse. Sur les 24 réponses moyennes et difficiles, Hippocampus a obtenu 17, PageIndex 14, File Search 12 en moyenne (14 dans une exécution, 10 dans l'autre) et la recherche vectorielle unique 8. Chaque réponse qui a changé entre les deux exécutions de File Search portait sur l'une de ces questions.
Bonnes réponses par difficulté, un petit modèle pour chaque système
Chaque barre compte les bonnes réponses sur 24 : à gauche les 8 questions faciles, à droite les 4 questions moyennes et les 4 difficiles, chacune posée trois fois.
Questions faciles, sur 24
- Hippocampus 23 sur 24
- PageIndex 19 sur 24
- OpenAI File Search, moyenne de deux exécutions 24 sur 24
- OpenAI vector store, recherche unique 21 sur 24
- Sans documents, le modèle seul 12 sur 24
Questions moyennes et difficiles, sur 24
- Hippocampus 17 sur 24
- PageIndex 14 sur 24
- OpenAI File Search, moyenne de deux exécutions 12 sur 24
- OpenAI vector store, recherche unique 8 sur 24
- Sans documents, le modèle seul 3 sur 24
Vue tableau : chaque décompte derrière le graphique
| Groupe | Nom | Valeur | Remarque |
|---|---|---|---|
| Questions faciles, sur 24 | Hippocampus | 23 sur 24 | |
| Questions faciles, sur 24 | PageIndex | 19 sur 24 | Notre adaptation de l'approche publiée de recherche arborescente |
| Questions faciles, sur 24 | OpenAI File Search, moyenne de deux exécutions | 24 sur 24 | Moyenne de deux exécutions identiques |
| Questions faciles, sur 24 | OpenAI vector store, recherche unique | 21 sur 24 | |
| Questions faciles, sur 24 | Sans documents, le modèle seul | 12 sur 24 | Les connaissances propres du modèle |
| Questions moyennes et difficiles, sur 24 | Hippocampus | 17 sur 24 | Y compris la question de contrôle |
| Questions moyennes et difficiles, sur 24 | PageIndex | 14 sur 24 | |
| Questions moyennes et difficiles, sur 24 | OpenAI File Search, moyenne de deux exécutions | 12 sur 24 | Moyenne de deux exécutions : 14 et 10 |
| Questions moyennes et difficiles, sur 24 | OpenAI vector store, recherche unique | 8 sur 24 | |
| Questions moyennes et difficiles, sur 24 | Sans documents, le modèle seul | 3 sur 24 |
La question sans réponse
Une question demande un classement que les documents ne permettent pas d'établir : quelle thérapie sera la première confrontée à la concurrence des génériques. La bonne réponse consiste à décliner. PageIndex a décliné à chaque fois. Hippocampus a indiqué à chaque fois que les documents ne permettent pas un véritable classement et, dans deux réponses sur trois, a proposé l'ordre des autorisations comme indicateur de substitution explicitement signalé. File Search a donné un classement comme réponse dans quatre tentatives sur six.
Pages numérisées
Environ 410 des 2 198 pages n'ont pas de couche texte, dont les 300 pages d'une revue de pharmacologie de 2009. Le vector store d'OpenAI ne contenait aucun texte de cette revue. Hippocampus et PageIndex lisent tous deux les pages numérisées à l'ingestion. Aucun système n'a fini par citer cette revue, et la seule question qui s'y rapporte peut aussi trouver sa réponse dans une notice.
Vitesse
Hippocampus est ici le système le plus lent : une médiane de 20 secondes par réponse contre 5 à 8 pour les autres, et plus de deux minutes pour ses 5 % les plus lentes. Les réponses à recherche unique ont pris environ 10 secondes. Les plus lentes portaient sur la comparaison et la synthèse, où le modèle a cherché de nombreuses fois et lu davantage de la source avant de répondre. Ce sont des temps pour une réponse complète, le modèle cherchant aussi souvent que nécessaire. Une seule recherche Hippocampus prend 1,8 seconde en médiane dans notre rapport de benchmark ultérieur.
Pourquoi un petit modèle
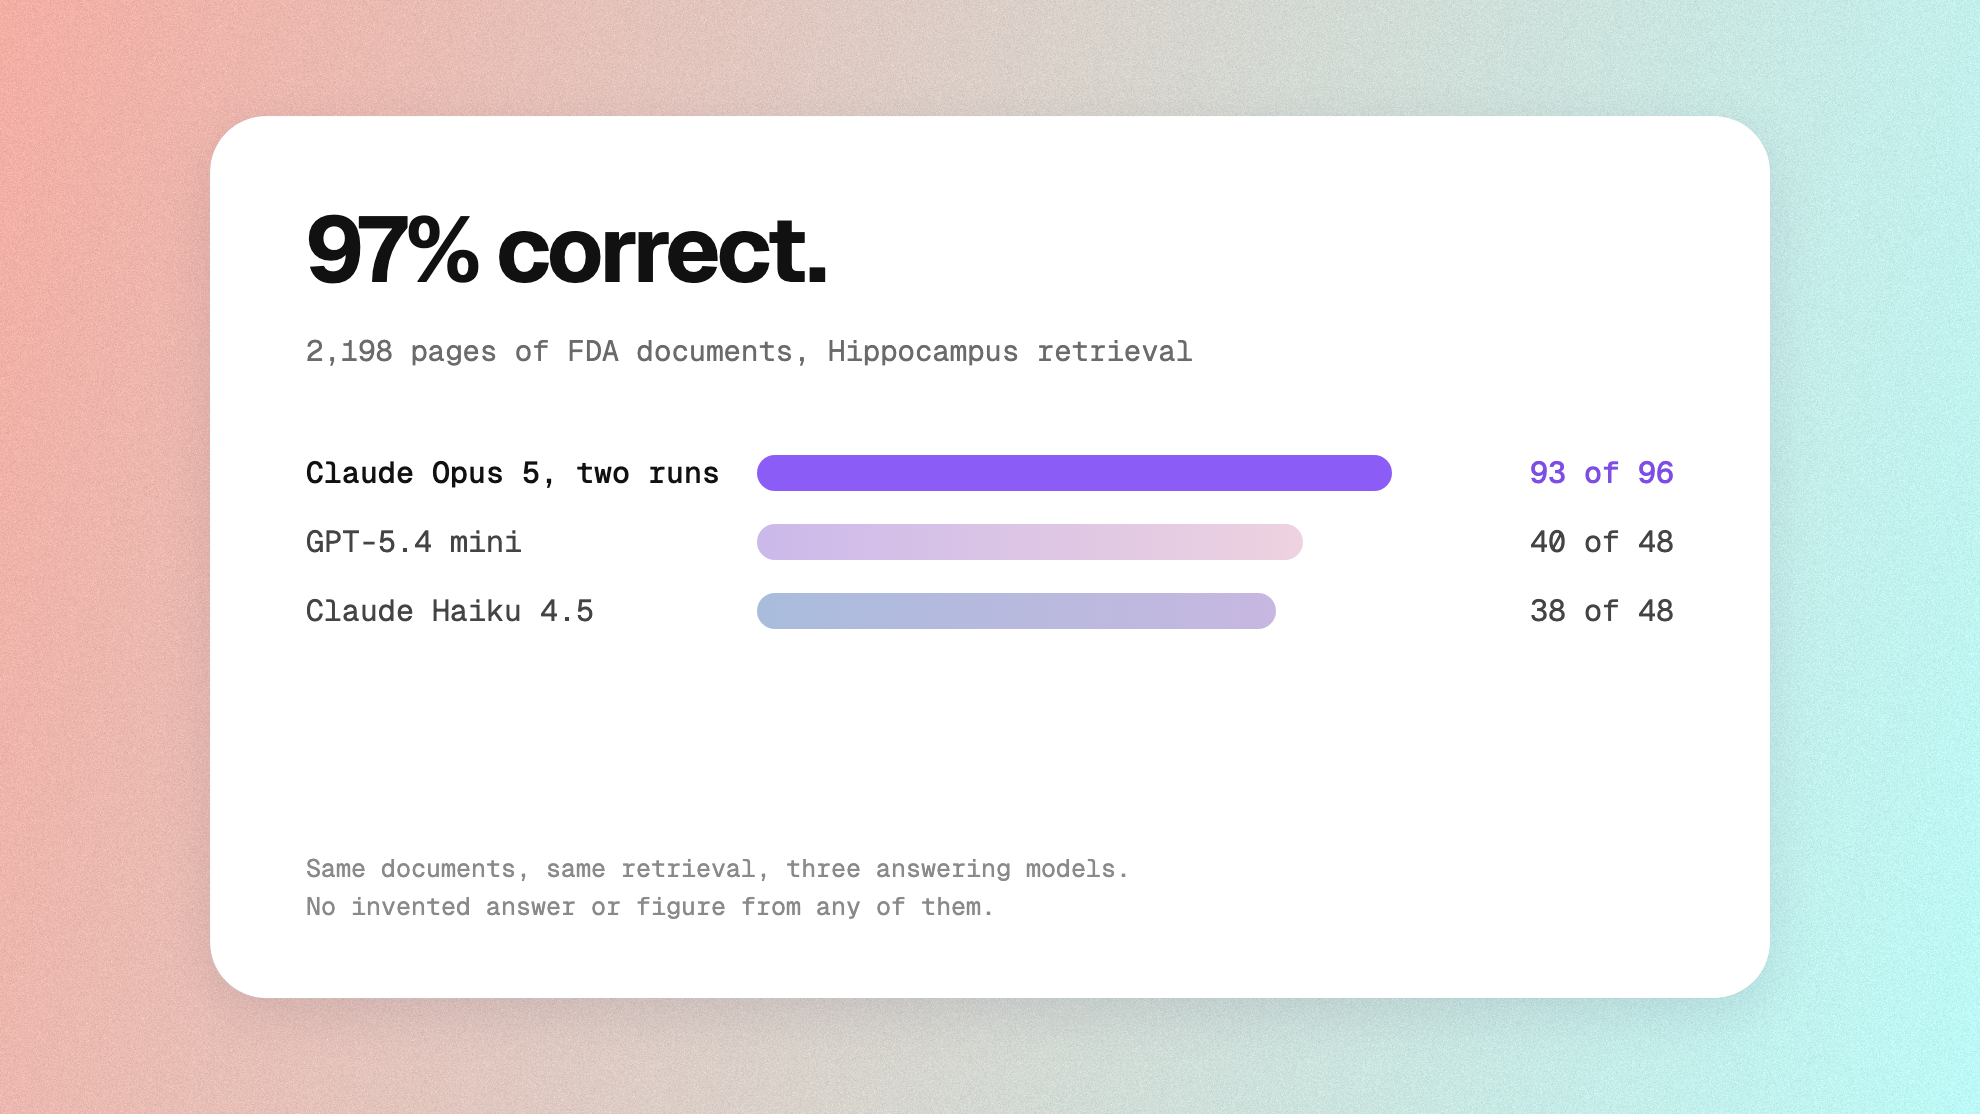
OpenAI File Search ne fonctionne qu'avec les modèles d'OpenAI. Pour garder le même modèle de réponse pour tous les systèmes, tous ont utilisé GPT-5.4 mini. Hippocampus n'est lié à aucun modèle : avec Claude Opus 5 pour répondre, la même configuration a obtenu 93 sur 96 sur ce jeu de questions. Les autres systèmes n'ont pas été exécutés avec Opus, ce chiffre n'est donc pas une comparaison. Une comparaison avec un modèle OpenAI de pointe répondant pour chaque système est en cours.
Ce que cette comparaison ne montre pas
- Les configurations de Hippocampus testées sur ces questions les 16 et 17 septembre ont obtenu entre 37 et 40 sur 48. Le tableau montre une exécution qui a obtenu 40, réalisée plus tôt le même jour sur le service déployé, séparément des autres systèmes.
- Le guide de recherche que Hippocampus fournit au modèle a été affiné lors d'exécutions antérieures sur ces mêmes seize questions. Les autres systèmes ont tourné avec les réglages par défaut des fournisseurs, plus une consigne d'une phrase demandant de ne répondre qu'à partir du contenu.
- Le modèle d'évaluation est GPT-5, trois votes, verdict à la majorité. Le modèle de réponse et deux des systèmes testés viennent aussi d'OpenAI.
- Notre configuration PageIndex est une adaptation de leur approche publiée de recherche arborescente : une étape, jusqu'à six sections, 12 000 caractères par section. Les services de récupération et de chat propres à PageIndex n'ont pas été utilisés. Ces limites peuvent désavantager les réponses réparties sur de nombreuses sections ou situées dans de longs tableaux.
- File Search a tourné deux fois. Les autres systèmes ont tourné une fois, donc des écarts de quelques réponses peuvent venir de la seule variation.
Questions et réponses
Les documents sont publics. Le jeu de questions et les réponses de référence appartiennent au client avec lequel ils ont été rédigés ; avec son accord, nous présentons chaque réponse évaluée aux parties qualifiées sous NDA.
*Exécutions comparatives du 17 septembre 2026. 16 questions, trois tentatives chacune, sur 10 documents publics de la FDA (2 198 pages). Modèle de réponse GPT-5.4 mini pour chaque système. Évaluation par GPT-5, trois votes, verdict à la majorité, dans une évaluation conçue et menée par Thalius. Les enregistrements de chaque réponse sont conservés.