Comparatif · 18 octobre 2026
Hippocampus vs OpenAI File Search, comparés sur dix critères
Hippocampus est le meilleur choix lorsque chaque réponse doit pouvoir être vérifiée sur une page et que les personnes et les agents ne doivent voir que ce qu'ils sont autorisés à lire. OpenAI File Search est le meilleur choix si vous développez déjà sur la Responses API d'OpenAI, si vous voulez la récupération comme un outil hébergé de plus, si vous voulez régler vous-même la recherche hybride ou s'il vous faut des réponses rapides. Sur notre benchmark FDA, avec GPT-5.4 mini répondant pour les deux, Hippocampus a répondu correctement à 40 questions sur 48 et File Search à 36 sur 48*, un écart qui se situe dans la variation d'une exécution à l'autre. File Search était plus rapide : une médiane de 7 secondes par réponse contre 20 pour Hippocampus.
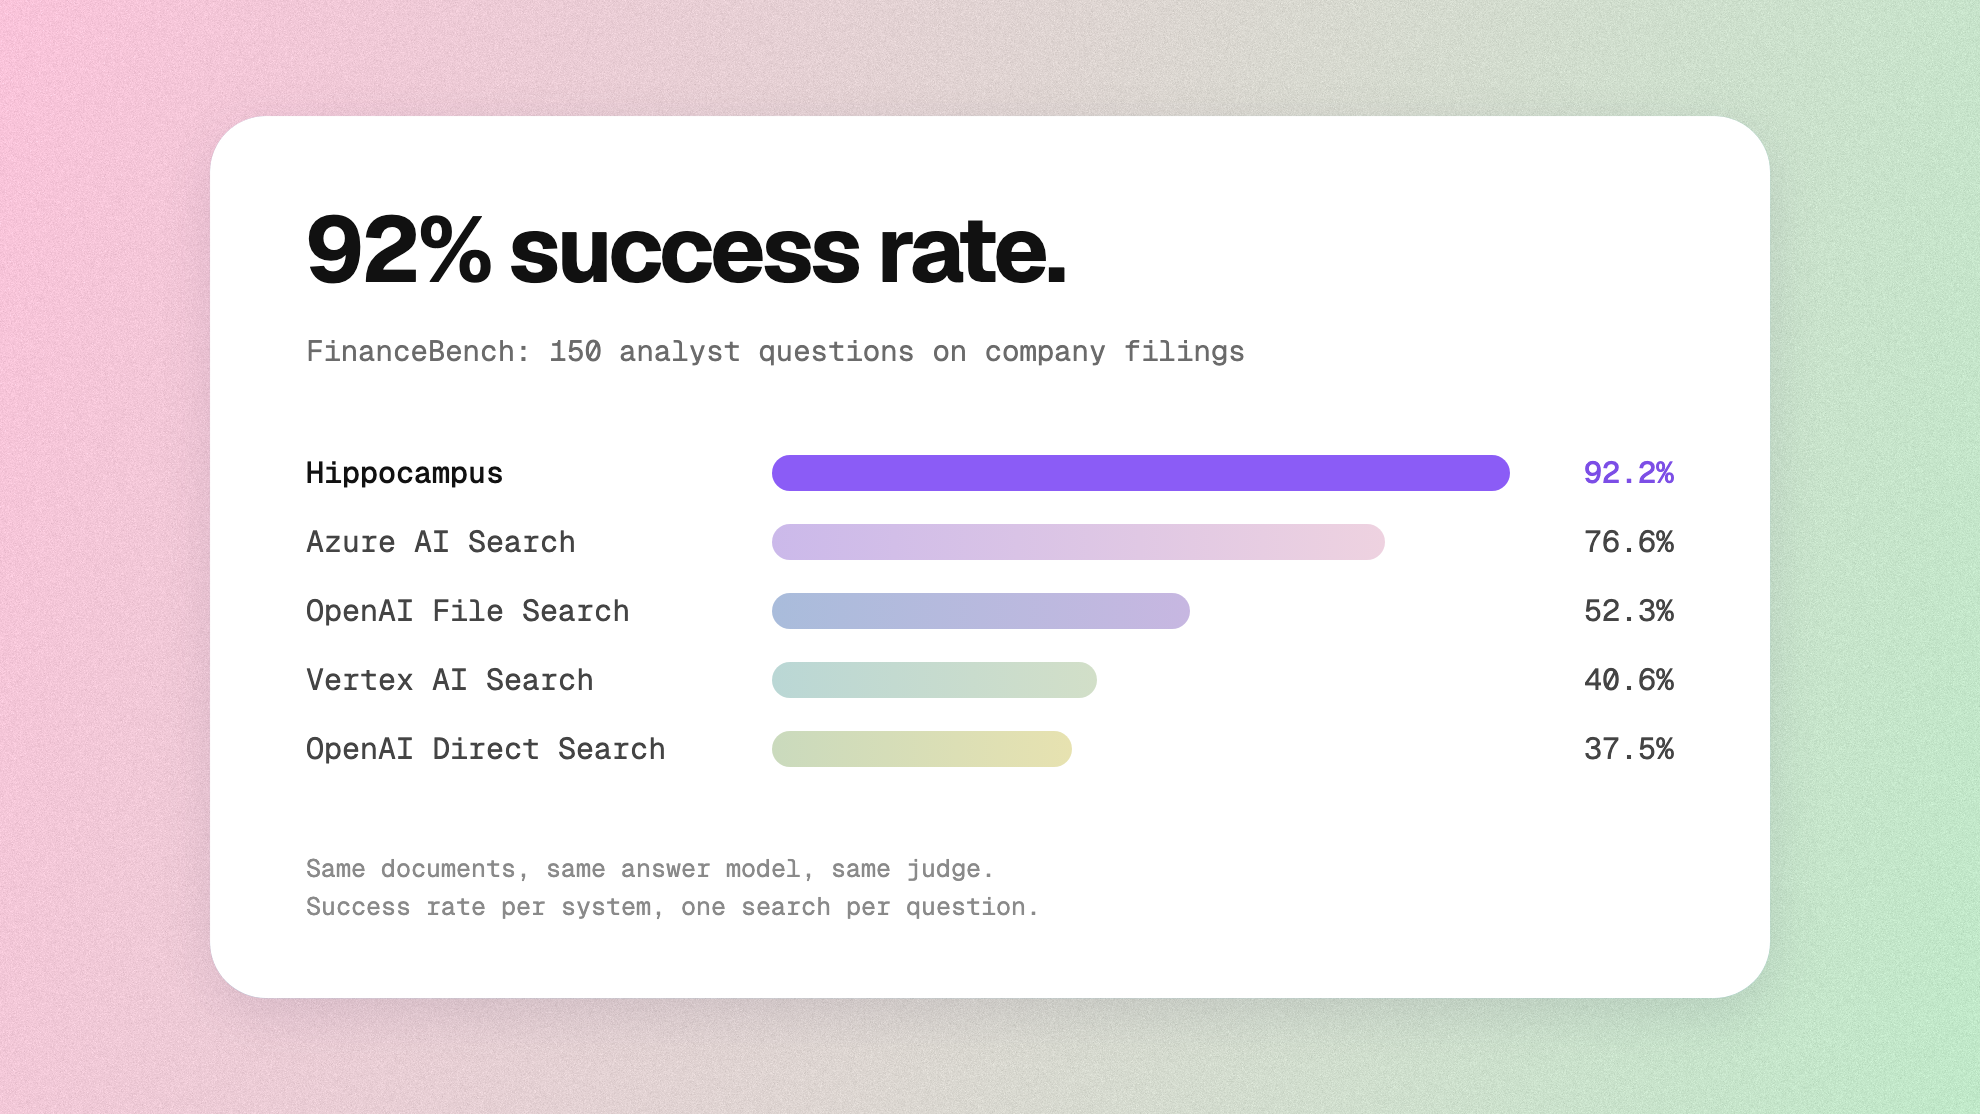
Cet article compare les deux produits, critère par critère. L'exécution du benchmark elle-même, avec cinq systèmes côte à côte et les questions sur lesquelles ils diffèrent, fait l'objet de notre article précédent Hippocampus face à OpenAI File Search et PageIndex ; cet article ne la reprend pas. Nous comparons aussi Hippocampus vs PageIndex et Hippocampus vs Vertex AI Search.
Sur cette pageSynthèse
Synthèse
| Critère | Hippocampus | OpenAI File Search |
|---|---|---|
| Région d'hébergement et auto-hébergement | Les documents et la structure de connaissances sont stockés dans l'UE (Finlande), chiffrés. L'inférence des modèles s'exécute par défaut aux États-Unis ; sur Corporate, elle peut être hébergée dans l'UE ou s'exécuter dans votre propre environnement. L'hébergement dans votre propre cloud ou sur site fait partie de l'offre Enterprise. Sécurité | La résidence des données se règle par projet, avec un stockage régional aux États-Unis, en Europe et dans huit autres régions. Les vector stores n'ont pas de traitement régional ; File Search dans la Responses API dispose d'un traitement régional aux États-Unis et en Europe uniquement. Les régions hors États-Unis nécessitent une approbation. Auto-hébergement : non documenté. Vos données (vérifié en octobre 2026) |
| Attribution des sources (citation au niveau de la page) | Chaque réponse indique le document, le chemin de section, les pages de début et de fin, les décalages d'octets et le texte utilisé. Les citations proviennent de l'étape de récupération, pas du modèle. | Les réponses portent des annotations file_citation avec l'identifiant du fichier, le nom du fichier et un index de caractère. Citation au niveau de la page : non documentée. Guide File Search (vérifié en octobre 2026) |
| Application des permissions au moment de la requête | Appliquées au sein même de la recherche, comme filtre avant le classement ; la recherche ne renvoie rien si les permissions ne peuvent pas être vérifiées. Un résumé portant sur plusieurs documents n'est visible que par les personnes qui peuvent tous les lire. Les agents obéissent aux mêmes permissions. Sécurité | Contrôle d'accès par utilisateur : non documenté. L'appelant peut restreindre les fichiers recherchés avec des attributs de fichier et des filtres de métadonnées. Guide Retrieval (vérifié en octobre 2026) |
| Comportement face aux questions sans réponse | Lorsque la récupération ne renvoie rien, la question est refusée, pas devinée. Un refus coûte les mêmes crédits qu'une réponse. | Comportement de refus : non documenté. Un seuil de score et une limite de résultats réduisent les fragments renvoyés. Guide File Search, Guide Retrieval (vérifié en octobre 2026) |
| Architecture de récupération (mémoire structurée, index vectoriel ou recherche de fichiers) | Mémoire structurée construite à l'import : un arbre par document avec un résumé d'index, des résumés de sections et des sections feuilles avec pages et plages d'octets. Deux entonnoirs, descendant sur les résumés et ascendant par recherche par mots-clés et par embeddings sur les sections feuilles, fusionnés en un seul classement. Développeurs | Vector store : les fichiers sont découpés en fragments (800 tokens avec 400 de chevauchement par défaut), vectorisés et indexés au chargement. Recherche sémantique avec réécriture de requête optionnelle et recherche hybride pondérée par mots-clés, jusqu'à 50 résultats. Guide Retrieval (vérifié en octobre 2026) |
| Modèles de réponse pris en charge | N'importe quel modèle de langage. Vous choisissez quel modèle répond, réglé par espace de travail ; sur Corporate, vous pouvez utiliser votre propre clé de modèle ou laisser les administrateurs choisir les modèles. Développeurs | S'exécute comme outil dans la Responses API d'OpenAI. Liste des modèles pris en charge : non documentée. Guide File Search (vérifié en octobre 2026) |
| Disponibilité de l'API et du MCP | Un serveur MCP avec connexion OAuth dans le navigateur, et une API REST en accès anticipé. Développeurs | Configuré comme outil dans la Responses API. La Responses API peut appeler des serveurs MCP distants ; File Search en tant que serveur MCP hébergé : non documenté. Guide File Search, Guide MCP (vérifié en octobre 2026) |
| Format d'export des données | Open Knowledge Format : un dossier par document, en Markdown avec en-tête YAML (front matter), contenant le résumé d'index, le texte intégral, le fichier d'origine et un dossier par section. Lisible via l'API, exportable tant que le compte est actif. Développeurs | Un endpoint renvoie le texte analysé d'un fichier de vector store, paginé. Export des embeddings ou d'un store complet : non documenté. Contenu d'un fichier de vector store (vérifié en octobre 2026) |
| Utilisation des données clients pour l'entraînement | Jamais utilisées pour entraîner l'IA, ni par Thalius ni par les fournisseurs de modèles ; leurs contrats l'interdisent. Sécurité | Les données de l'API ne sont pas utilisées pour l'entraînement par défaut ; leur partage nécessite un consentement explicite (opt-in). Vos données (vérifié en octobre 2026) |
| Modèle de tarification et offre gratuite | Des crédits, une seule unité sur toutes les offres. Offre Free avec crédits mensuels inclus et sans carte, Starter, et Corporate sur devis. Un refus coûte autant qu'une réponse. Montants sur Tarifs | Facturation à l'usage : stockage vectoriel par Go et par jour avec un quota gratuit, plus des frais par appel File Search. Montants sur la page des tarifs (vérifié en octobre 2026) |
Benchmark
Dix documents publics de la FDA pour Saxenda, Wegovy et Zepbound (2 198 pages), seize questions rédigées par l'équipe d'Atrogi, chacune posée trois fois dans des conversations indépendantes. Chaque système a répondu via le même modèle, GPT-5.4 mini, le 17 septembre 2026. Un modèle de notation, GPT-5 avec trois votes et un verdict à la majorité, a comparé chaque réponse à une réponse de référence ; décliner la question de contrôle compte comme une bonne réponse.
- Hippocampus : 40 bonnes réponses sur 48*, 79 % en score pondéré, médiane de 20 secondes par réponse.
- OpenAI File Search : 36 bonnes réponses sur 48*, moyenne de deux exécutions ayant obtenu 38 et 34, 64 % en score pondéré, médiane de 7 secondes par réponse.
Le score pondéré compte les questions faciles une fois, les moyennes deux fois et les difficiles trois fois. Sur la question de contrôle, à laquelle les documents ne permettent pas de répondre, File Search a donné un classement en guise de réponse dans quatre tentatives sur six ; Hippocampus a indiqué à chaque fois que les documents ne permettent pas d'établir un classement et, dans deux réponses sur trois, a proposé l'ordre d'approbation comme indicateur indirect, présenté comme tel.
Ce que ce résultat ne montre pas :
- L'écart entre Hippocampus et File Search se situe dans la variation d'une exécution à l'autre : les deux exécutions identiques de File Search différaient de quatre réponses.
- Les configurations d'Hippocampus testées les 16 et 17 septembre ont obtenu entre 37 et 40 sur 48. Le chiffre ci-dessus provient d'une exécution ayant obtenu 40.
- Le guide de recherche qu'Hippocampus donne au modèle a été affiné sur ces seize mêmes questions. Les autres systèmes ont fonctionné avec les réglages par défaut du fournisseur plus une instruction d'une phrase : ne répondre qu'à partir des documents fournis.
- File Search a été exécuté deux fois. Les autres systèmes une seule fois, de sorte que des différences de quelques réponses peuvent provenir de la seule variation.
- Hippocampus est le plus lent des systèmes testés : une médiane de 20 secondes par réponse contre 5 à 8 secondes pour les autres. Ces temps portent sur une réponse complète, le modèle effectuant autant de recherches qu'il lui faut. Dans notre rapport de benchmark ultérieur, une seule recherche Hippocampus prend 1,8 seconde en médiane.
- Le modèle de notation est GPT-5 d'OpenAI, et le modèle de réponse ainsi que deux des systèmes testés sont également d'OpenAI.
Le tableau complet des cinq systèmes figure dans Hippocampus face à OpenAI File Search et PageIndex. Le corpus, les questions et les résultats avec trois modèles de réponse figurent dans le benchmark FDA GLP-1, et chaque résultat publié se trouve sur Preuves.
* Modèle de réponse GPT-5.4 mini pour chaque système. Notation par GPT-5, trois votes, verdict à la majorité. Évaluation Thalius, 17 septembre 2026.
Réponses correctes sur 48 au benchmark FDA
Chaque barre compte les réponses correctes sur 48 pour dix documents publics de la FDA, seize questions posées trois fois chacune.
- Hippocampus 40 sur 48
- OpenAI File Search 36 sur 48
Vue tableau : chaque décompte derrière le graphique
| Nom | Valeur | Remarque |
|---|---|---|
| Hippocampus | 40 sur 48 | |
| OpenAI File Search | 36 sur 48 | Moyenne de deux exécutions identiques : 38 et 34 |
Quand OpenAI File Search est le meilleur choix
- Vous développez déjà sur la Responses API d'OpenAI et voulez la récupération comme un outil de plus dans le même appel : les fichiers sont découpés, vectorisés et indexés au chargement, sans service séparé à exploiter (Guide Retrieval, vérifié en octobre 2026).
- Vous voulez régler vous-même la récupération : pondération de la recherche hybride, réécriture de requête, seuil de score et filtres d'attributs sont tous exposés (Guide Retrieval, vérifié en octobre 2026).
- Il vous faut un stockage dans une région hors UE : OpenAI mentionne un stockage régional dans dix régions, dont l'Australie, le Canada, le Japon et les Émirats arabes unis, avec un traitement régional aux États-Unis et en Europe pour File Search (Vos données, vérifié en octobre 2026).
- La vitesse compte plus que la profondeur : dans notre benchmark FDA, File Search a répondu en 7 secondes en médiane contre 20 pour Hippocampus.
Essayez Hippocampus sur les mêmes documents
Importez les documents que vous mettriez dans un vector store File Search et posez les mêmes questions à Hippocampus, avec un modèle OpenAI pour répondre si vous le souhaitez. Commencer gratuitement, sans carte. Avant cela, lisez comment Hippocampus applique les permissions et où il stocke les documents, l'API, le serveur MCP et le format d'export, le fonctionnement des crédits sur chaque offre et l'hébergement dans votre propre cloud ou sur site avec l'offre Enterprise.
Sources et dernière mise à jour
Dernière mise à jour : octobre 2026.
- OpenAI : Vos données
- OpenAI : Guide File Search
- OpenAI : Guide Retrieval
- OpenAI : Guide MCP et connecteurs
- OpenAI : Récupérer le contenu d'un fichier de vector store
- OpenAI : Tarifs
- Thalius : Preuves
- Thalius : Sécurité
- Thalius : Développeurs
- Thalius : Tarifs
- Thalius : Entreprises
- Thalius : Hippocampus face à OpenAI File Search et PageIndex
- Thalius : Le benchmark FDA GLP-1
- Thalius : Hippocampus vs PageIndex
- Thalius : Hippocampus vs Vertex AI Search
Questions
Questions fréquentes
Comment Hippocampus se compare-t-il à OpenAI File Search ?
Hippocampus est le meilleur choix quand chaque réponse doit pouvoir être vérifiée sur une page et quand les personnes comme les agents ne doivent voir que ce qu'ils ont le droit de lire. OpenAI File Search est le meilleur choix pour les équipes qui utilisent la Responses API d'OpenAI, ou pour la vitesse, avec une médiane de 7 secondes par réponse contre 20. Sur le benchmark FDA de Thalius, Hippocampus a répondu correctement à 40 questions sur 48 et File Search à 36 sur 48, un écart compris dans la variation d'une exécution à l'autre.
Puis-je garder mes modèles OpenAI et utiliser Hippocampus pour la récupération ?
Oui : Hippocampus fonctionne avec n'importe quel modèle de langage, y compris ceux d'OpenAI. Vous choisissez quel modèle répond, réglé par espace de travail ; sur Corporate, vous pouvez utiliser votre propre clé de modèle ou laisser un administrateur choisir les modèles. La récupération et les citations restent dans Hippocampus, quel que soit le modèle qui répond.
OpenAI File Search fournit-il des citations au niveau de la page ?
La citation au niveau de la page n'est pas documentée pour File Search : les réponses portent une citation de fichier avec l'identifiant du fichier, le nom du fichier et un index de caractère (vérifié en octobre 2026). Hippocampus renvoie, pour chaque source, le document, le chemin de section, les pages de début et de fin, les décalages d'octets et le texte utilisé.
File Search peut-il restreindre les résultats par utilisateur ?
Pas sous forme de contrôle d'accès fondé sur l'identité : la voie documentée passe par des attributs de fichier et des filtres de métadonnées fournis par l'appelant (vérifié en octobre 2026). Hippocampus applique les permissions documentaires au sein même de la recherche, avant le classement, et ne renvoie rien si les permissions ne peuvent pas être vérifiées.
Puis-je conserver mes documents dans l'UE ?
Les deux stockent les documents en Europe. OpenAI mentionne un stockage régional en Europe et un traitement régional en Europe pour File Search dans la Responses API, une approbation étant nécessaire pour les régions hors États-Unis (vérifié en octobre 2026). Hippocampus stocke les documents et la structure de connaissances dans l'UE (Finlande) ; l'inférence des modèles s'exécute par défaut aux États-Unis et peut, sur Corporate, être hébergée dans l'UE ou s'exécuter dans votre propre environnement.
Mes données servent-elles à entraîner des modèles ?
Aucun des deux ne les utilise par défaut. OpenAI n'entraîne pas ses modèles sur les données de l'API, sauf si vous y consentez (vérifié en octobre 2026). Hippocampus n'utilise jamais les données clients pour entraîner l'IA, et ses contrats l'interdisent aux fournisseurs de modèles.