Comparativa · 18 de octubre de 2026
Hippocampus vs OpenAI File Search, comparados en diez dimensiones
Hippocampus es la mejor opción cuando cada respuesta debe poder comprobarse en una página y cuando las personas y los agentes solo pueden ver lo que tienen permiso para leer. OpenAI File Search es la mejor opción cuando ya desarrollas sobre la Responses API de OpenAI, quieres la recuperación como una herramienta alojada más, quieres ajustar tú mismo la búsqueda híbrida o necesitas respuestas rápidas. En nuestro benchmark de la FDA, con GPT-5.4 mini respondiendo en ambos, Hippocampus respondió correctamente 40 de 48 preguntas y File Search 36 de 48*, una distancia que queda dentro de la variación entre ejecuciones. File Search fue más rápido: una mediana de 7 segundos por respuesta frente a 20 de Hippocampus.
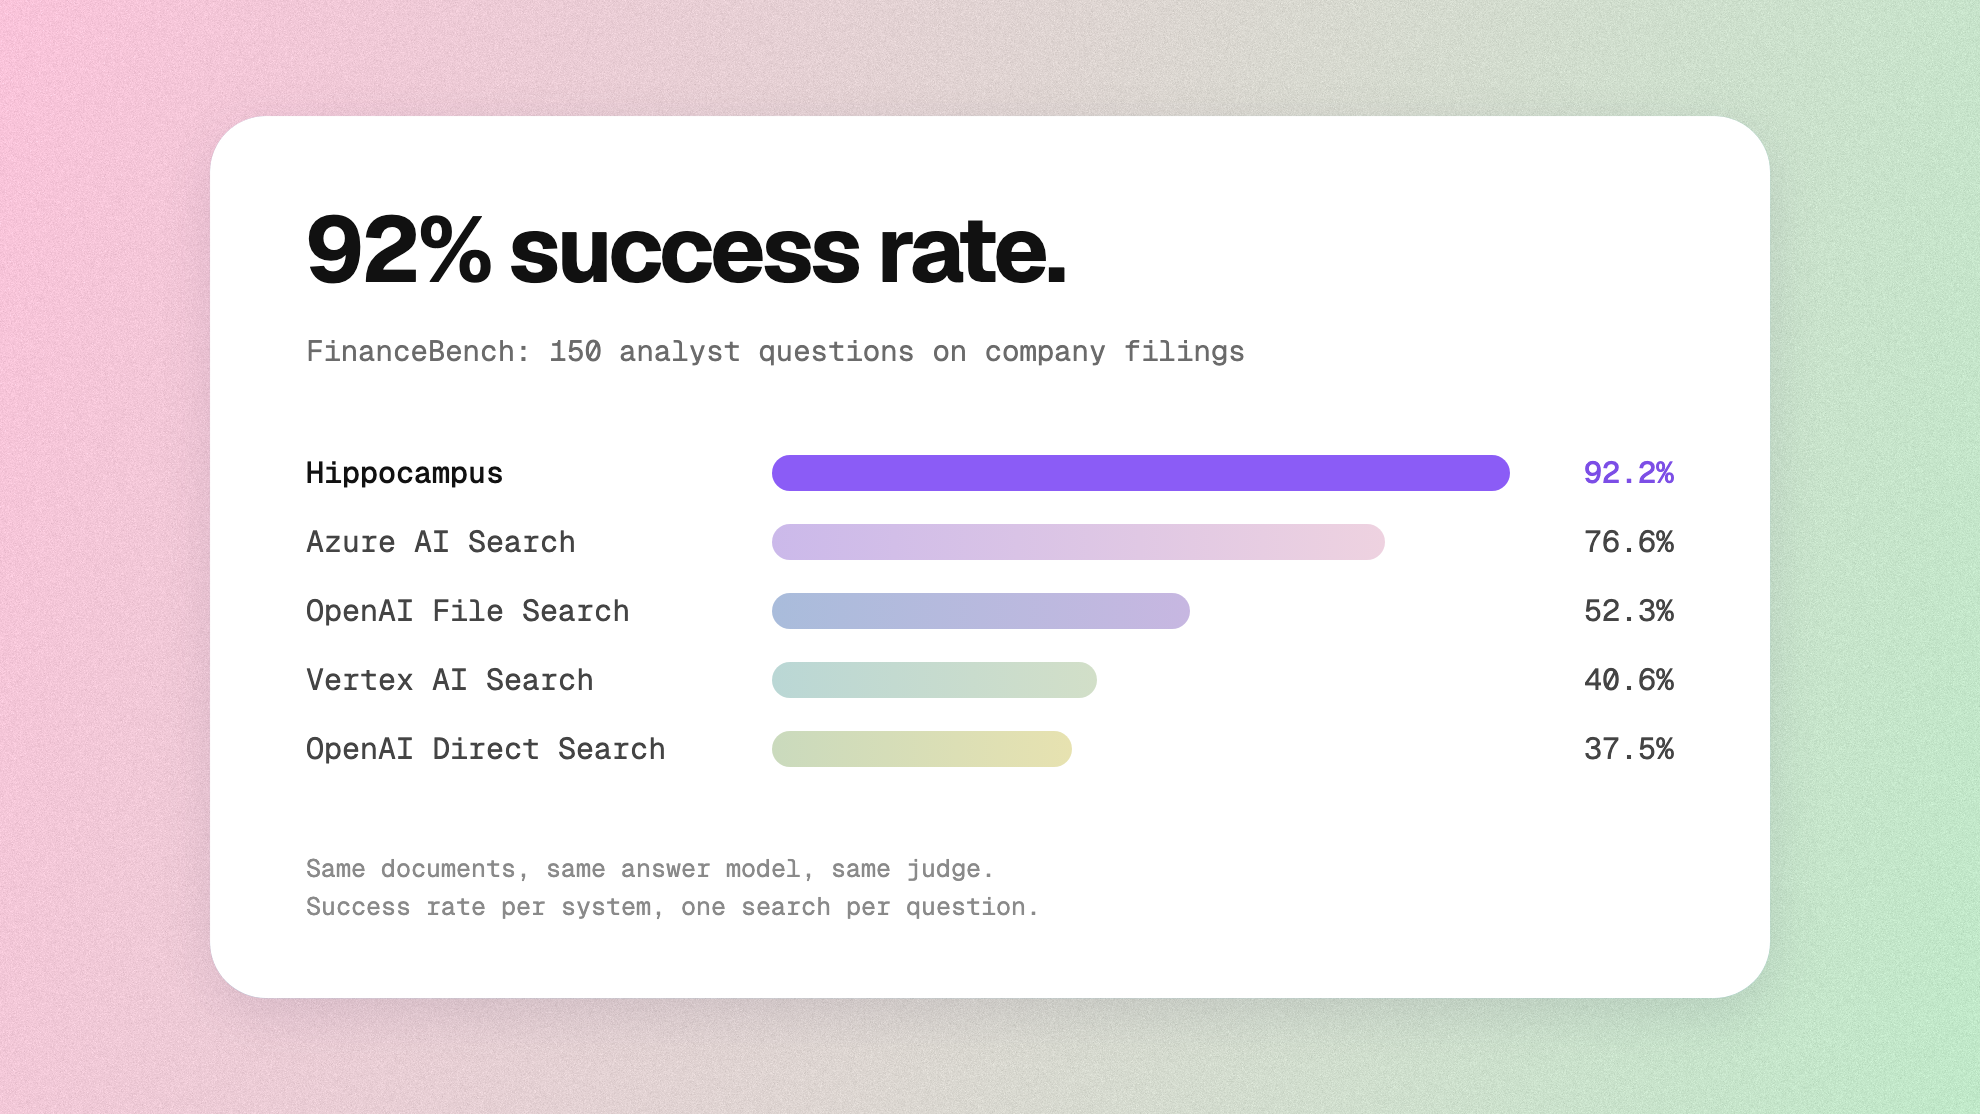
Este artículo compara los dos productos dimensión por dimensión. La ejecución del benchmark en sí, con cinco sistemas comparados uno junto a otro y las preguntas en las que difieren, es nuestro artículo anterior Hippocampus frente a OpenAI File Search y PageIndex; este artículo no la repite. También comparamos Hippocampus vs PageIndex y Hippocampus vs Vertex AI Search.
En esta páginaResumen
Resumen
| Dimensión | Hippocampus | OpenAI File Search |
|---|---|---|
| Región de alojamiento y autoalojamiento | Los documentos y la estructura de conocimiento se almacenan en la UE (Finlandia), cifrados. La inferencia de modelos se ejecuta en EE. UU. por defecto; en Corporate puede ejecutarse alojada en la UE o en tu propio entorno. El alojamiento en tu propia nube o en tus instalaciones forma parte del paquete Enterprise. Seguridad | La residencia de datos se configura por proyecto, con almacenamiento regional en EE. UU., Europa y otras ocho regiones. Los vector stores no tienen procesamiento regional; File Search en la Responses API tiene procesamiento regional solo en EE. UU. y Europa. Las regiones fuera de EE. UU. requieren aprobación. Autoalojamiento: no documentado. Your data (consultado en octubre de 2026) |
| Atribución de fuentes (cita a nivel de página) | Cada respuesta incluye el documento, la ruta de secciones, la página inicial y final, los desplazamientos de bytes y el texto utilizado. Las citas proceden del paso de recuperación, no del modelo. | Las respuestas llevan anotaciones file_citation con el ID del archivo, el nombre del archivo y un índice de caracteres. Cita a nivel de página: no documentada. Guía de File Search (consultado en octubre de 2026) |
| Aplicación de permisos en el momento de la consulta | Se aplican dentro de la búsqueda como filtro antes del ranking; no devuelve nada si no se pueden comprobar los permisos. Un resumen de varios documentos solo lo ven las personas que pueden leerlos todos. Los agentes obedecen los mismos permisos. Seguridad | Control de acceso por usuario: no documentado. Quien hace la llamada puede acotar los archivos en los que se busca con atributos de archivo y filtros de metadatos. Guía de recuperación (consultado en octubre de 2026) |
| Comportamiento ante preguntas sin respuesta | Cuando la recuperación no devuelve nada, la pregunta se rechaza en lugar de adivinarse. Un rechazo cuesta los mismos créditos que una respuesta. | Comportamiento de rechazo: no documentado. Un umbral de puntuación y un límite de resultados reducen los fragmentos devueltos. Guía de File Search, Guía de recuperación (consultado en octubre de 2026) |
| Arquitectura de recuperación (memoria estructurada, índice vectorial o búsqueda en archivos) | Memoria estructurada creada en la importación: un árbol por documento con un resumen índice, resúmenes de sección y secciones hoja con páginas y rangos de bytes. Dos embudos, de arriba abajo sobre los resúmenes y de abajo arriba con búsqueda por palabras clave y embeddings sobre las secciones hoja, fusionados en un único ranking. Desarrolladores | Vector store: al subirlos, los archivos se dividen en fragmentos (800 tokens con 400 de solapamiento por defecto), se convierten en embeddings y se indexan. Búsqueda semántica con reescritura opcional de la consulta y búsqueda híbrida ponderada por palabras clave, hasta 50 resultados. Guía de recuperación (consultado en octubre de 2026) |
| Modelos de respuesta compatibles | Cualquier modelo de lenguaje. Tú eliges qué modelo responde, configurado por espacio de trabajo; en Corporate puedes usar tu propia clave de modelo o dejar que los administradores elijan los modelos. Desarrolladores | Se ejecuta como herramienta en la Responses API de OpenAI. Lista de modelos compatibles: no documentada. Guía de File Search (consultado en octubre de 2026) |
| Disponibilidad de API y MCP | Un servidor MCP con inicio de sesión OAuth en el navegador y una API REST en acceso anticipado. Desarrolladores | Se configura como herramienta en la Responses API. La Responses API puede llamar a servidores MCP remotos; File Search como servidor MCP alojado: no documentado. Guía de File Search, Guía de MCP (consultado en octubre de 2026) |
| Formato de exportación de datos | Open Knowledge Format: una carpeta por documento en Markdown con front matter YAML, que contiene el resumen índice, el texto completo, el archivo original y una carpeta por sección. Legible a través de la API y exportable mientras la cuenta esté activa. Desarrolladores | Un endpoint devuelve el texto analizado de un archivo de un vector store, paginado. Exportación de embeddings o de un store completo: no documentada. Contenido de archivos de vector store (consultado en octubre de 2026) |
| Uso de los datos del cliente para entrenamiento | Nunca se usan para entrenar IA, ni por Thalius ni por los proveedores de modelos; sus contratos lo prohíben. Seguridad | Los datos de la API no se usan para entrenamiento por defecto; compartirlos requiere una aceptación explícita. Your data (consultado en octubre de 2026) |
| Modelo de precios y nivel gratuito | Créditos, una sola unidad en todos los niveles. Nivel Free con créditos mensuales incluidos y sin tarjeta, Starter, y Corporate bajo presupuesto. Un rechazo cuesta lo mismo que una respuesta. Importes en Precios | Por uso: almacenamiento vectorial por GB y día con una cuota gratuita, más una tarifa por llamada a File Search. Importes en la página de precios (consultado en octubre de 2026) |
Benchmark
Diez documentos públicos de la FDA sobre Saxenda, Wegovy y Zepbound (2.198 páginas), dieciséis preguntas redactadas por el equipo de Atrogi, cada una formulada tres veces en conversaciones independientes. Todos los sistemas respondieron a través del mismo modelo, GPT-5.4 mini, el 17 de septiembre de 2026. Un modelo evaluador, GPT-5 con tres votos y veredicto por mayoría, comparó cada respuesta con una respuesta de referencia; rechazar la pregunta de control cuenta como correcto.
- Hippocampus: 40 de 48 correctas*, 79 % ponderado, mediana de 20 segundos por respuesta.
- OpenAI File Search: 36 de 48 correctas*, la media de dos ejecuciones que obtuvieron 38 y 34, 64 % ponderado, mediana de 7 segundos por respuesta.
La puntuación ponderada cuenta las preguntas fáciles una vez, las medias dos y las difíciles tres. En la pregunta de control, que los documentos no pueden responder, File Search dio una clasificación como respuesta en cuatro de seis intentos; Hippocampus dijo cada vez que los documentos no permiten una clasificación y, en dos de tres respuestas, ofreció el orden de aprobación como aproximación, indicándolo expresamente.
Lo que este resultado no muestra:
- La distancia entre Hippocampus y File Search queda dentro de la variación entre ejecuciones: las dos ejecuciones idénticas de File Search difirieron en cuatro respuestas.
- Las configuraciones de Hippocampus probadas el 16 y 17 de septiembre obtuvieron entre 37 y 40 de 48. La cifra anterior corresponde a una ejecución que obtuvo 40.
- La guía de búsqueda que Hippocampus da al modelo se afinó con estas mismas dieciséis preguntas. Los demás sistemas se ejecutaron con los valores por defecto del proveedor más una instrucción de una frase: responder solo a partir del material.
- File Search se ejecutó dos veces. Los demás sistemas se ejecutaron una vez, así que diferencias de unas pocas respuestas pueden deberse solo a la variación.
- Hippocampus es el sistema más lento de los probados: una mediana de 20 segundos por respuesta frente a entre 5 y 8 segundos en los demás. Son tiempos de una respuesta completa, en la que el modelo busca tantas veces como necesita. En nuestro informe de benchmarks posterior, una sola búsqueda de Hippocampus tarda 1,8 segundos en la mediana.
- El modelo evaluador es GPT-5 de OpenAI, y el modelo de respuesta y dos de los sistemas probados también son de OpenAI.
La tabla completa con los cinco sistemas está en Hippocampus frente a OpenAI File Search y PageIndex. El corpus, las preguntas y los resultados con tres modelos de respuesta están en el benchmark GLP-1 de la FDA, y todos los resultados publicados están en Pruebas.
* Modelo de respuesta GPT-5.4 mini para todos los sistemas. Evaluación por GPT-5, tres votos, veredicto por mayoría. Evaluación de Thalius, 17 de septiembre de 2026.
Respuestas correctas de 48 en el benchmark de la FDA
Cada barra cuenta las respuestas correctas de 48 sobre diez documentos públicos de la FDA, dieciséis preguntas formuladas tres veces cada una.
- Hippocampus 40 de 48
- OpenAI File Search 36 de 48
Vista de tabla: cada recuento detrás del gráfico
| Nombre | Valor | Nota |
|---|---|---|
| Hippocampus | 40 de 48 | |
| OpenAI File Search | 36 de 48 | Media de dos ejecuciones idénticas: 38 y 34 |
Cuándo OpenAI File Search es la mejor opción
- Ya desarrollas sobre la Responses API de OpenAI y quieres la recuperación como una herramienta más en la misma llamada: al subirlos, los archivos se dividen en fragmentos, se convierten en embeddings y se indexan, sin un servicio aparte que mantener (Guía de recuperación, consultado en octubre de 2026).
- Quieres ajustar tú mismo la recuperación: los pesos de la búsqueda híbrida, la reescritura de consultas, un umbral de puntuación y los filtros por atributos están todos expuestos (Guía de recuperación, consultado en octubre de 2026).
- Necesitas almacenamiento en una región fuera de la UE: OpenAI ofrece almacenamiento regional en diez regiones, entre ellas Australia, Canadá, Japón y los EAU, con procesamiento regional en EE. UU. y Europa para File Search (Your data, consultado en octubre de 2026).
- La velocidad importa más que la profundidad: en nuestro benchmark de la FDA, File Search respondió con una mediana de 7 segundos frente a 20 de Hippocampus.
Prueba Hippocampus con los mismos documentos
Sube los documentos que pondrías en un vector store de File Search y hazle a Hippocampus las mismas preguntas, con un modelo de OpenAI respondiendo si quieres. Empieza gratis, sin tarjeta. Antes, lee cómo aplica Hippocampus los permisos y dónde almacena los documentos, la API, el servidor MCP y el formato de exportación, cómo funcionan los créditos en cada nivel y el alojamiento en tu propia nube o en tus instalaciones con el paquete Enterprise.
Fuentes y última actualización
Última actualización: octubre de 2026.
- OpenAI: Your data
- OpenAI: Guía de File Search
- OpenAI: Guía de recuperación
- OpenAI: Guía de MCP y conectores
- OpenAI: Obtener el contenido de un archivo de vector store
- OpenAI: Precios
- Thalius: Pruebas
- Thalius: Seguridad
- Thalius: Desarrolladores
- Thalius: Precios
- Thalius: Enterprise
- Thalius: Hippocampus frente a OpenAI File Search y PageIndex
- Thalius: El benchmark GLP-1 de la FDA
- Thalius: Hippocampus vs PageIndex
- Thalius: Hippocampus vs Vertex AI Search
Preguntas
Preguntas frecuentes
¿Cómo se compara Hippocampus con OpenAI File Search?
Hippocampus es la mejor opción cuando cada respuesta debe poder comprobarse en una página y cuando las personas y los agentes solo deben ver lo que tienen permiso para leer. OpenAI File Search es la mejor opción para equipos que usan la Responses API de OpenAI o cuando prima la velocidad, con una mediana de 7 segundos por respuesta frente a 20. En el benchmark de la FDA de Thalius, Hippocampus respondió correctamente 40 de 48 y File Search 36 de 48, una diferencia dentro de la variación entre ejecuciones.
¿Puedo mantener mis modelos de OpenAI y usar Hippocampus para la recuperación?
Sí: Hippocampus funciona con cualquier modelo de lenguaje, incluidos los de OpenAI. Tú eliges qué modelo responde, configurado por espacio de trabajo; en Corporate puedes usar tu propia clave de modelo o dejar que un administrador elija los modelos. La recuperación y las citas se quedan en Hippocampus, responda el modelo que responda.
¿OpenAI File Search ofrece citas a nivel de página?
La cita a nivel de página no está documentada para File Search: las respuestas llevan una cita de archivo con el ID del archivo, el nombre del archivo y un índice de caracteres (consultado en octubre de 2026). Hippocampus devuelve el documento, la ruta de secciones, la página inicial y final, los desplazamientos de bytes y el texto utilizado para cada fuente.
¿Puede File Search restringir los resultados por usuario?
No como control de acceso basado en la identidad: la vía documentada son los atributos de archivo y los filtros de metadatos que aporta quien hace la llamada (consultado en octubre de 2026). Hippocampus aplica los permisos de los documentos dentro de la búsqueda, antes del ranking, y no devuelve nada si no se pueden comprobar los permisos.
¿Puedo mantener mis documentos en la UE?
Ambos almacenan los documentos en Europa. OpenAI ofrece almacenamiento regional en Europa y procesamiento regional en Europa para File Search en la Responses API, con aprobación necesaria para las regiones fuera de EE. UU. (consultado en octubre de 2026). Hippocampus almacena los documentos y la estructura de conocimiento en la UE (Finlandia); la inferencia de modelos se ejecuta en EE. UU. por defecto y, en Corporate, puede ejecutarse alojada en la UE o en tu propio entorno.
¿Se usan mis datos para entrenar modelos?
Ninguno de los dos los usa por defecto. OpenAI no entrena con datos de la API salvo que lo aceptes expresamente (consultado en octubre de 2026). Hippocampus nunca usa datos de clientes para entrenar IA, y sus contratos prohíben a los proveedores de modelos hacerlo.