Benchmarks · 17 septembre 2026
Hippocampus sur des documents GLP-1 de la FDA : 97 % de bonnes réponses avec Claude Opus 5
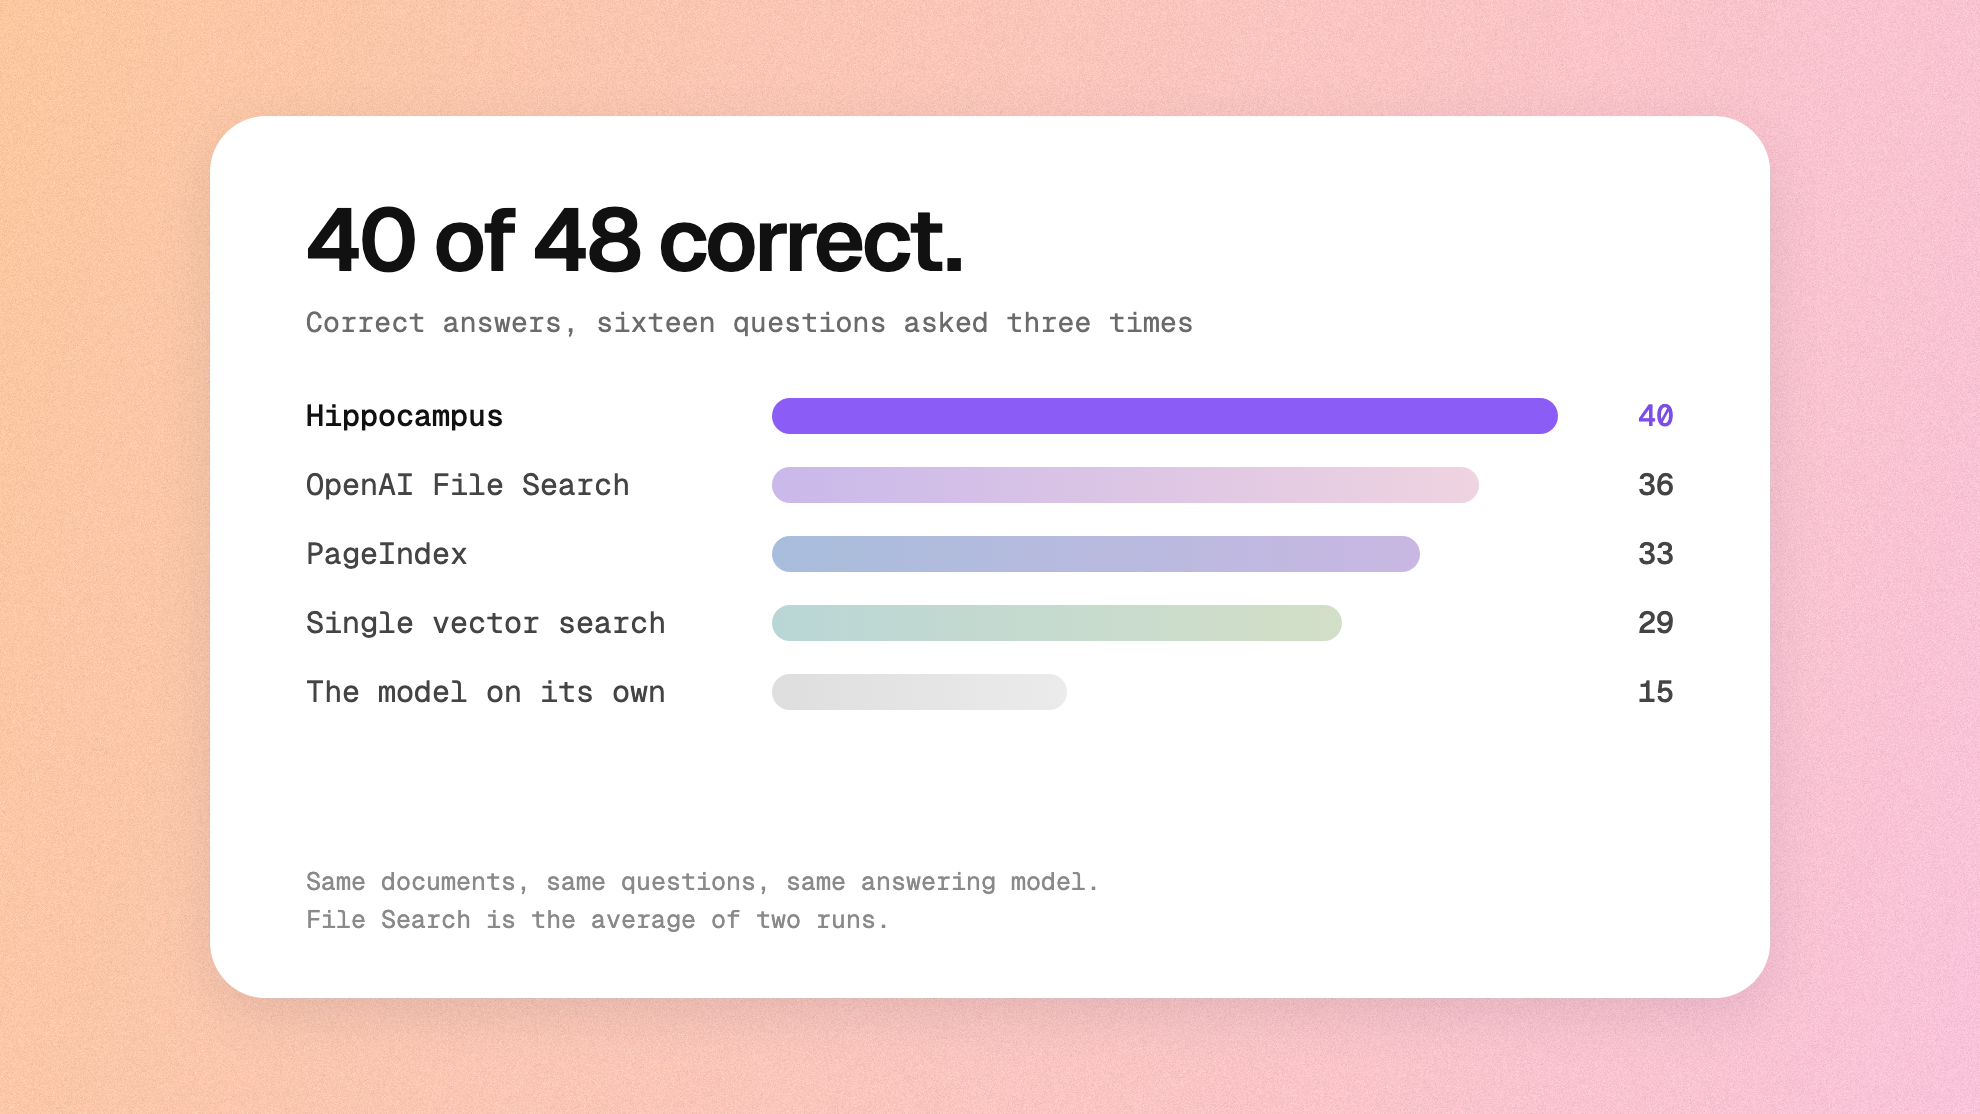
Sur 2 198 pages de documents publics de la FDA, Hippocampus a donné 93 bonnes réponses sur 96 (97 %) avec Claude Opus 5 comme modèle de réponse, sans rien inventer. Avec un même petit modèle rédigeant toutes les réponses pour cinq systèmes, Hippocampus a répondu correctement à 40 questions sur 48, le meilleur résultat de la comparaison.
Sur cette pageLe test
Le test
Dix documents publics sur trois thérapies GLP-1 pour la gestion du poids : Saxenda et Wegovy de Novo Nordisk, Zepbound d'Eli Lilly. Évaluations cliniques et multidisciplinaires de la FDA de 230 à 390 pages, informations de prescription, dossiers d'approbation, et l'essai STEP 1 dans le New England Journal of Medicine. La même mesure apparaît à plusieurs endroits, pour différents essais et différentes échéances, de sorte qu'une bonne réponse dépend du bon passage, pas seulement du bon document.
Seize questions d'experts, rédigées avec un client : 8 faciles (un fait isolé), 4 moyennes (comparaisons d'un document à l'autre) et 4 difficiles (synthèse à travers les thérapies, plus une question de contrôle à laquelle les documents ne permettent pas de répondre, et pour laquelle décliner est la bonne réponse). Chaque question a été posée trois fois, dans des conversations indépendantes.
Nous présentons deux exécutions :
- La comparaison (17 septembre 2026) : cinq systèmes, un seul petit modèle de réponse, GPT-5.4 mini, pour tous.
- L'exécution avec le modèle de pointe (16 et 17 septembre 2026) : Hippocampus avec Claude Opus 5 comme modèle de réponse, la série complète deux fois, plus deux modèles à bas coût.
Comment lire les chiffres
- Correctes : un modèle de notation distinct a comparé chaque réponse à la réponse de référence, trois votes, verdict à la majorité. Décliner la question de contrôle compte comme une bonne réponse.
- Score pondéré : les questions faciles comptent une fois, les moyennes deux fois, les difficiles trois fois.
- Juste à chaque répétition : parmi les 16 questions, celles qui ont reçu une bonne réponse à chaque répétition ; pour Claude Opus 5, lors des six tentatives des deux exécutions.
- Source trouvée : la récupération a atteint au moins un document contenant la réponse.
- Coût : par réponse.
La comparaison : cinq systèmes, un seul petit modèle
| Système | Correctes sur 48 | Score pondéré | Faciles (24) | Moyennes (12) | Difficiles (12) |
|---|---|---|---|---|---|
| Hippocampus | 40 | 79 % | 23 | 8 | 9 |
| PageIndex | 33 | 65 % | 19 | 6 | 8 |
| OpenAI File Search, moyenne de 2 exécutions | 36 | 64 % | 24 | 6,5 | 5,5 |
| Recherche dans le vector store OpenAI | 29 | 46 % | 21 | 6 | 2 |
| Sans documents | 15 | 25 % | 12 | 0 | 3 |
OpenAI File Search a été exécuté deux fois avec des réglages identiques et a obtenu 38 et 34 : l'écart entre Hippocampus et File Search se situe donc dans la variation d'une exécution à l'autre. Les écarts avec PageIndex, le vector store et le modèle seul sont plus grands.
Les recherches simples sont faciles pour tout le monde. La différence se joue sur les comparaisons et la synthèse : sur les 24 réponses moyennes et difficiles, Hippocampus en a obtenu 17 justes, question de contrôle comprise, PageIndex 14, File Search 12 en moyenne (14 et 10) et le vector store 8.
Sur la question de contrôle, PageIndex a décliné à chaque fois. Hippocampus a indiqué à chaque fois que les documents ne permettent pas d'établir un classement et, dans deux réponses sur trois, a proposé l'ordre d'approbation comme indicateur indirect, présenté comme tel. File Search a donné un classement dans 4 tentatives sur 6, le vector store dans 1 sur 3.
Réponses correctes par difficulté, un même petit modèle pour tous les systèmes
Chaque barre compte les réponses correctes sur 24 : à gauche les 8 questions faciles, à droite les 4 questions moyennes et les 4 difficiles, chacune posée trois fois.
Questions faciles, sur 24
- Hippocampus 23 sur 24
- PageIndex 19 sur 24
- OpenAI File Search, moyenne de 2 exécutions 24 sur 24
- Recherche dans le vector store OpenAI 21 sur 24
- Sans documents 12 sur 24
Questions moyennes et difficiles, sur 24
- Hippocampus 17 sur 24
- PageIndex 14 sur 24
- OpenAI File Search, moyenne de 2 exécutions 12 sur 24
- Recherche dans le vector store OpenAI 8 sur 24
- Sans documents 3 sur 24
Vue tableau : chaque décompte derrière le graphique
| Groupe | Nom | Valeur | Remarque |
|---|---|---|---|
| Questions faciles, sur 24 | Hippocampus | 23 sur 24 | |
| Questions faciles, sur 24 | PageIndex | 19 sur 24 | Notre adaptation de l'approche de recherche arborescente publiée |
| Questions faciles, sur 24 | OpenAI File Search, moyenne de 2 exécutions | 24 sur 24 | Moyenne de deux exécutions identiques |
| Questions faciles, sur 24 | Recherche dans le vector store OpenAI | 21 sur 24 | |
| Questions faciles, sur 24 | Sans documents | 12 sur 24 | Les connaissances propres du modèle |
| Questions moyennes et difficiles, sur 24 | Hippocampus | 17 sur 24 | Question de contrôle comprise |
| Questions moyennes et difficiles, sur 24 | PageIndex | 14 sur 24 | |
| Questions moyennes et difficiles, sur 24 | OpenAI File Search, moyenne de 2 exécutions | 12 sur 24 | Moyenne de deux exécutions : 14 et 10 |
| Questions moyennes et difficiles, sur 24 | Recherche dans le vector store OpenAI | 8 sur 24 | |
| Questions moyennes et difficiles, sur 24 | Sans documents | 3 sur 24 |
L'exécution avec le modèle de pointe : même récupération, trois modèles de réponse
| Modèle de réponse | Correctes | Juste à chaque répétition | Inventées | Source trouvée | Coût |
|---|---|---|---|---|---|
| Claude Opus 5, deux exécutions | 93 sur 96 | 15 sur 16 | 0 | 100 % | 0,61 $ |
| GPT-5.4 mini | 40 sur 48 | 11 sur 16 | 0 | 98 % | 0,12 $ |
| Claude Haiku 4.5 | 38 sur 48 | 11 sur 16 | 0 | 93 % | 0,09 $ |
Claude Opus 5 a obtenu 47 et 46 sur 48 lors de deux exécutions à quelques heures d'intervalle, et a décliné la question de contrôle 6 fois sur 6. L'écart d'une réponse entre les deux exécutions est la mesure honnête de la reproductibilité. L'exécution a été configurée pour la précision, pas pour l'économie : raisonnement étendu et autant de recherches que chaque question l'exigeait. Sur la même récupération, des modèles à bas coût obtiennent de 38 à 40 bonnes réponses sur 48, pour 0,09 $ à 0,12 $ par réponse, sans jamais inventer de réponse.
Questions justes à chaque répétition, trois modèles de réponse sur Hippocampus
Chaque barre compte les questions, sur 16, auxquelles il a été répondu correctement à chaque répétition, avec la même récupération Hippocampus et un modèle de réponse différent.
- Claude Opus 5, deux exécutions 15 sur 16
- GPT-5.4 mini 11 sur 16
- Claude Haiku 4.5 11 sur 16
Vue tableau : chaque décompte derrière le graphique
| Nom | Valeur | Remarque |
|---|---|---|
| Claude Opus 5, deux exécutions | 15 sur 16 | Les six tentatives ; 93 réponses correctes sur 96 |
| GPT-5.4 mini | 11 sur 16 | Trois tentatives ; 40 réponses correctes sur 48 |
| Claude Haiku 4.5 | 11 sur 16 | Trois tentatives ; 38 réponses correctes sur 48 |
L'échec
Les trois échecs d'Opus portent sur une seule question : celle des signaux de sécurité communs aux trois thérapies. Une augmentation de la fréquence cardiaque est rapportée pour les trois, mais la FDA la classe sous Mises en garde et précautions d'emploi pour Saxenda et Wegovy, et sous Effets indésirables pour Zepbound. Une réponse qui ne compare que les listes de mises en garde conclut, à partir d'une prémisse vraie, que le signal n'est pas partagé. Interrogés de mémoire, deux des trois modèles de pointe se sont trompés sur ce classement, dans des directions opposées.
Hippocampus guide désormais le modèle pour qu'il recherche dans les documents propres à chaque produit avant d'affirmer qu'un élément est absent. Avec ce guidage, le signal a été reconnu comme commun dans 3 répétitions sur 6 ; avec la version précédente, dans 1 sur 6.
En toute transparence
- Les configurations d'Hippocampus testées avec GPT-5.4 mini les 16 et 17 septembre ont obtenu entre 37 et 40 sur 48. La comparaison montre une exécution ayant obtenu 40, réalisée plus tôt le même jour sur le service déployé, séparément des autres systèmes.
- Le guide de recherche qu'Hippocampus donne au modèle a été affiné lors d'exécutions antérieures sur ces seize mêmes questions. Les autres systèmes ont fonctionné avec les réglages par défaut du fournisseur plus une instruction d'une phrase : ne répondre qu'à partir des documents fournis.
- Le modèle de notation de la comparaison est GPT-5. Le modèle de réponse et deux des systèmes testés proviennent également d'OpenAI.
- Avant la comparaison, trois réponses de référence ont été corrigées d'après les documents sources, et chaque système a été noté sur la même série corrigée.
- PageIndex a été exécuté sous la forme de notre adaptation de son approche publiée de recherche arborescente : une étape, jusqu'à six sections, 12 000 caractères par section. Les services de récupération et de chat propres à PageIndex n'ont pas été utilisés.
- Environ 410 des 2 198 pages n'ont pas de couche de texte, dont les 300 pages d'une évaluation pharmacologique de 2009. Le vector store d'OpenAI ne contenait aucun texte de cette évaluation ; Hippocampus et PageIndex lisent les pages scannées. Aucun système ne l'a citée, et la seule question qui s'appuie sur elle peut aussi trouver sa réponse dans une notice.
- Trois répétitions distinguent un comportement stable du hasard. Elles ne donnent pas d'intervalle de confiance.
Vitesse
Ces temps portent sur une réponse complète, y compris chaque recherche que le modèle a choisi d'effectuer. Dans la comparaison, Hippocampus a mis 20 secondes en médiane, contre 5 à 8 secondes pour les autres systèmes disposant des documents, et plus de deux minutes pour ses 5 % les plus lents. Les réponses qui nécessitaient une seule recherche ont pris environ 10 secondes ; les plus lentes concernaient des comparaisons et des synthèses, où le modèle a cherché de nombreuses fois. Avec Claude Opus 5, la médiane était de 46 secondes.
Notre méthode de test
Chaque système a travaillé à partir des dix mêmes PDF et des seize mêmes questions. Dans Hippocampus, le modèle interroge la collection aussi souvent qu'il en a besoin, par récupération hiérarchique (brevet en instance), et cite le document, la section et la page pour chaque affirmation. La méthode complète figure sur la page des preuves, sous l'onglet Santé.
Les documents sont publics. Nous pouvons charger les dix mêmes documents dans un espace de travail Hippocampus séparé, pour que vous puissiez poser vos propres questions avec le modèle de votre choix. Les questions et les réponses de référence appartiennent au client avec lequel elles ont été rédigées ; avec son accord, nous présentons aux parties qualifiées chaque réponse notée, sous accord de confidentialité (NDA).