
Benchmarks · 17 september 2026
Hippocampus på FDA-dokument om GLP-1: 97 % korrekt med Claude Opus 5
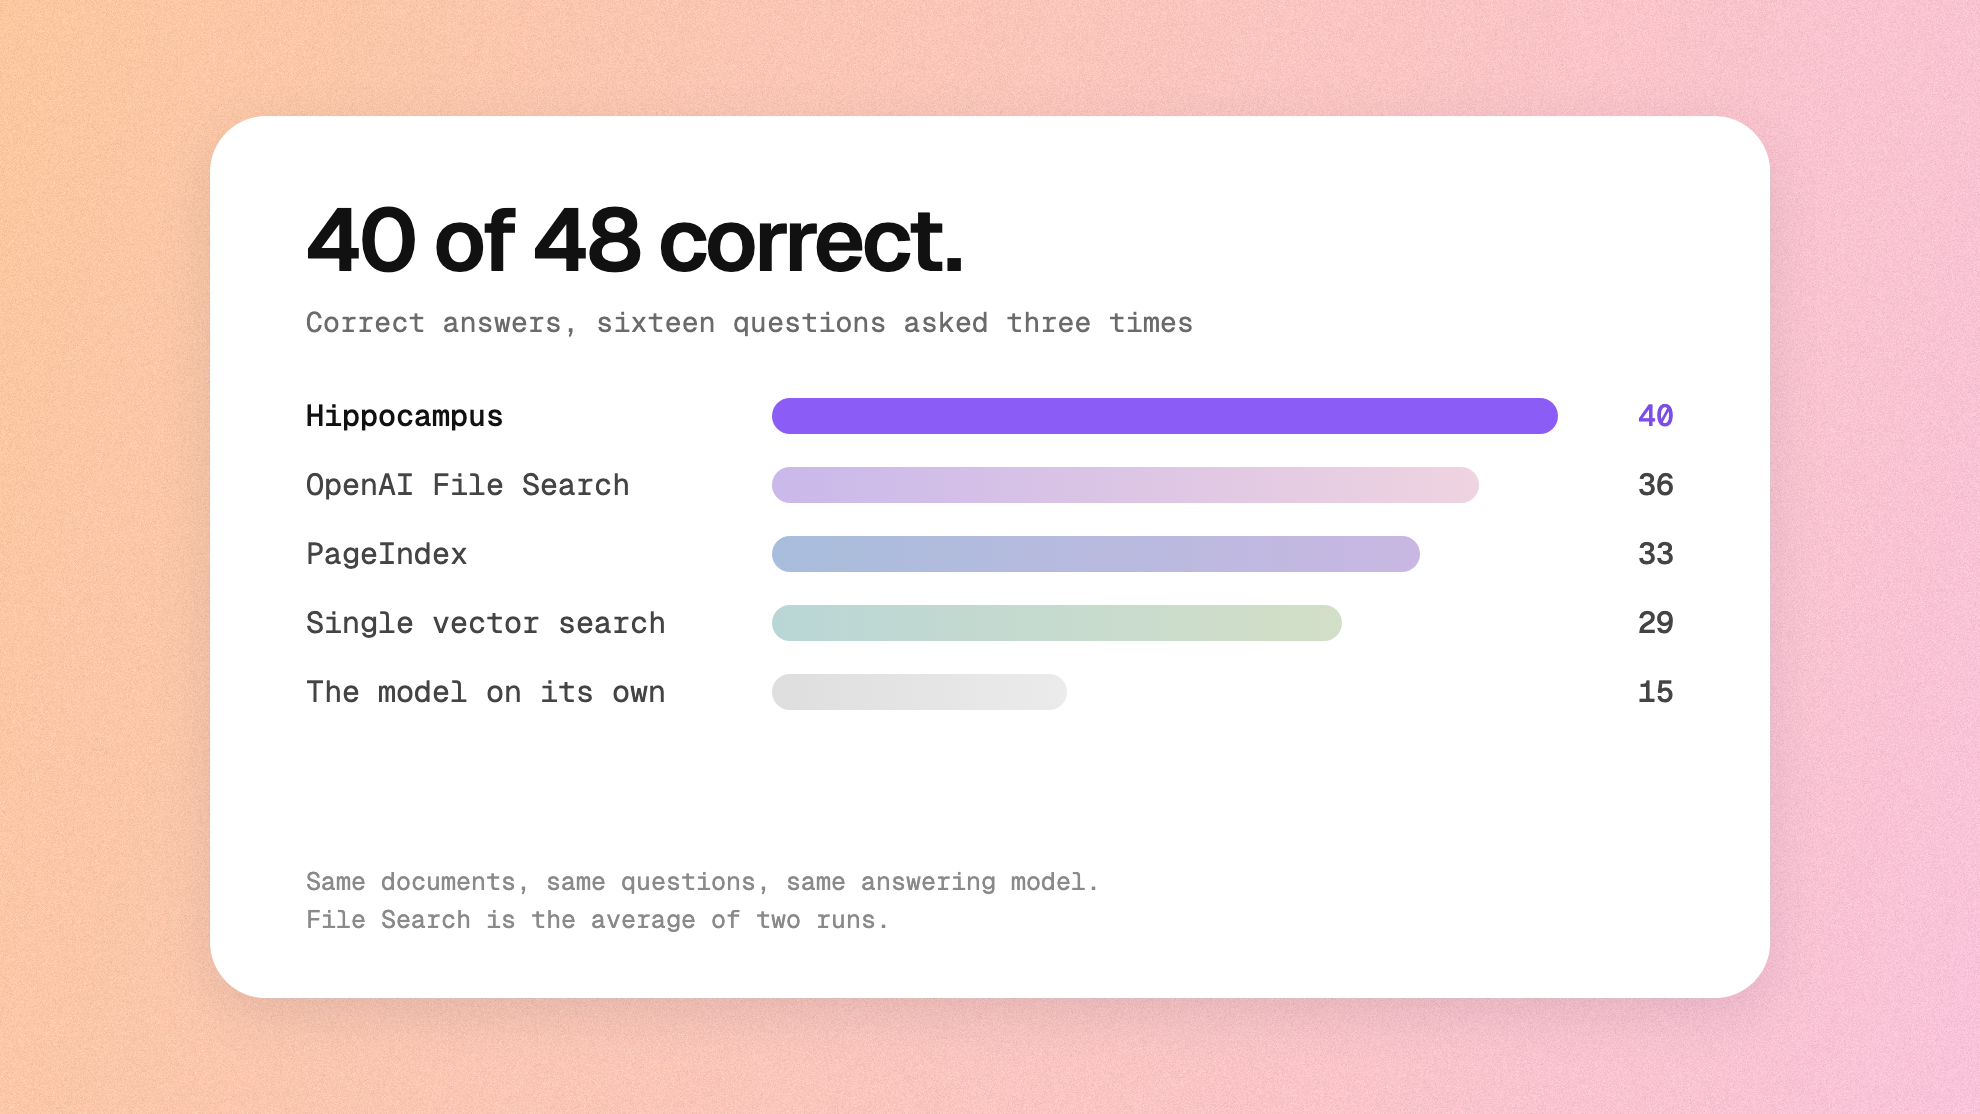
På 2 198 sidor offentliga FDA-dokument gav Hippocampus 93 rätta svar av 96 (97 %) med Claude Opus 5 som svarsmodell, och hittade inte på något. Med en och samma lilla modell som skrev varje svar för fem system svarade Hippocampus rätt på 40 av 48, flest i jämförelsen.
På den här sidanTestet
Testet
Tio offentliga dokument om tre GLP-1-terapier för viktkontroll: Saxenda och Wegovy från Novo Nordisk, Zepbound från Eli Lilly. FDA:s kliniska och multidisciplinära granskningar på 230 till 390 sidor, förskrivningsinformation, godkännandepaket och STEP 1-studien i New England Journal of Medicine. Samma mått förekommer på flera ställen, för olika studier och tidpunkter, så ett korrekt svar beror på rätt avsnitt, inte bara rätt dokument.
Sexton expertfrågor, skrivna tillsammans med en kund: 8 lätta (enskilda fakta), 4 medelsvåra (jämförelser mellan dokument) och 4 svåra (syntes över terapierna, plus en kontrollfråga som dokumenten inte kan besvara, där det är korrekt att avböja). Varje fråga ställdes tre gånger, i oberoende konversationer.
Vi redovisar två körningar:
- Jämförelsen (17 september 2026): fem system, en och samma lilla svarsmodell, GPT-5.4 mini, för samtliga.
- Körningen med den ledande modellen (16 till 17 september 2026): Hippocampus med Claude Opus 5 som svarsmodell, hela uppsättningen två gånger, plus två lågkostnadsmodeller.
Så läser du siffrorna
- Korrekt: en separat bedömningsmodell jämförde varje svar med referenssvaret, tre röster, majoritetsbeslut. Att avböja kontrollfrågan räknas som korrekt.
- Viktat: lätta frågor räknas en gång, medelsvåra två gånger, svåra tre gånger.
- Rätt varje gång: av de 16 frågorna, de som besvarades rätt i varje upprepning; för Claude Opus 5 i alla sex försöken över båda körningarna.
- Källa hittad: hämtningen nådde minst ett dokument som innehåller svaret.
- Kostnad: per svar.
Jämförelsen: fem system, en liten modell
| System | Korrekt av 48 | Viktat | Lätta (24) | Medelsvåra (12) | Svåra (12) |
|---|---|---|---|---|---|
| Hippocampus | 40 | 79 % | 23 | 8 | 9 |
| PageIndex | 33 | 65 % | 19 | 6 | 8 |
| OpenAI File Search, genomsnitt av 2 körningar | 36 | 64 % | 24 | 6,5 | 5,5 |
| OpenAI vector store search | 29 | 46 % | 21 | 6 | 2 |
| Inga dokument | 15 | 25 % | 12 | 0 | 3 |
OpenAI File Search kördes två gånger med identiska inställningar och fick 38 och 34, så gapet mellan Hippocampus och File Search ligger inom variationen mellan körningar. Gapen till PageIndex, till vector store-sökningen och till modellen ensam är större.
Uppslag är lätta för alla. Skillnaden ligger i jämförelser och syntes: av de 24 medelsvåra och svåra svaren fick Hippocampus 17 rätt, kontrollfrågan inräknad, PageIndex 14, File Search 12 i genomsnitt (14 och 10) och vector store-sökningen 8.
På kontrollfrågan avböjde PageIndex varje gång. Hippocampus sa varje gång att dokumenten inte kan stödja en rangordning, och erbjöd i två av tre svar godkännandeordningen som ett uttryckligen markerat närmevärde. File Search gav en rangordning i 4 av 6 försök, vector store-sökningen i 1 av 3.
Rätt svar per svårighetsgrad, en liten modell för alla system
Varje stapel räknar rätta svar av 24: till vänster de 8 lätta frågorna, till höger de 4 medelsvåra och 4 svåra frågorna, var och en ställd tre gånger.
Lätta frågor, av 24
- Hippocampus 23 av 24
- PageIndex 19 av 24
- OpenAI File Search, genomsnitt av 2 körningar 24 av 24
- OpenAI vector store search 21 av 24
- Inga dokument 12 av 24
Medelsvåra och svåra frågor, av 24
- Hippocampus 17 av 24
- PageIndex 14 av 24
- OpenAI File Search, genomsnitt av 2 körningar 12 av 24
- OpenAI vector store search 8 av 24
- Inga dokument 3 av 24
Tabellvy: varje antal bakom diagrammet
| Grupp | Namn | Värde | Anmärkning |
|---|---|---|---|
| Lätta frågor, av 24 | Hippocampus | 23 av 24 | |
| Lätta frågor, av 24 | PageIndex | 19 av 24 | Vår anpassning av den publicerade trädsökningsmetoden |
| Lätta frågor, av 24 | OpenAI File Search, genomsnitt av 2 körningar | 24 av 24 | Genomsnitt av två identiska körningar |
| Lätta frågor, av 24 | OpenAI vector store search | 21 av 24 | |
| Lätta frågor, av 24 | Inga dokument | 12 av 24 | Modellens egen kunskap |
| Medelsvåra och svåra frågor, av 24 | Hippocampus | 17 av 24 | Inklusive kontrollfrågan |
| Medelsvåra och svåra frågor, av 24 | PageIndex | 14 av 24 | |
| Medelsvåra och svåra frågor, av 24 | OpenAI File Search, genomsnitt av 2 körningar | 12 av 24 | Genomsnitt av två körningar: 14 och 10 |
| Medelsvåra och svåra frågor, av 24 | OpenAI vector store search | 8 av 24 | |
| Medelsvåra och svåra frågor, av 24 | Inga dokument | 3 av 24 |
Körningen med den ledande modellen: samma hämtning, tre svarsmodeller
| Svarsmodell | Korrekt | Rätt varje gång | Påhittat | Källa hittad | Kostnad |
|---|---|---|---|---|---|
| Claude Opus 5, två körningar | 93 av 96 | 15 av 16 | 0 | 100 % | 0,61 USD |
| GPT-5.4 mini | 40 av 48 | 11 av 16 | 0 | 98 % | 0,12 USD |
| Claude Haiku 4.5 | 38 av 48 | 11 av 16 | 0 | 93 % | 0,09 USD |
Claude Opus 5 fick 47 och 46 av 48 i två körningar med några timmars mellanrum, och avböjde kontrollfrågan 6 gånger av 6. Spridningen på ett svar är det ärliga måttet på repeterbarhet. Körningen var inställd för precision, inte ekonomi: utökat resonemang och så många sökningar som varje fråga behövde. Lågkostnadsmodeller på samma hämtning svarar rätt på 38 till 40 av 48 för 0,09 till 0,12 USD per svar, utan att någon gång hitta på ett svar.
Frågor rätt varje gång, tre svarsmodeller på Hippocampus
Varje stapel räknar de frågor, av 16, som besvarades rätt i varje upprepning, med samma Hippocampus-hämtning och olika svarsmodeller.
- Claude Opus 5, två körningar 15 av 16
- GPT-5.4 mini 11 av 16
- Claude Haiku 4.5 11 av 16
Tabellvy: varje antal bakom diagrammet
| Namn | Värde | Anmärkning |
|---|---|---|
| Claude Opus 5, två körningar | 15 av 16 | Alla sex försök; 93 av 96 svar korrekta |
| GPT-5.4 mini | 11 av 16 | Tre försök; 40 av 48 svar korrekta |
| Claude Haiku 4.5 | 11 av 16 | Tre försök; 38 av 48 svar korrekta |
Missen
Alla tre missar för Opus kom från en enda fråga: vilka säkerhetssignaler alla tre terapier delar. En ökad hjärtfrekvens rapporteras för alla tre, men FDA listar den under Warnings and Precautions för Saxenda och Wegovy och under Adverse Reactions för Zepbound. Ett svar som bara jämför varningslistorna drar, från en sann premiss, slutsatsen att signalen inte är delad. Tillfrågade ur minnet angav två av tre ledande modeller fel placering, åt motsatta håll.
Hippocampus vägleder nu modellen att söka i varje produkts egna dokument innan den påstår att något saknas. Med det räknade den signalen som delad i 3 av 6 upprepningar; den föregående versionen gjorde det i 1 av 6.
Ärliga förbehåll
- Hippocampus-konfigurationer som testades med GPT-5.4 mini 16 till 17 september fick mellan 37 och 40 av 48. Jämförelsen visar en körning som fick 40, gjord tidigare samma dag på den driftsatta tjänsten, separat från de andra systemen.
- Sökguiden som Hippocampus ger modellen förfinades i tidigare körningar på samma sexton frågor. De andra systemen kördes med leverantörernas standardinställningar plus en instruktion på en mening att bara svara utifrån materialet.
- Bedömningsmodellen i jämförelsen är GPT-5. Svarsmodellen och två av de testade systemen är också OpenAI:s.
- Före jämförelsen rättades tre referenssvar mot källdokumenten, och varje system bedömdes mot samma rättade uppsättning.
- PageIndex kördes som vår anpassning av den trädsökning som PageIndex har publicerat: ett steg, upp till sex avsnitt, 12 000 tecken per avsnitt. De egna hämtnings- och chattjänsterna från PageIndex användes inte.
- Ungefär 410 av de 2 198 sidorna saknar textlager, däribland alla 300 sidor i en farmakologisk granskning från 2009. OpenAI:s vector store innehöll ingen text ur den granskningen; Hippocampus och PageIndex läste skannade sidor. Inget system citerade den, och den enda fråga som bygger på den kan också besvaras ur förskrivningsinformation.
- Tre upprepningar skiljer stabilt beteende från slump. De ger inget konfidensintervall.
Hastighet
Det här är tider för ett helt svar, inklusive varje sökning som modellen valde att göra. I jämförelsen tog Hippocampus 20 sekunder i median, mot 5 till 8 sekunder för de andra systemen med dokument, och över två minuter för de långsammaste 5 %. Svar som krävde en sökning tog ungefär 10 sekunder; de långsamma var jämförelser och synteser, där modellen sökte många gånger. Med Claude Opus 5 var medianen 46 sekunder.
Så testade vi
Varje system arbetade utifrån samma tio PDF-filer och samma sexton frågor. I Hippocampus söker modellen i samlingen så ofta den behöver, med hierarkisk hämtning (patentsökt), och anger dokument, avsnitt och sida för varje påstående. Hela metoden finns på sidan Bevis under fliken Sjukvård.
Dokumenten är offentliga. Frågorna och referenssvaren tillhör kunden de skrevs tillsammans med; med kundens medgivande går vi igenom varje bedömt svar med kvalificerade parter under sekretessavtal.