
Översikt
Var Hippocampus finns i en AI-stack
Modeller resonerar, agenter agerar och människor beslutar. Mellan dem och ett företags dokument finns Hippocampus: dess tjänster läser in, kurerar och hämtar, och dess säkra OKF-wiki lagrar varje dokument som krypterad Markdown bakom en och samma uppsättning API:er.
Identitet och nycklar
Var kunskapen finns
Hippocampus
Vem frågar
Modeller den anropar
modellanrop live AI services valfri språkmodellVar den körs
Hippocampus körs i vårt moln eller på din egen hosting. Produkten är densamma i båda.
- Hippocampus-molnet
- Hostas och drivs av oss i EU. Registrera dig och anslut sedan dina AI-verktyg via MCP, eller din egen kod via API:et.
- Egen hosting
- Ditt eget moln, egna servrar eller någon annan miljö som du kontrollerar. Ingår i Corporate-paketet.
API:et och MCP är identiska i båda. Bara bas-URL:en skiljer sig.
Egen drift sätts upp tillsammans med oss som en del av Corporate: prata med oss om Corporate
Arkitektur
Ett minne i lager
En ny mental funktion för LLM:er: ett externt minne i flera lager som AI skapar och underhåller, delat med människorna som använder det.
Hippocampus ger AI och människor ett delat, välordnat minne. Det är uppbyggt som ett uppslagsverk: komplexa dokument sammanfattas i korta sammandrag med djuplänkar till den text de står för.
Minnet är hypertext, vilket är en kärnkompetens hos LLM:er. LLM:er skapar och underhåller det som en modern wiki, och samma sidor är de som människor bläddrar i och kontrollerar.
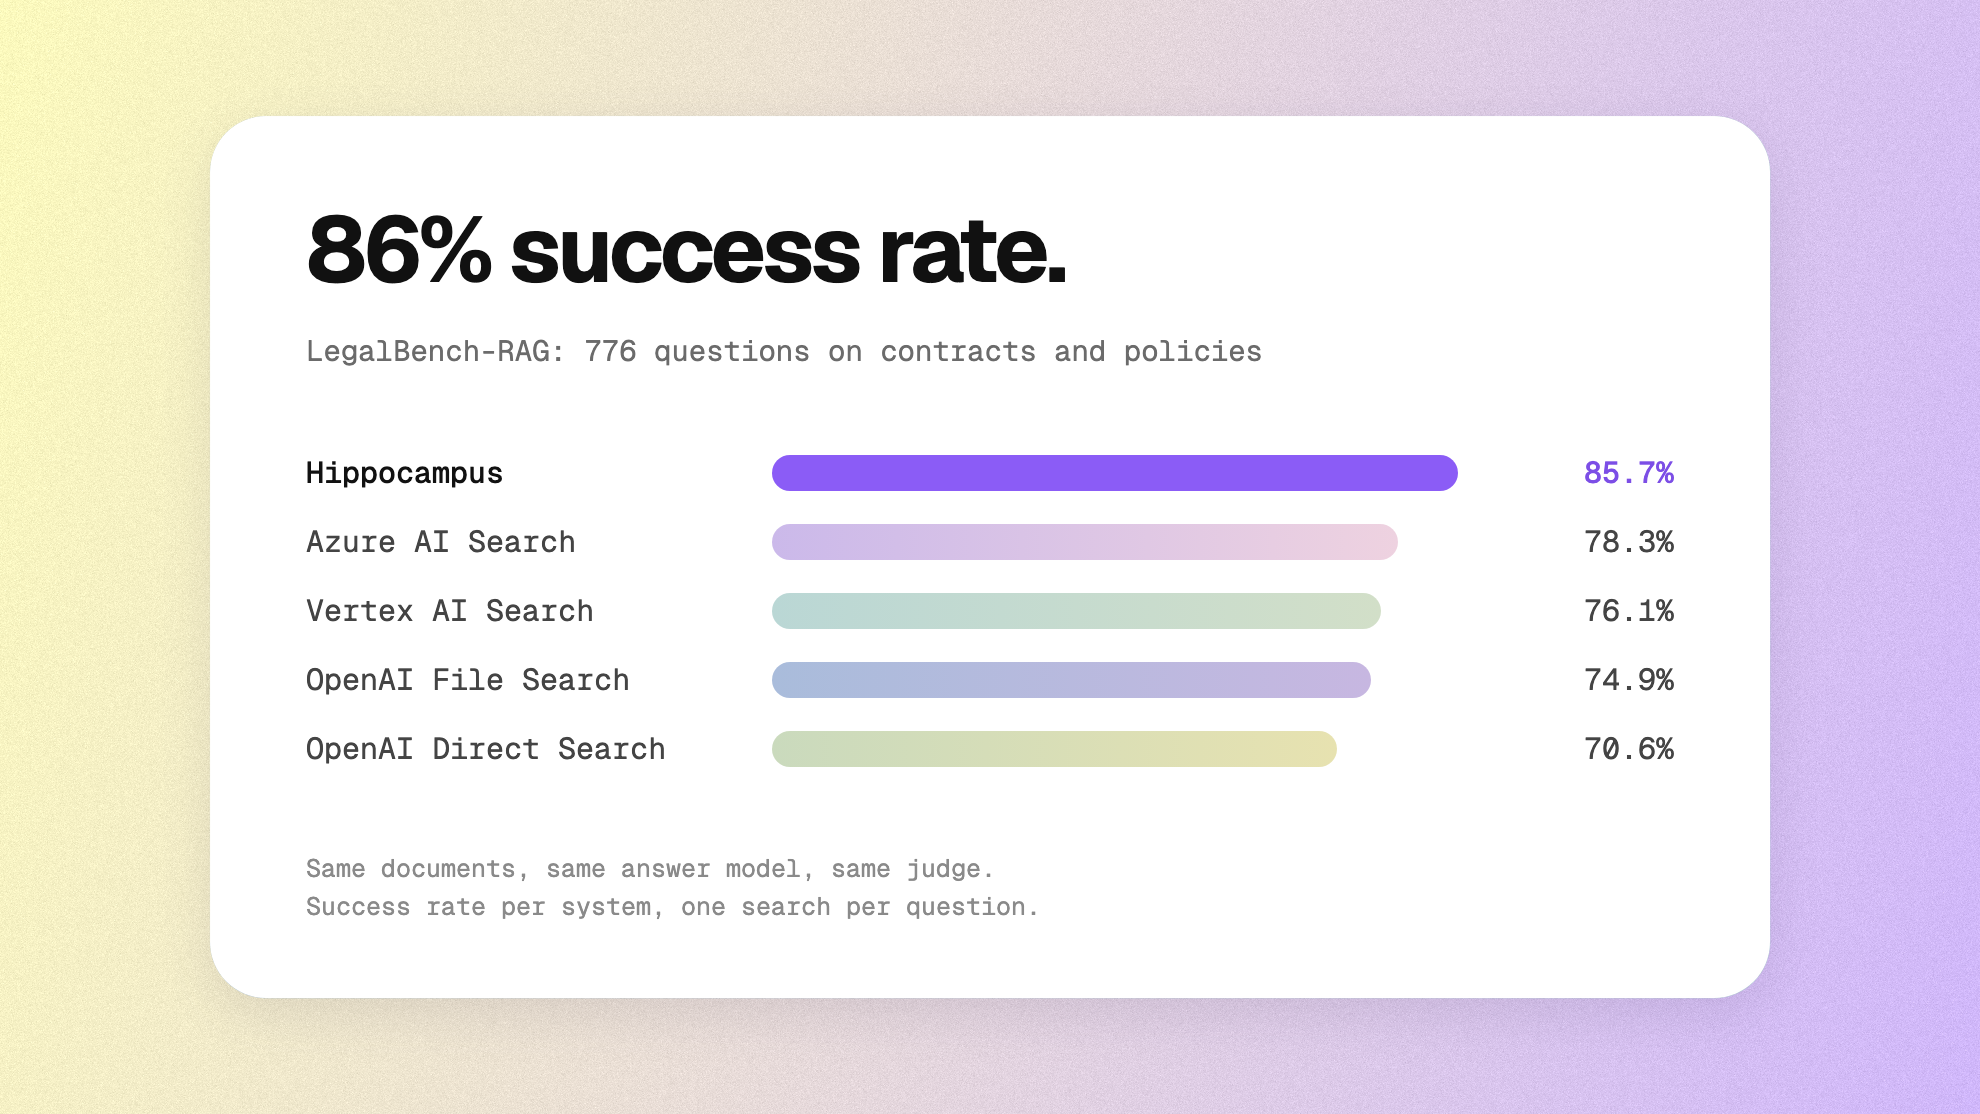
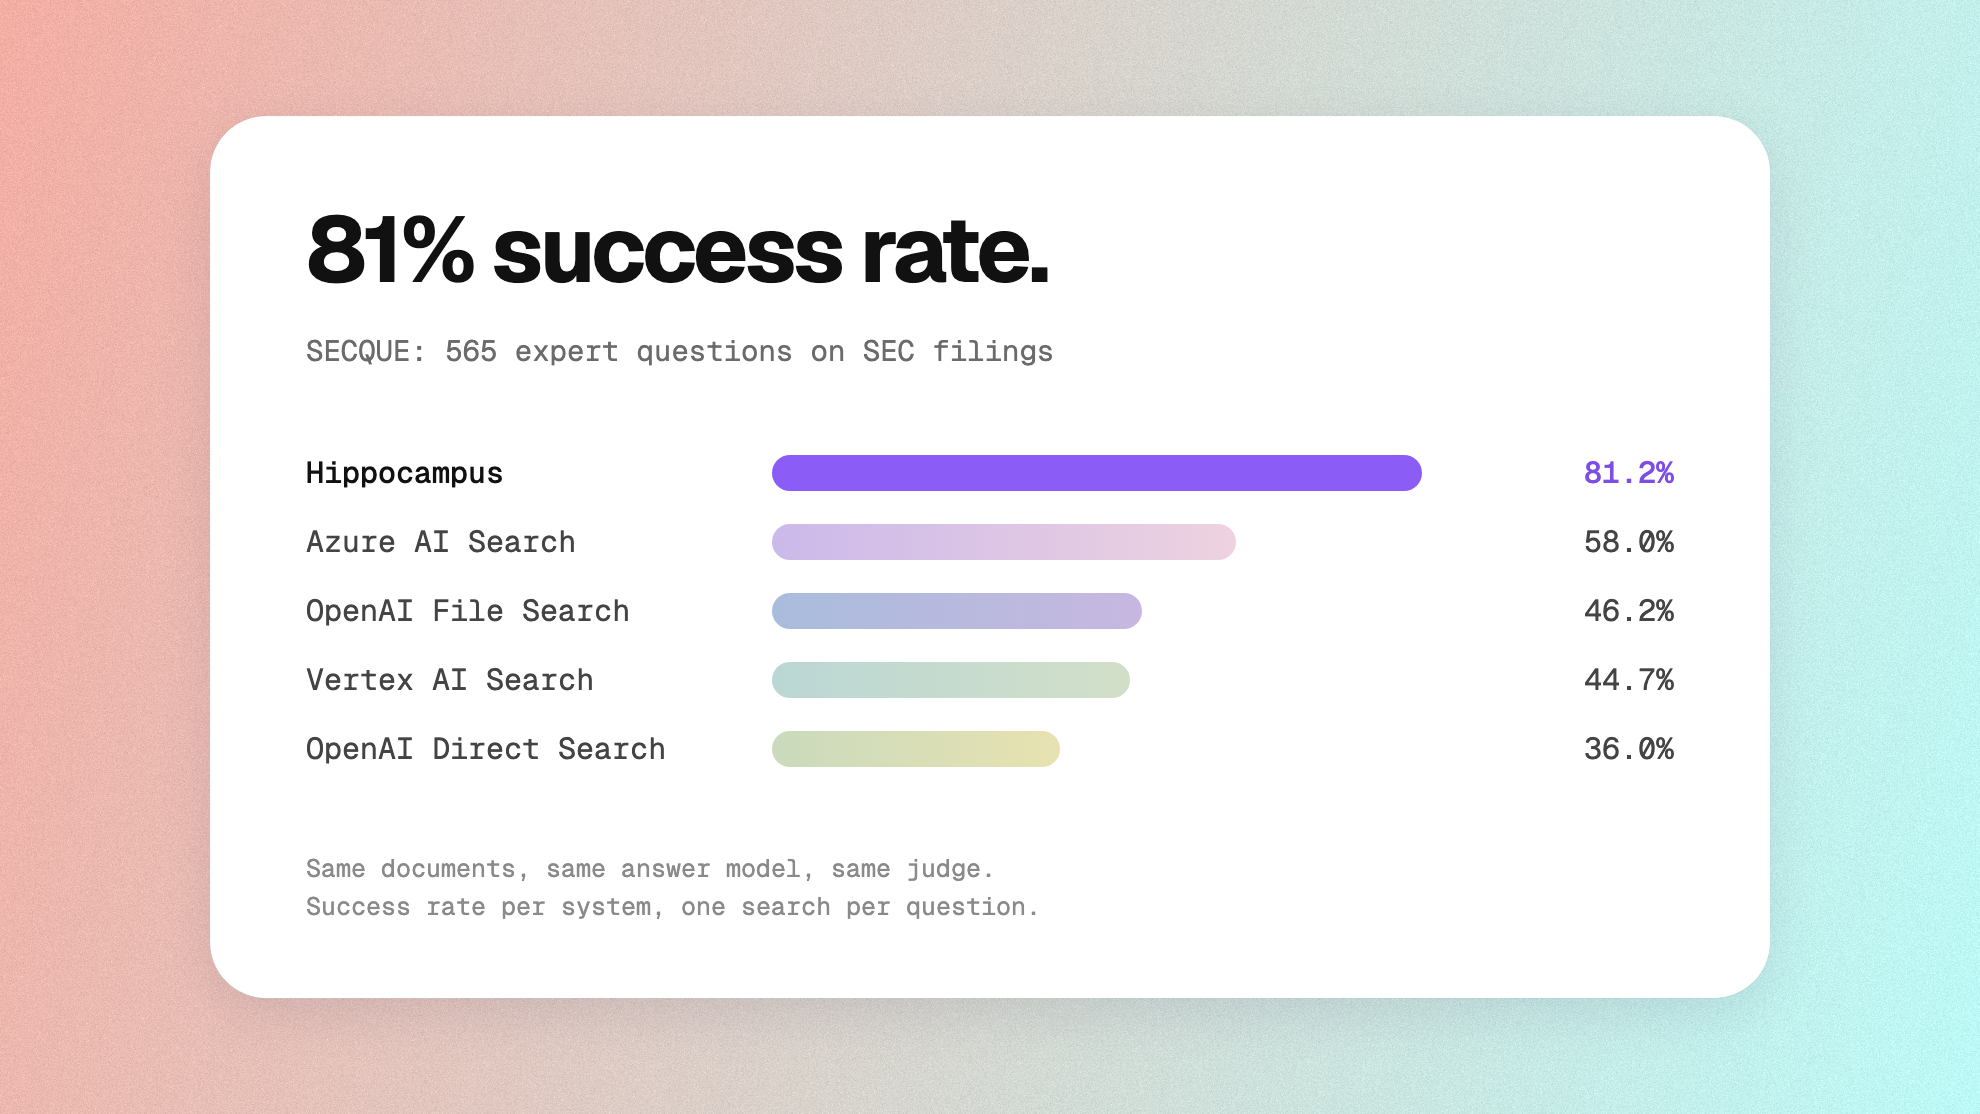
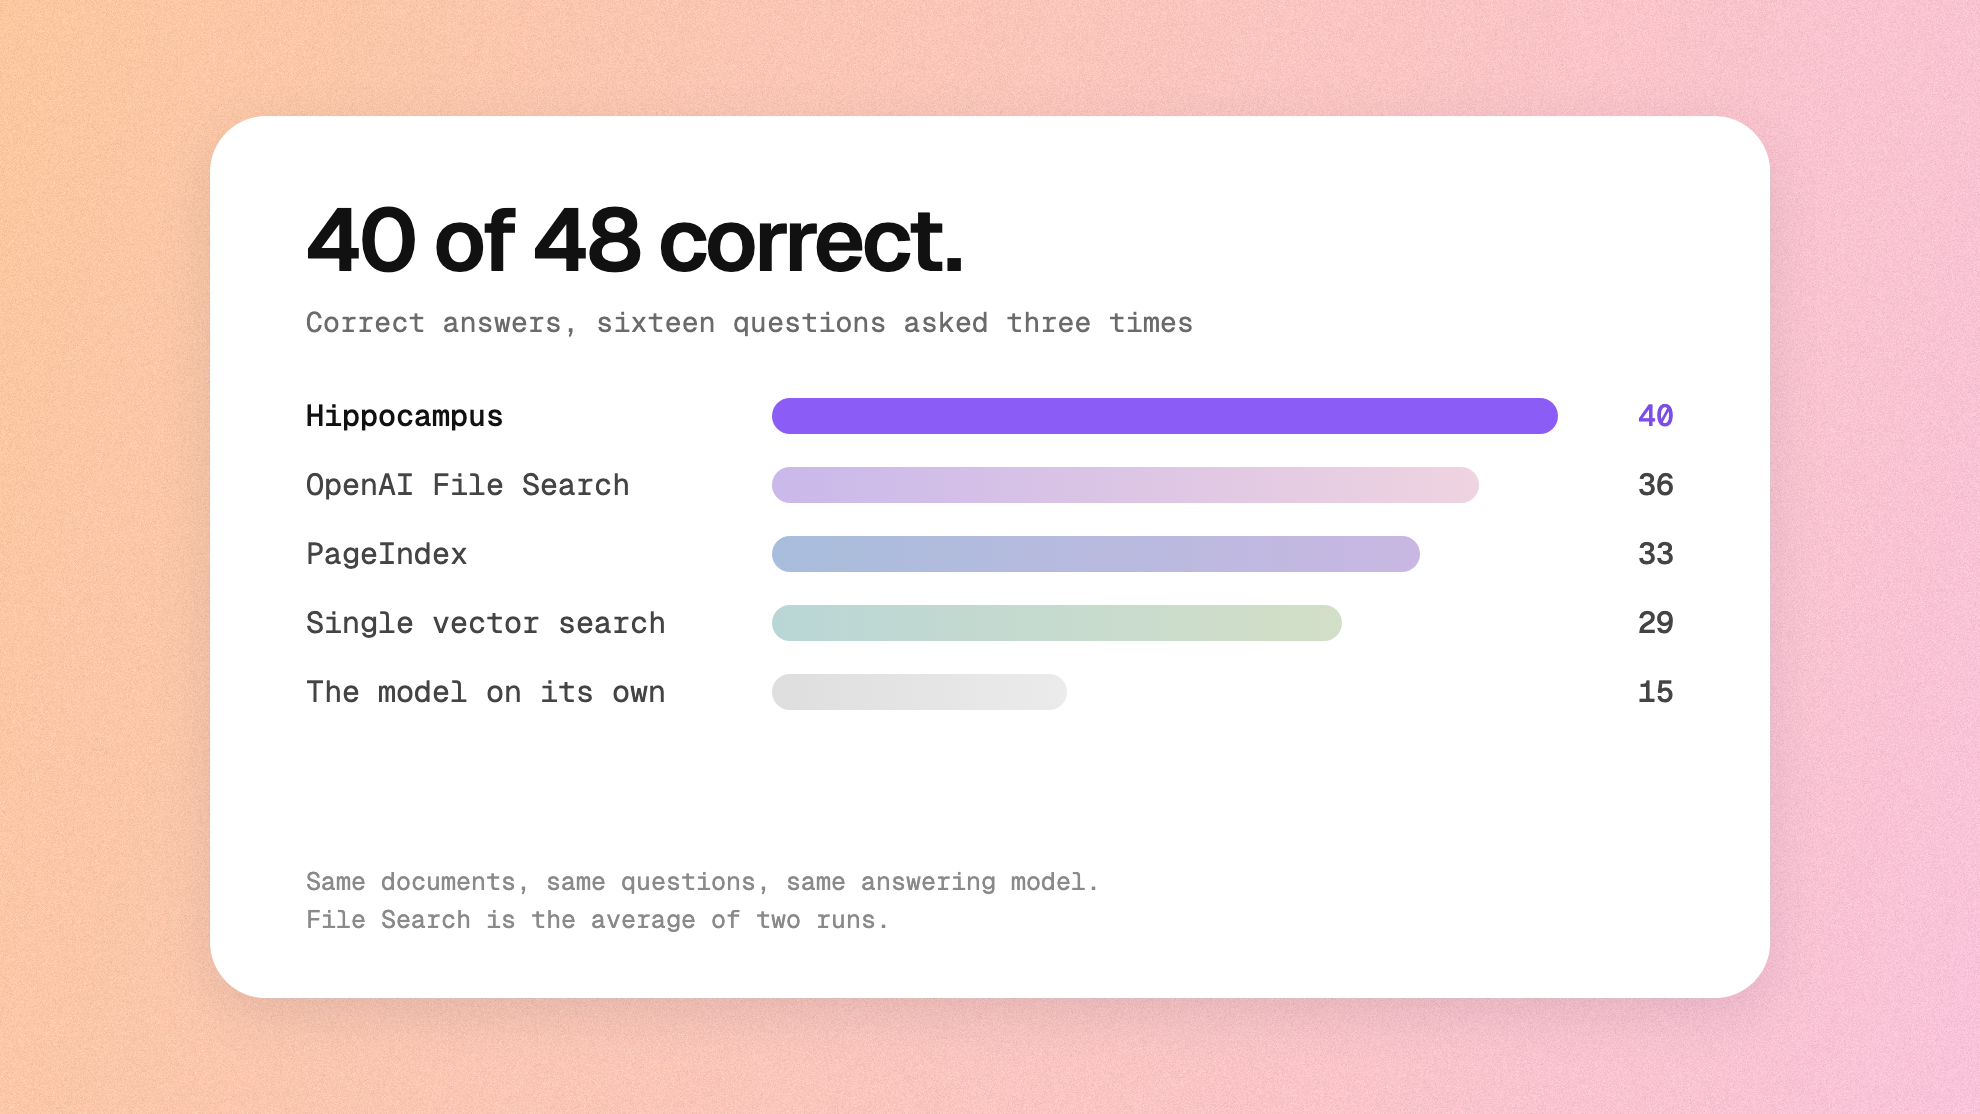
Sökningen utgår från titlar och länkar. Den följer en länk till en sammanfattning när en titel är relevant, och öppnar fulltexten bara för det avsnitt frågan behöver, utan en generativ modell. Modellen får bara det avsnittet, så kontexten förblir liten hur stor korpusen än blir.
- 1 Titlar och länkarEn rad per dokument eller sektion, var och en en länk.
- 2 SummariesKorta abstrakt med djuplänkar in i texten.
- 3 FulltextDokumentet som Markdown, med sina sidor och byteintervall.
Kärnegenskaper
- Skalbar till enorma datamängderModellen får en liten, relevant kontext: bara de avsnitt som spelar roll, hittade av sökningen, i stället för hela korpusen. Korpusens storlek slutar vara gränsen.
- Inbyggd kvalitetskontrollKvalitetskontrollen är en del av minnet, inte ett separat projekt, och varje sammanfattning kan byggas om från källan.
- Öppen från grundenSvaren är spårbara och kontrollerbara: vart och ett leder tillbaka till avsnittet, sidan och originalfilen det kommer från.
- Människa i loopenMänniskor arbetar i samma wiki som AI:n bygger. De bläddrar i den och kontrollerar den, och fall som kräver omdöme skickas till en människa: en kärnfunktion, inte något som lagts till i efterhand.
- Rollbaserad säkerhetÅtkomsten följer roller och behörigheter, så det ett svar bygger på begränsas till det som personen eller agenten som frågar får läsa.
Dokumentträd
Här är sökningen på ett dokument. Två trattar körs över trädet som byggdes vid importen: den ena går nedåt från indexsammanfattningen genom de avsnittssammanfattningar som matchar frågan, den andra söker direkt i lövavsnitten med nyckelord och inbäddningar. Resultaten sammanförs till en enda rankning, utan en generativ modell.
- Personuppgiftsbiträdesavtal index summary · s. 1–14
- 1 Definitions summary · s. 1–2
- 2 Processing summary · s. 3–5
- 3 Säkerhetsåtgärder summary · s. 6–9
- 3.1 Encryption s. 7 byte [18240, 19012) 1
- 3.2 Åtkomstkontroll s. 8 byte [19012, 20330)
- 3.3 Incidents s. 9 byte [20330, 21104)
- 4 Underbiträden summary · s. 10–14
- 4.1 Underbiträden s. 10 byte [26410, 27388) 2
- 1 3.1 Encryption
Nås av båda trattarna: vägen genom 3 Säkerhetsåtgärder och lövsökningen. - 2 4.1 Underbiträden
Bara lövsökning: avsnittet namnger biträdets hostingleverantör.
Import
| Fil | Vad som händer |
|---|---|
.pdf | Textigenkänning med sidmarkörer, så att skannade sidor fungerar. Originalet behålls. |
.docx | Konverteras direkt till Markdown, utan textigenkänning. |
.md · .markdown · .txt · .text | Läses som de är, med sidmarkörer tillagda. Det finns inget PDF-original för dessa. |
En fil som redan har importerats flaggas som dubblett. Förloppet kan strömmas medan dokumentet läses.
Modeller
- Svarsmodeller
- Vilken språkmodell som helst. Du väljer vilken modell som svarar, inställt per arbetsyta; på Corporate kan du använda din egen modellnyckel. I webbchatten kan en person välja modell per fråga. Att byta svarsmodell kräver ingen ny import.
- Embeddings
- Fast per arbetsyta: att byta embeddingmodell skulle ogiltigförklara de lagrade vektorerna, så det erbjuds inte.
- Modellåtkomst
- Ingår i tjänsten. Inget leverantörskonto och ingen leverantörsnyckel att sätta upp.
Open Knowledge Format
Varje dokument lagras som en mapp med Markdown och YAML front matter, enligt specifikationen för Open Knowledge Format: en sammanfattning av hela dokumentet, fulltexten, originalfilen och en mapp per sektion ned till lövsektionerna. Varje dokuments Markdown kan läsas via API:et.
contracts/
└── data-processing-agreement/
    ├── index.md                        sammanfattning av hela dokumentet
    ├── data-processing-agreement.md    fulltext som Markdown
    ├── data-processing-agreement.pdf   originalet (saknas för .md- och .txt-uppladdningar)
    └── 03-security-measures/
        ├── index.md                    sammanfattning av sektionen
└── 03-01-encryption.md en lövsektionAPI-referens
Varje endpoint, parameter och svar beskrivs i en separat API-referens.
API-referens