Jämförelse

Hippocampus vs PageIndex

18 oktober 2026

Av Andreas Dahlström, chef för Deeptech-teamet, medgrundare

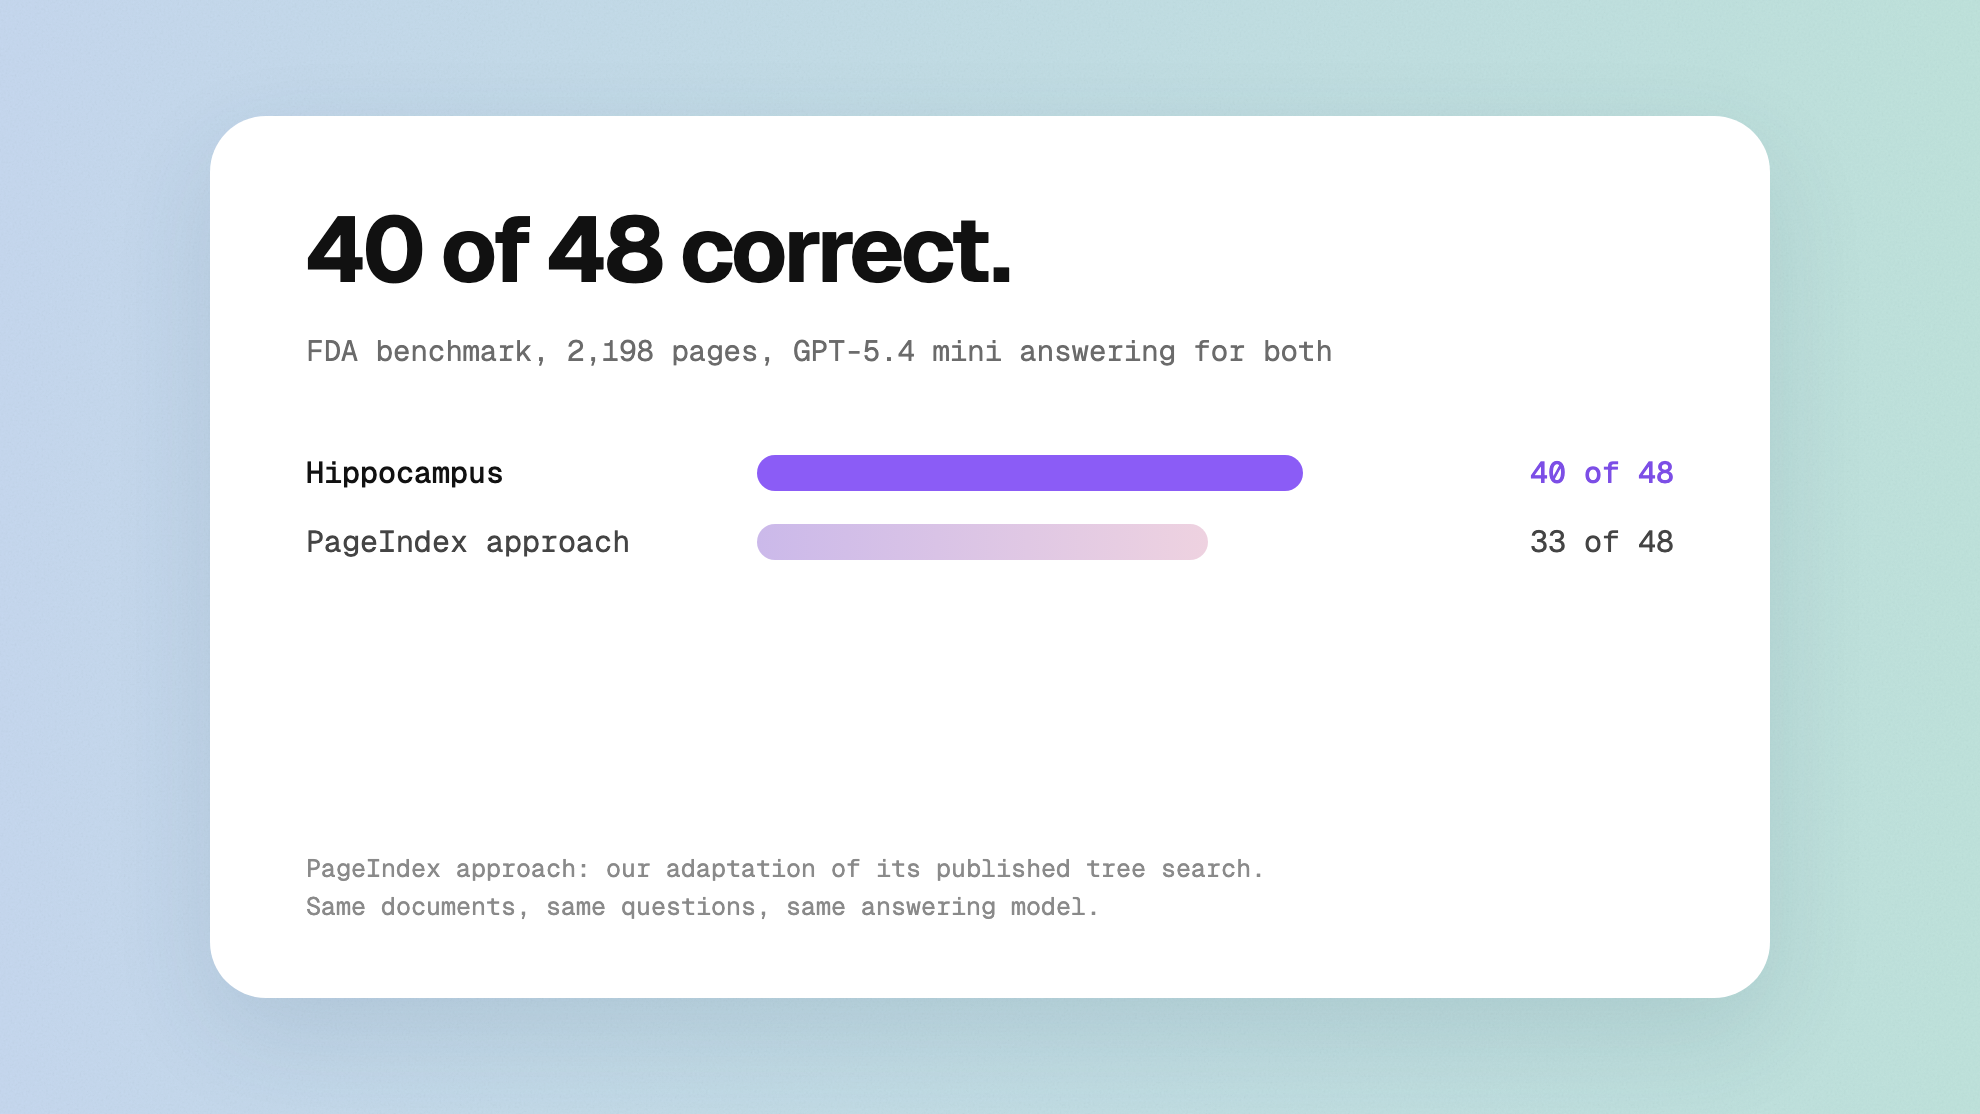
Hippocampus är det bättre valet när du vill ha ett hostat minneslager med lagring i EU, behörigheter som upprätthålls inne i sökningen och källhänvisningar ned till sida och byteintervall. PageIndex är det bättre valet när du vill ha MIT-licensierad kod på din egen maskin med din egen LLM-nyckel, indexering som prissätts per sida utan avgift för hämtning, eller källhänvisningar på blocknivå i PageIndex Cloud. I vår FDA-benchmark, med GPT-5.4 mini som svarsmodell för varje system, svarade Hippocampus rätt på 40 av 48 frågor och vår anpassning av PageIndex-metoden på 33 av 48*; de egna tjänsterna från PageIndex användes inte. PageIndex-uppsättningen var snabbare: en median på 8 sekunder mot 20.

Den här artikeln jämför de två produkterna dimension för dimension. Själva benchmarkkörningen, med fem system sida vid sida och de frågor där de skiljer sig åt, finns i vårt tidigare inlägg Hippocampus mot OpenAI File Search och PageIndex; den här artikeln upprepar den inte. Vi jämför också Hippocampus vs OpenAI File Search och Hippocampus vs Vertex AI Search.

Rubrikbild för Hippocampus och PageIndex jämförda

Sammanfattning

Dimension Hippocampus PageIndex
Driftregion och egen drift Dokument och kunskapsstrukturen lagras krypterade i EU (Finland). Modellinferens körs i USA som standard; på Corporate kan den köras EU-hostad eller i din egen miljö. Drift i eget moln eller helt på egna servrar ingår i Enterprise-paketet. Säkerhet Det lokala läget med öppen källkod (MIT) körs på din egen maskin med din egen LLM-nyckel. Enterprise listar SaaS, dedikerad driftsättning, privat VPC på AWS, Azure eller GCP, och drift på egna servrar, även air-gapped. Namn på hostingregioner: inte dokumenterat. GitHub, Enterprise (kontrollerat i oktober 2026)
Källhänvisning (på sidnivå) Varje svar bär med sig dokumentet, avsnittssökvägen, start- och slutsida, byteoffset och den text som användes. Källhänvisningarna kommer från hämtningssteget, inte från modellen. Det lokala läget hänvisar på sidnivå; Cloud lägger till källhänvisningar på blocknivå med en valfri avgränsningsruta. Chat SDK, Agents SDK (kontrollerat i oktober 2026)
Behörighetskontroll vid frågetillfället Upprätthålls inne i sökningen som ett filter före rangordningen; returnerar ingenting om behörigheterna inte kan kontrolleras. En sammanfattning över flera dokument är synlig bara för personer som får läsa alla. Agenter följer samma behörigheter. Säkerhet Dokumentbehörigheter per användare: inte dokumenterat. Enterprise listar rollbaserad åtkomstkontroll, SSO, arbetsytor för flera användare och revisionsloggar; agentdokumentationen säger att ramverksverktyg behåller åtkomst till hela biblioteket. Enterprise, Agents SDK (kontrollerat i oktober 2026)
Beteende vid frågor som inte går att besvara När hämtningen kommer tillbaka tom avvisas frågan i stället för att gissas. En avvisning kostar lika många krediter som ett svar. Agentprompten i den öppna källkoden säger åt modellen att tala om när dokumenten inte ger svaret. Det är en promptinstruktion; dokumentationen beskriver det inte. agent_tools.py (kontrollerat i oktober 2026)
Hämtningsarkitektur (strukturerat minne, vektorindex eller filsökning) Strukturerat minne som byggs vid import: ett träd per dokument med en indexsammanfattning, avsnittssammanfattningar och lövavsnitt med sidor och byteintervall. Två hämtningstrattar, uppifrån och ned över sammanfattningarna och nedifrån och upp med nyckelords- plus inbäddningssökning över lövavsnitten, sammanslagna till en rangordning. Utvecklare Utan vektorer: ett hierarkiskt trädindex per dokument, där en LLM resonerar över trädet för att hitta och läsa avsnitt. GitHub (kontrollerat i oktober 2026)
Svarsmodeller som stöds Vilken språkmodell som helst. Du väljer vilken modell som svarar, inställt per arbetsyta; på Corporate kan du använda din egen modellnyckel eller låta administratörer välja modellerna. Utvecklare Vilken leverantör som helst: OpenAI, Anthropic, OpenRouter eller valfri OpenAI-kompatibel slutpunkt. Chat SDK, Getting started (kontrollerat i oktober 2026)
Tillgång till API och MCP REST-API och en MCP-server. MCP-servern är i beta; OAuth-inloggning i det delade molnet håller på att färdigställas. API:et på Free är i beta. Utvecklare SDK:er för Python och JavaScript. En hostad MCP-server, endast i Cloud, för dokument som redan är indexerade i Cloud. Referens för REST-slutpunkter: inte dokumenterat. MCP, Getting started (kontrollerat i oktober 2026)
Exportformat för data Open Knowledge Format: en mapp per dokument med Markdown och YAML front matter, som innehåller indexsammanfattningen, hela texten, originalfilen och en mapp per avsnitt. Läsbart via API:et och exporterbart medan kontot är aktivt. Utvecklare Per dokument via SDK:n: trädet som JSON och den extraherade texten som Markdown. Export av hela kontot: inte dokumenterat. Documents SDK, Terms (kontrollerat i oktober 2026)
Användning av kunddata för träning Används aldrig för att träna AI, varken av Thalius eller av modelleverantörerna; deras avtal förbjuder det. Säkerhet Träning på kunddata: inte dokumenterat. Villkoren låter leverantören använda kunddata för att förbättra mjukvaran. Terms, Enterprise (kontrollerat i oktober 2026)
Prismodell och gratisnivå Krediter, samma enhet på varje nivå. Free med krediter som ingår varje månad och utan kort, Starter, och Corporate enligt offert. En avvisning kostar lika mycket som ett svar. Belopp på Priser Cloud är användningsbaserat utan månatligt minimum: 0,01 USD per indexerad sida, en gång, 0,001 USD per aktiv sida och månad där de första 1 000 är gratis, inga avgifter för hämtning, LLM-inferens ingår inte. 10 USD i gratiskrediter, inget kort. Det lokala läget är gratis; Enterprise säljs via säljteamet. Pricing (kontrollerat i oktober 2026)

Benchmark

Tio offentliga FDA-dokument för Saxenda, Wegovy och Zepbound (2 198 sidor), sexton frågor skrivna av Atrogis team, var och en ställd tre gånger i oberoende konversationer. Varje system svarade via samma modell, GPT-5.4 mini, den 17 september 2026. En bedömningsmodell, GPT-5 med tre röster och majoritetsbeslut, jämförde varje svar med ett referenssvar; att avböja kontrollfrågan räknas som korrekt.

  • Hippocampus: 40 av 48 rätt*, 79 % viktat, median 20 sekunder per svar.
  • PageIndex-metoden, vår anpassning: 33 av 48 rätt*, 65 % viktat, median 8 sekunder per svar.

PageIndex-raden är vår anpassning av den trädsökning som PageIndex har publicerat: ett steg, upp till sex avsnitt, 12 000 tecken per avsnitt. De egna hämtnings- och chattjänsterna från PageIndex användes inte. De gränserna kan missgynna svar som är spridda över många avsnitt eller ligger i långa tabeller.

Den viktade poängen räknar lätta frågor en gång, medelsvåra två gånger och svåra tre gånger. På kontrollfrågan, som dokumenten inte kan besvara, avböjde PageIndex-uppsättningen varje gång; Hippocampus sa varje gång att dokumenten inte kan stödja en rangordning, och erbjöd i två av tre svar godkännandeordningen som ett uttryckligen markerat närmevärde.

Det här resultatet visar inte:

  • Gapet mellan de två översta systemen i hela tabellen, Hippocampus med 40 och OpenAI File Search med 36 i genomsnitt, ligger inom variationen mellan körningar.
  • Hippocampus-konfigurationer som testades 16 till 17 september fick mellan 37 och 40 av 48. Siffran ovan är en körning som fick 40.
  • Sökguiden som Hippocampus ger modellen förfinades på samma sexton frågor. De andra systemen kördes med leverantörernas standardinställningar plus en instruktion på en mening att bara svara utifrån materialet.
  • File Search kördes två gånger. De andra systemen, PageIndex inräknat, kördes en gång, så skillnader på några få svar kan bero enbart på variation.
  • Hippocampus är det långsammaste testade systemet: en median på 20 sekunder per svar mot 5 till 8 sekunder för de andra. Det här är tider för ett helt svar, där modellen söker så ofta den behöver. En enskild sökning i Hippocampus tar 1,8 sekunder i median i vår senare benchmarkrapport.
  • Bedömningsmodellen är OpenAI:s GPT-5, och svarsmodellen och två av de testade systemen är också OpenAI:s.

Hela tabellen med alla fem system finns i Hippocampus mot OpenAI File Search och PageIndex. Korpusen, frågorna och resultaten med tre svarsmodeller finns i FDA GLP-1-benchmarken, och varje publicerat resultat finns på sidan Bevis.

* Svarsmodell GPT-5.4 mini för varje system. Bedömning av GPT-5, tre röster, majoritetsbeslut. Thalius utvärdering, 17 september 2026.

När PageIndex är det bättre valet

  • Du vill ha kod med öppen källkod som du själv kontrollerar: det lokala läget är MIT-licensierat, körs på din egen maskin med din egen LLM-nyckel, och Enterprise lägger till privat VPC och air-gapped drift på egna servrar (GitHub, Enterprise, kontrollerat i oktober 2026).
  • Du vill betala för indexering, inte för hämtning: Cloud tar betalt per indexerad sida och per aktiv sida, utan avgifter för hämtning, och du tar med valfri OpenAI-kompatibel LLM (Pricing, Chat SDK, kontrollerat i oktober 2026).
  • Du behöver källhänvisningar som pekar in i sidan: Cloud returnerar källhänvisningar på blocknivå med en valfri avgränsningsruta, och erbjuder en hostad MCP-server och SDK:er för agentramverk (Agents SDK, MCP, kontrollerat i oktober 2026).
  • Hastighet betyder mer än djup: i vår FDA-benchmark svarade PageIndex-uppsättningen med en median på 8 sekunder mot 20 för Hippocampus, och avböjde kontrollfrågan varje gång.

Prova Hippocampus på samma dokument

Ladda upp de dokument du skulle indexera i PageIndex och ställ samma frågor till Hippocampus, och jämför sedan källhänvisningarna sida vid sida. Börja gratis, inget kort. Läs först hur Hippocampus upprätthåller behörigheter och var dokumenten lagras, API:et, MCP-servern och exportformatet, hur krediter fungerar på varje nivå och drift i eget moln eller på egna servrar med Enterprise-paketet.

Källor och senaste uppdatering

Senast uppdaterad: oktober 2026.

Frågor

Vanliga frågor

Är PageIndex öppen källkod?

Ja: PageIndex lokala läge är MIT-licensierat och körs på din egen maskin med din egen LLM-nyckel (kontrollerat i oktober 2026). PageIndex Cloud och dess Enterprise-driftsättningar är hostade eller säljledda erbjudanden. Hippocampus körs i Thalius EU-moln, eller i ditt eget moln eller helt på egna servrar som en del av Enterprise-paketet.

Använder Hippocampus inbäddningar, och gör PageIndex det?

Hippocampus gör det, vid sidan av struktur: det bygger ett träd per dokument och slår samman en väg uppifrån och ned över sammanfattningarna med nyckelords- plus inbäddningssökning över lövavsnitten. PageIndex beskriver sig som vektorlöst: en LLM resonerar över ett trädindex per dokument (kontrollerat i oktober 2026).

Vilka svarsmodeller kan jag använda?

Båda fungerar med mer än en leverantör. PageIndex fungerar med OpenAI, Anthropic, OpenRouter eller valfri OpenAI-kompatibel slutpunkt, och LLM-inferens faktureras separat (kontrollerat i oktober 2026). Hippocampus fungerar med vilken språkmodell som helst: du väljer vilken modell som svarar, inställt per arbetsyta, och på Corporate kan du använda din egen modellnyckel.

Vilken ger mest exakta källhänvisningar?

Det beror på läget: PageIndex Cloud hänvisar på blocknivå med en valfri avgränsningsruta, och det lokala läget på sidnivå (kontrollerat i oktober 2026). Hippocampus hänvisar till dokumentet, avsnittssökvägen, start- och slutsida och byteoffset, med den text som användes.

Testades PageIndex egen tjänst i benchmarken?

Nej: vår FDA-benchmark använde vår anpassning av PageIndex publicerade trädsökningsmetod, inte PageIndex egna hämtnings- och chattjänster. Den uppsättningen fick 33 av 48 mot 40 av 48 för Hippocampus, med GPT-5.4 mini som svarsmodell för varje system den 17 september 2026.