Testet
FinanceBench, från Patronus AI, ställer 150 analytikerfrågor om amerikanska börsbolag: siffror, nyckeltal och bedömningar. Svaren finns i 84 års-, kvartals- och händelserapporter (10-K, 10-Q, 8-K), och varje fråga anger sitt dokument. Det är ett av testerna i vår benchmarkrapport, version 3.1, daterad 20 oktober 2026.
Så läser du siffrorna
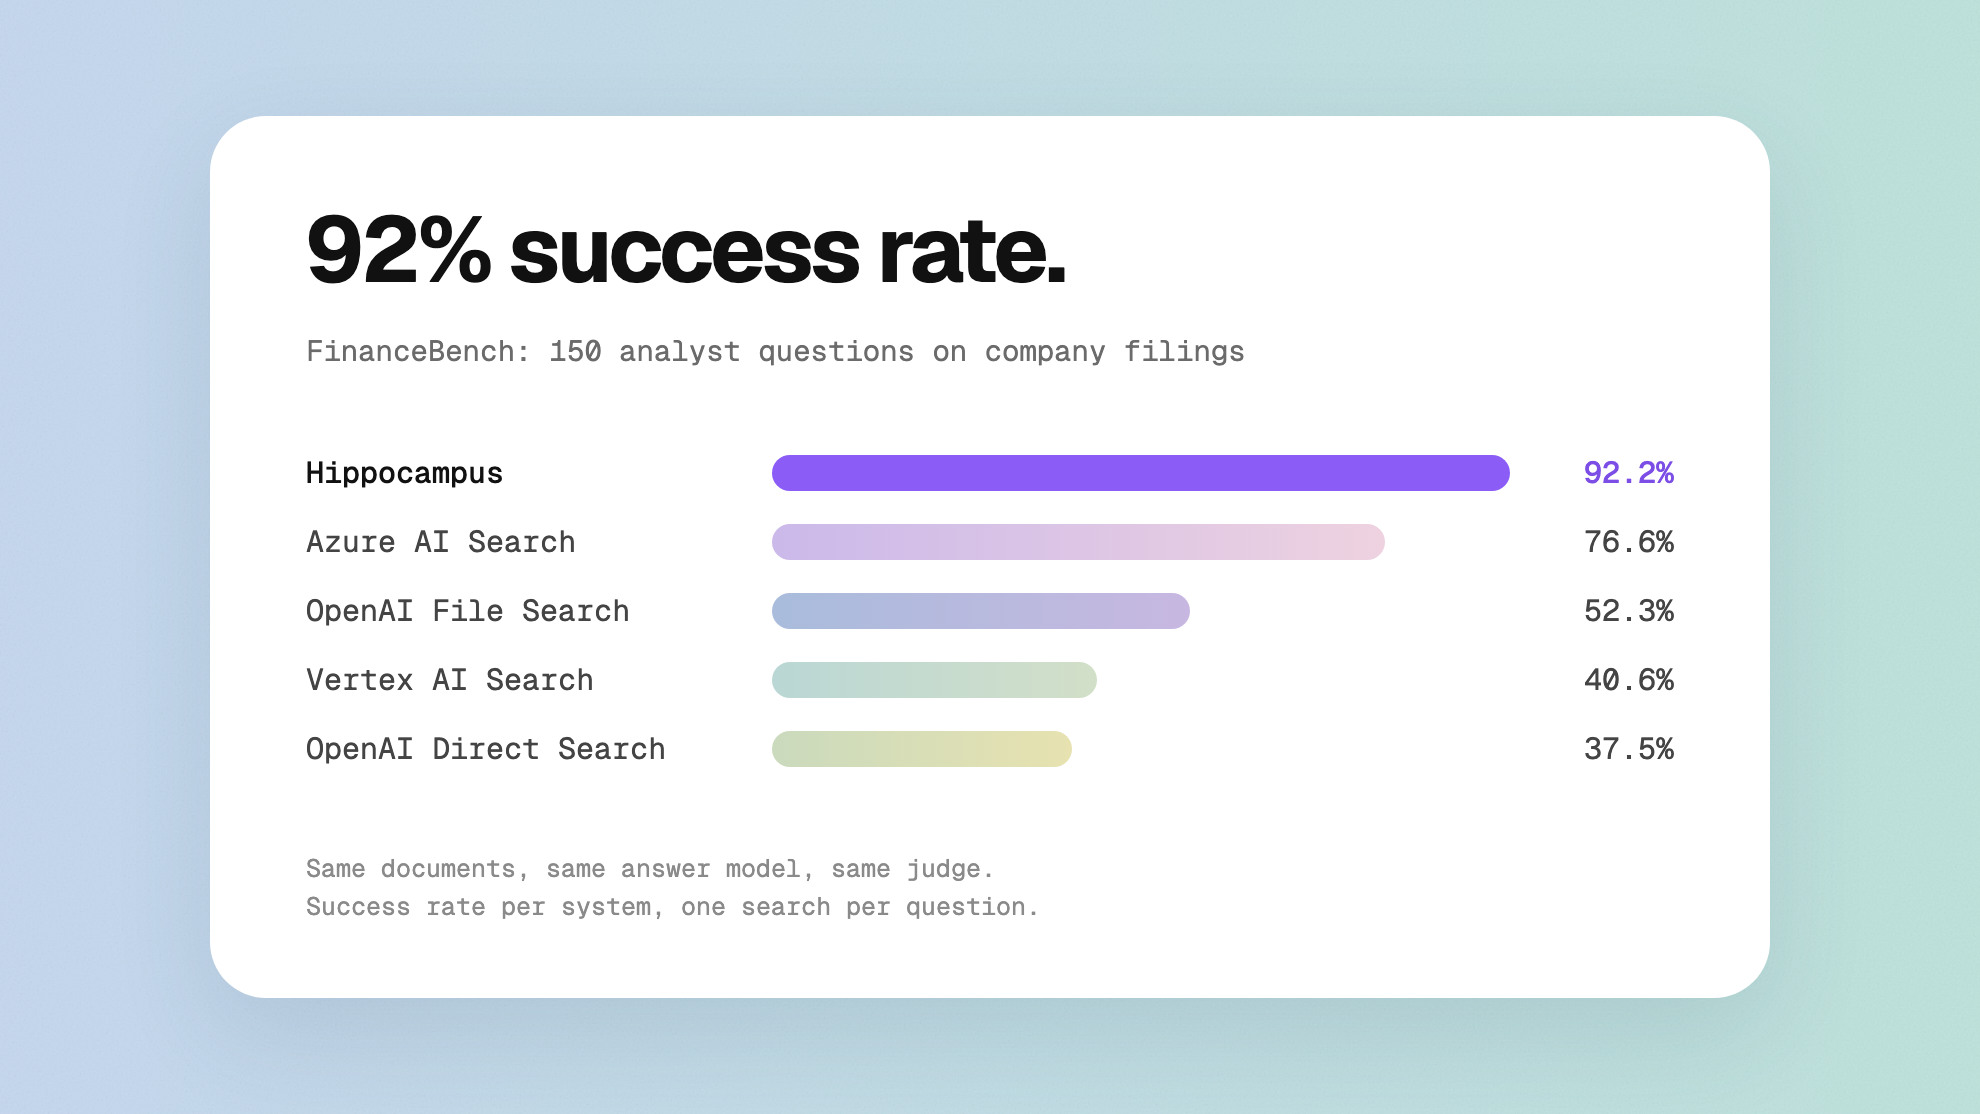
- Framgångsgrad: av de frågor som en perfekt sökning skulle lösa, den andel varje system löser. En perfekt sökning är här svarsmodellen när den får varje frågas egna underlagssidor; de frågor den ändå missar (ett felaktigt referenssvar, en tvetydig fråga eller en fråga som är för svår även med rätt sidor) räknas bort.
- Rätt besvarade (alla frågor): varje fråga räknas, ingenting filtreras bort. Ett svar är rätt när domaren bedömer att det stämmer med datasetets referenssvar. Hippocampus 86 %, Azure AI Search 70 %.
- Hittat underlag: den andel av de nödvändiga avsnitten som sökningen hittade, i genomsnitt.
- Som jämförelse: utan dokument svarar svarsmodellen rätt på 40,7 % ur minnet. Med rätt sidor svarar den rätt på 85,3 %.
Resultat
| System |
Framgångsgrad |
Rätt besvarade (alla frågor) |
Hittat underlag |
| Hippocampus |
92,2 % |
86,0 % |
85 % |
| Azure AI Search |
76,6 % |
70,0 % |
58 % |
| OpenAI File Search |
52,3 % |
48,7 % |
35 % |
| Vertex AI Search |
40,6 % |
37,3 % |
24 % |
| OpenAI Direct Search |
37,5 % |
32,7 % |
23 % |
- Direkt jämförelse mot Hippocampus: Azure AI Search 29 : 5 (p < 10⁻⁴), OpenAI File Search 60 : 4 (p < 10⁻¹³), Vertex AI Search 76 : 3 (p < 10⁻¹⁸), OpenAI Direct Search 82 : 2 (p < 10⁻²¹). Varje par anger de frågor som Hippocampus besvarade rätt och det andra systemet inte, mot det omvända (tvåsidigt teckentest).
Vertex AI Search och OpenAI Direct Search hamnar under nivån utan dokument: med svaga sökresultat avböjer modellen oftare i stället för att gissa. Vissa referenssvar väljer en av flera vedertagna formler eller en tolkning av en vag fråga; omkring 7 % av frågorna (10 av 150) är omtvistade.
Våra missar
En automatiserad granskning gick igenom de 21 frågor som Hippocampus inte besvarade rätt: 9 verkliga missar, 8 tvetydiga frågor, 4 referensproblem och inga som var rätt men mindre fullständiga. Verkliga missar utgör 6 % av alla frågor. Granskningen är ett stöd för att tolka missarna, inte en mänsklig bedömning.
Hastighet
Hippocampus är mest träffsäkert här, inte snabbast. I median tar en sökning 1,8 sekunder i Hippocampus, 0,4 sekunder i Azure AI Search, 0,3 sekunder i Vertex AI Search och 1,7 sekunder i OpenAI Direct Search. Tiderna kommer från version 2.4 av rapporten och gäller enbart sökningen.
För ett enkelt svar i ett tydligt avgränsat dokument räcker en snabb molnsökning ofta. När dokumenten liknar varandra, ett svar kräver flera avsnitt eller ett misstag är kostsamt, ger den extra tiden ett annat resultat.
Så testade vi
Varje system indexerade samma filer och gjorde en sökning per fråga. Samma svarsmodell (GPT-5.4 mini) och samma domare (Claude Sonnet 5) hanterade varje svar. Alla inställningar och promptar finns på sidan Bevis under fliken Finans.
Datasetet
FinanceBench (den öppna delmängden med 150 frågor) kommer från Patronus AI, på github.com/patronus-ai/financebench, under licensen CC BY-NC 4.0. Vi använder det som det är publicerat och redovisar enbart resultat: ingen fråga, inget svar och inget avsnitt återges här.