Testet
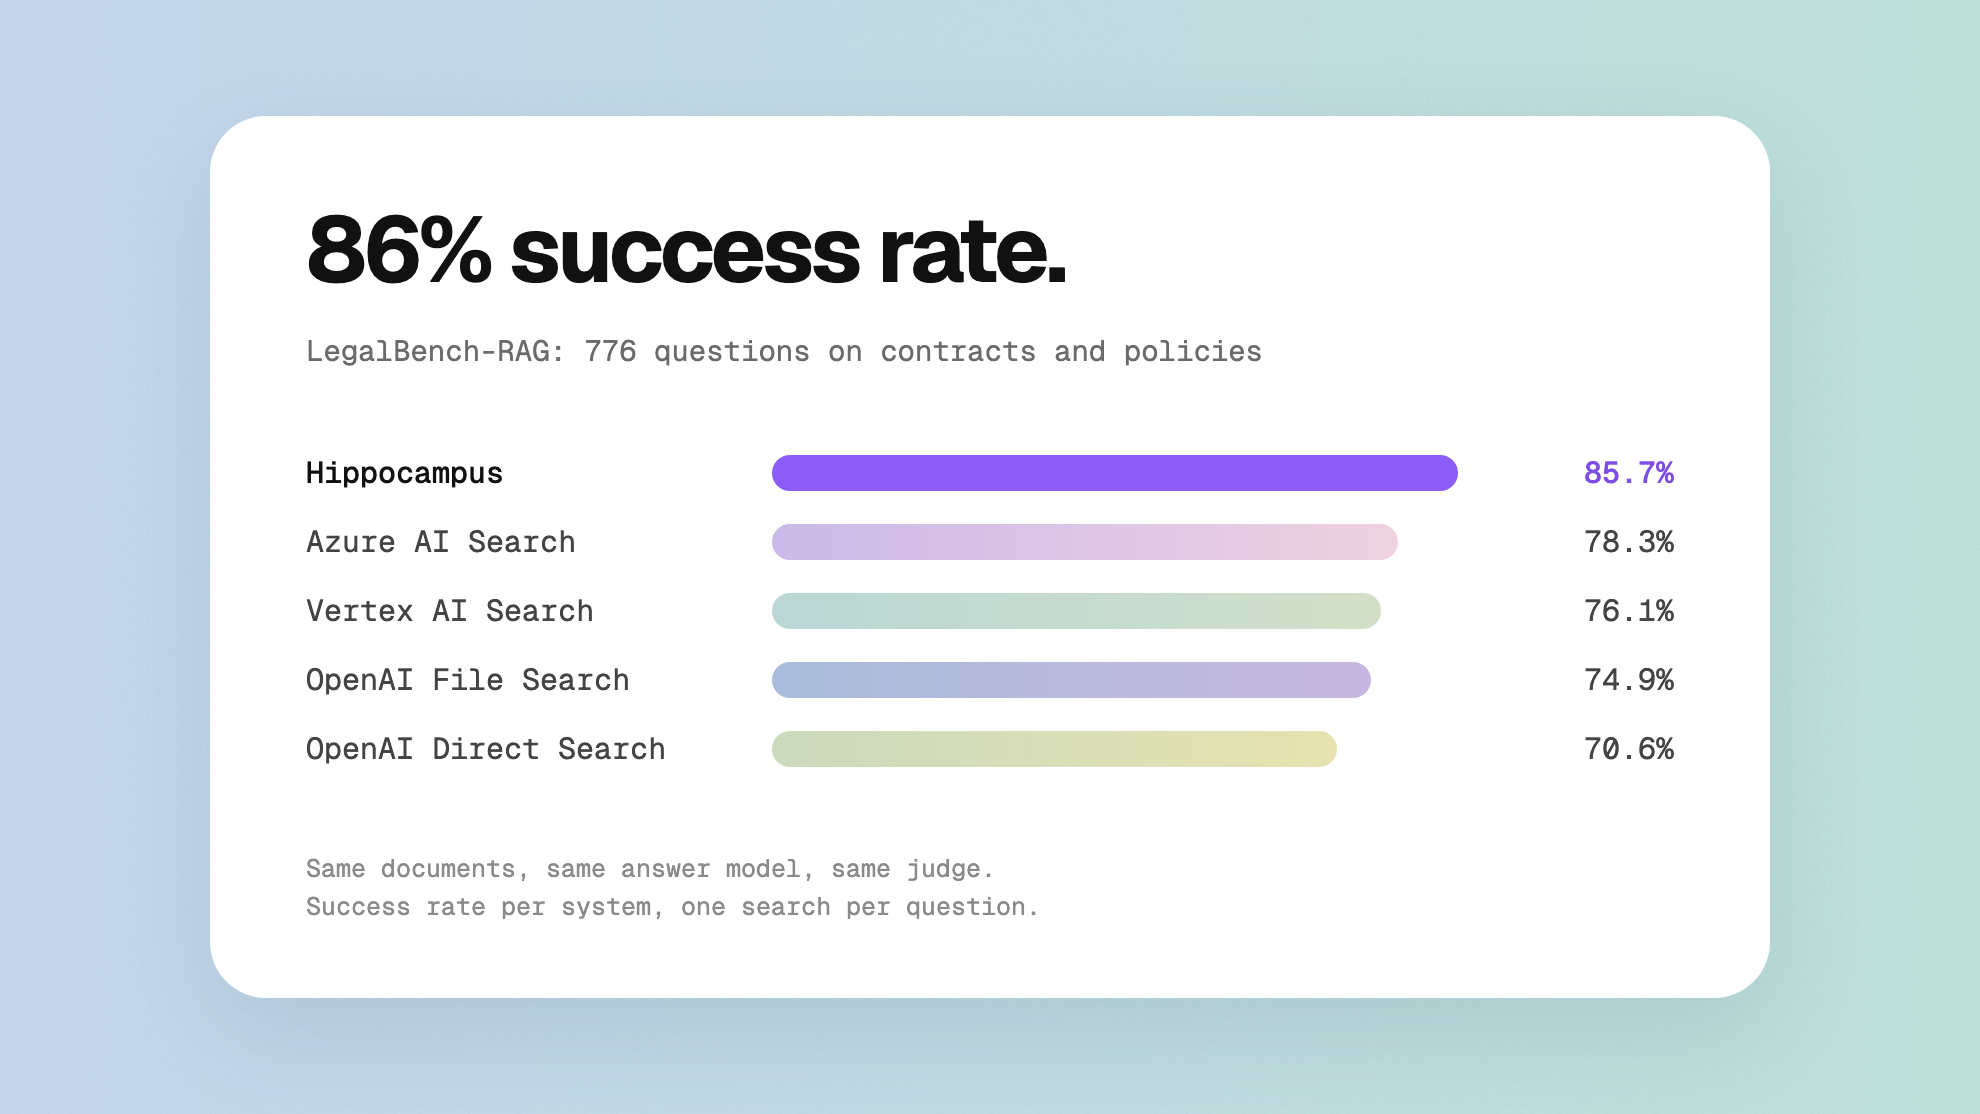
LegalBench-RAG, från ZeroEntropy, efterfrågar den klausul som besvarar en fråga om ett specifikt avtal eller en specifik policy: sekretessavtal, fusionsavtal, kommersiella avtal, integritetspolicyer. Vi körde dess mini-urval: 776 frågor om 72 dokument som ofta liknar varandra. Det är ett av testerna i vår benchmarkrapport, version 3.1, daterad 20 oktober 2026.
Så läser du siffrorna
- Framgångsgrad: av de frågor som en perfekt sökning skulle lösa, den andel som varje system löser. En perfekt sökning är här svarsmodellen när den får varje frågas egna underlagssidor; de frågor den ändå missar (ett felaktigt referenssvar, en tvetydig fråga eller en fråga som är för svår även med rätt sidor) räknas bort.
- Rätt besvarade (alla frågor): varje fråga räknas, inget filtreras bort. Ett svar är rätt när domaren bedömer att det stämmer med datasetets referenssvar. Hippocampus 82 %, Azure AI Search 75 %.
- Hittat underlag: den andel av de nödvändiga avsnitten som sökningen hittade, i genomsnitt.
- Som jämförelse: utan dokument får svarsmodellen 28,2 % rätt ur minnet. Med rätt sidor får den 92,0 % rätt.
Resultat
| System |
Framgångsgrad |
Rätt besvarade (alla frågor) |
Hittat underlag |
| Hippocampus |
85,7 % |
81,8 % |
86 % |
| Azure AI Search |
78,3 % |
74,5 % |
75 % |
| Vertex AI Search |
76,1 % |
72,6 % |
74 % |
| OpenAI File Search |
74,9 % |
71,1 % |
72 % |
| OpenAI Direct Search |
70,6 % |
67,1 % |
65 % |
- Direkt jämförelse mot Hippocampus: Azure AI Search 102 : 45 (p < 10⁻⁵), Vertex AI Search 125 : 53 (p < 10⁻⁷), OpenAI File Search 134 : 51 (p < 10⁻⁹), OpenAI Direct Search 149 : 35 (p < 10⁻¹⁷). Varje par är de frågor som Hippocampus besvarade rätt och det andra systemet inte, mot det omvända (tvåsidigt teckentest).
Referensen är ett avsnitt snarare än ett kort svar, så ett svar som är formulerat annorlunda än klausulen kan gå miste om poäng; omkring 3 % av frågorna (20 av 776) är omtvistade.
Vertex AI Search och citattecken. Vertex AI Search tolkar dubbla citattecken som en operator för exakt fras, och LegalBench-RAG sätter parternas namn inom citattecken. När frågorna skickades som de var skrivna returnerade 347 av de 373 frågorna med citattecken inget avsnitt, och Vertex AI Search besvarade 37 % av alla frågor rätt. De andra systemen returnerade avsnitt för varenda en. Enbart för Vertex AI Search tog vi bort citattecknen ur sökfrågan, vilket ger dess siffror i tabellen. Svarssteget såg varje fråga som den var skriven.
Våra missar
En automatiserad granskning gick igenom de 141 frågor som Hippocampus inte besvarade rätt: 88 verkliga missar, 4 tvetydiga frågor, 27 referensproblem och 22 som var rätt men mindre fullständiga än referensen. Verkliga missar utgör 11 % av alla frågor. Granskningen är ett stöd för att tolka missarna, inte en mänsklig bedömning.
Hastighet
Hippocampus är mest träffsäkert här, inte snabbast. I median tar en sökning 1,8 sekunder i Hippocampus, 0,4 sekunder i Azure AI Search, 0,3 sekunder i Vertex AI Search och 1,7 sekunder i OpenAI Direct Search. Tiderna kommer från version 2.4 av rapporten och avser enbart sökningen.
På avtal ligger systemen närmare varandra än på de finansiella rapporterna, och försprånget är ändå tydligt mot vart och ett av dem. När dokument liknar varandra, som avtal av samma slag gör, ger den extra tiden ett annat resultat.
Så testade vi
Varje system indexerade samma filer och gjorde en sökning per fråga. Samma svarsmodell (GPT-5.4 mini) och samma domare (Claude Sonnet 5) hanterade varje svar. De fullständiga inställningarna och promptarna finns på sidan Bevis under fliken Juridik.
Datasetet
LegalBench-RAG (mini-urvalet) kommer från ZeroEntropy, på github.com/zeroentropy-ai/legalbenchrag, under MIT-licensen. Vi använder det som det är publicerat och redovisar enbart resultat: ingen fråga, inget svar och inget avsnitt återges här.