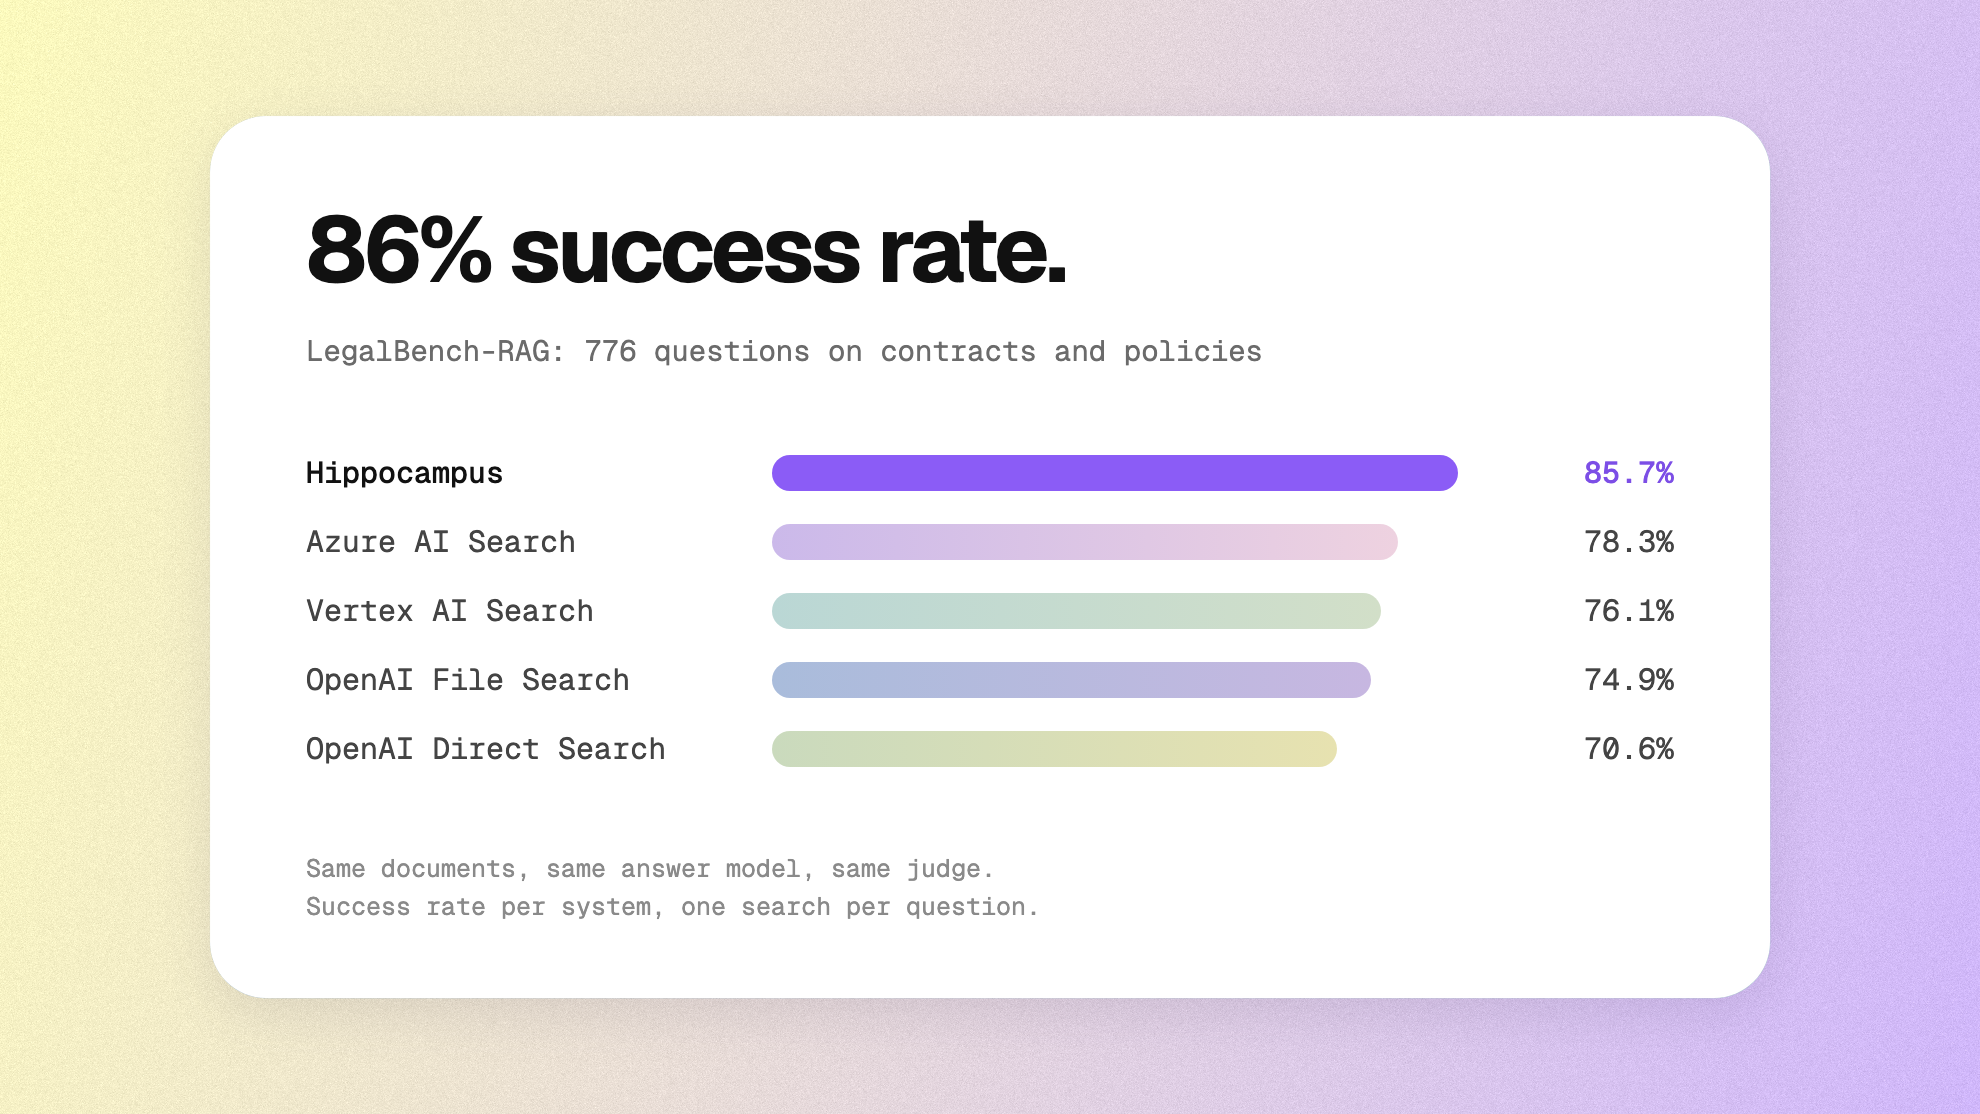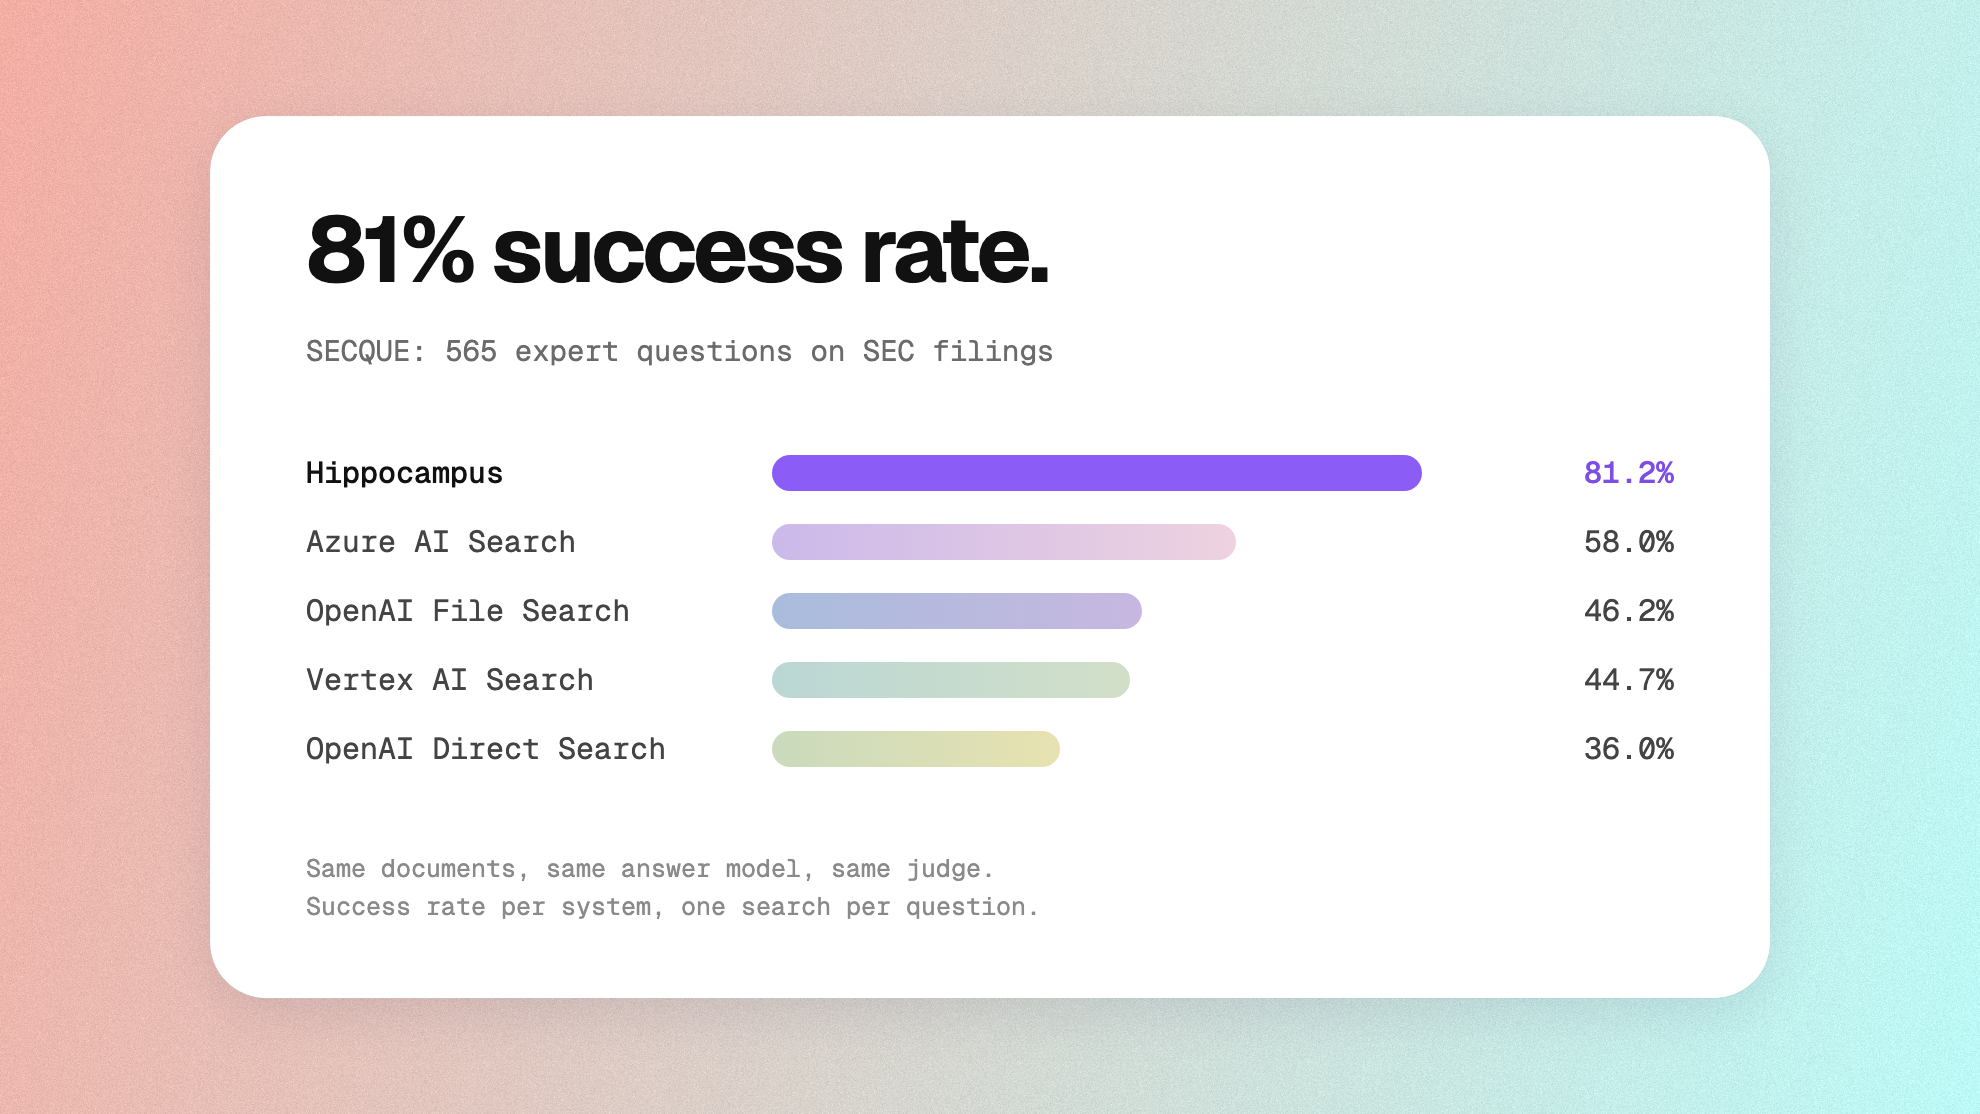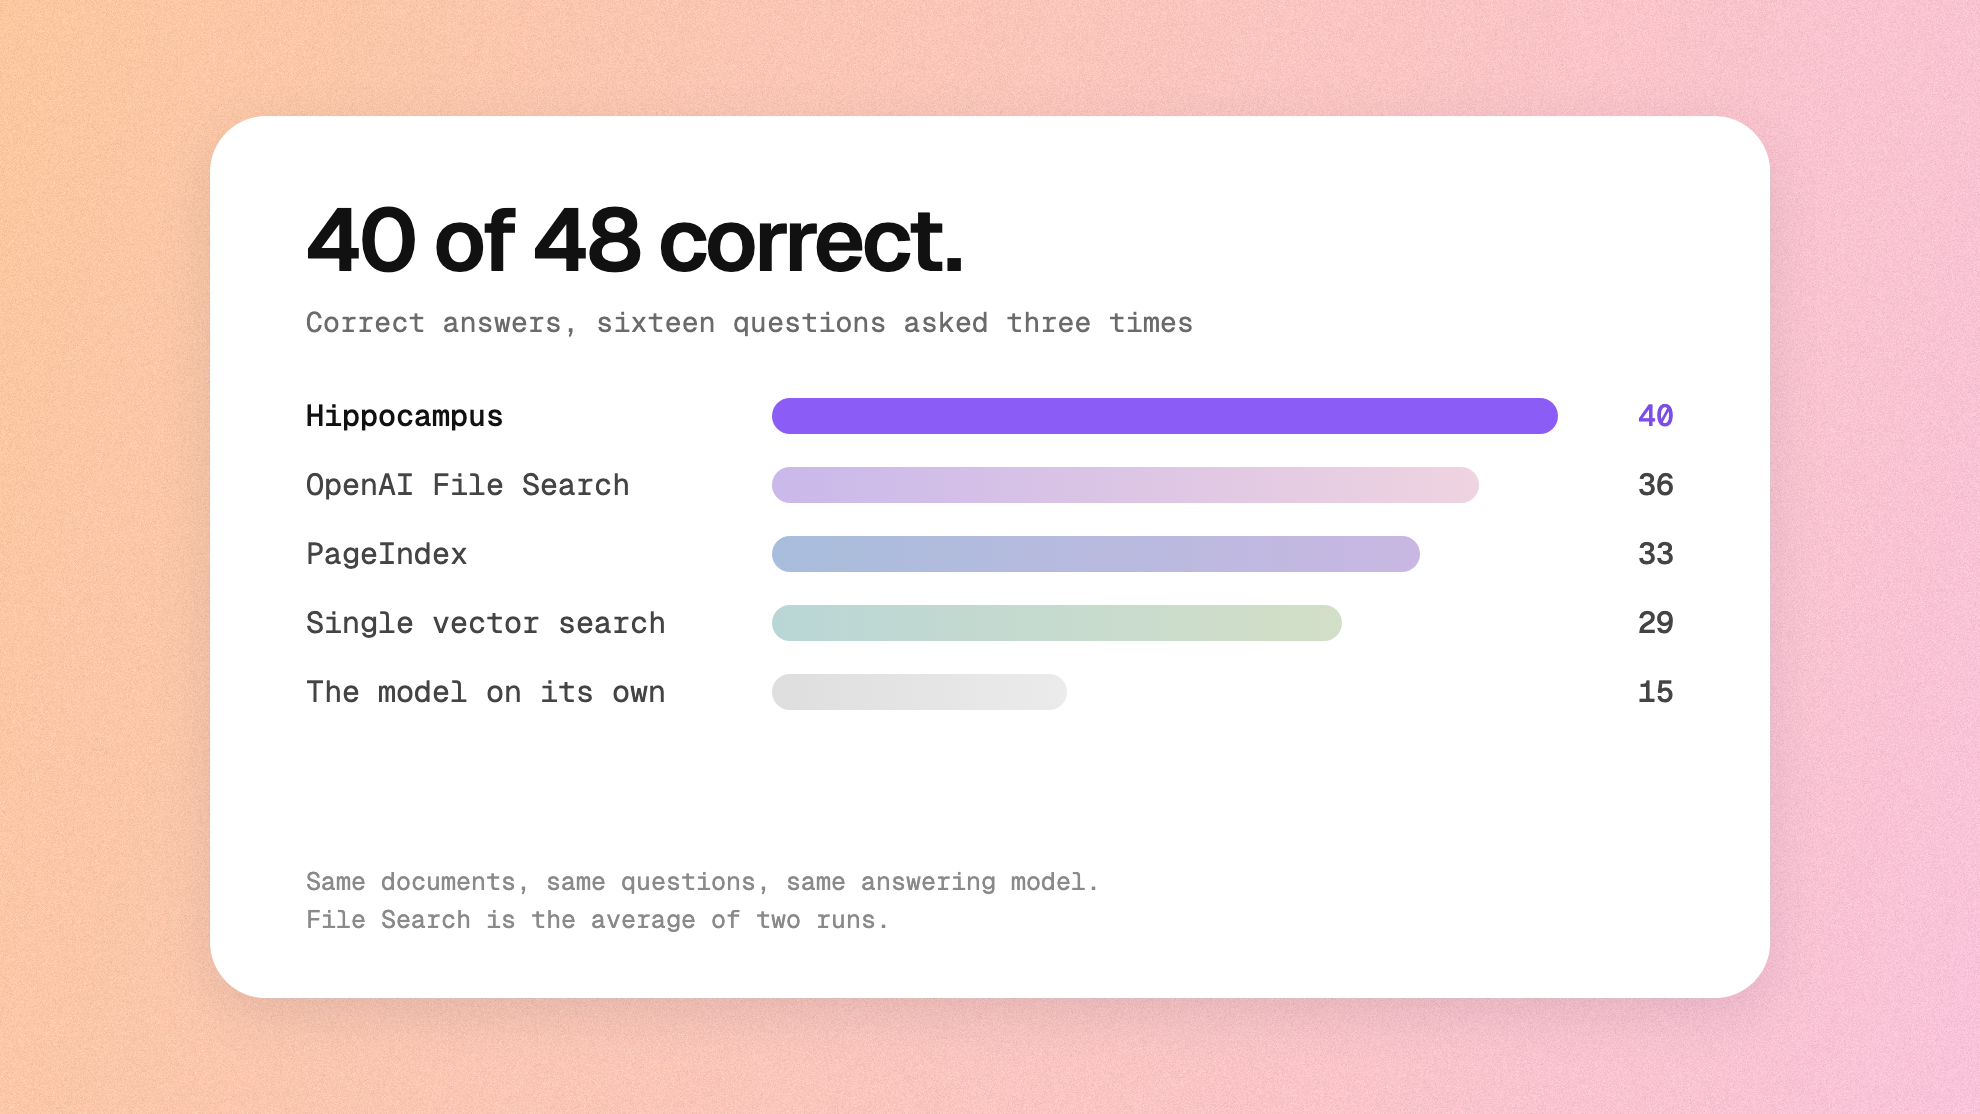

Aperçu
La place d'Hippocampus dans une stack IA
Les modèles raisonnent, les agents agissent et les personnes décident. Entre eux et les documents d'une entreprise se trouve Hippocampus : ses services ingèrent, organisent et récupèrent, et son wiki OKF sécurisé conserve chaque document en Markdown chiffré derrière un seul ensemble d'API.
Identité et clés
Où vit le savoir
Hippocampus
Qui demande
Modèles appelés
appels de modèle en ligne AI services tout modèle de langageOù il tourne
Hippocampus fonctionne sur notre cloud ou sur votre propre hébergement. Le produit est le même dans les deux cas.
- Cloud Hippocampus
- Hébergé et exploité par nous dans l'UE. Inscrivez-vous, puis connectez vos outils d'IA via MCP, ou votre propre code par l'API.
- Auto-hébergement
- Votre propre cloud, sur site ou tout autre environnement que vous maîtrisez. Fait partie de l'offre Corporate.
L'API et le MCP sont identiques dans les deux cas. Seule l'URL de base change.
L'hébergement chez vous se met en place avec nous dans le cadre de Corporate : parlez-nous de Corporate
Architecture
Une mémoire en couches
Une nouvelle fonction mentale pour les LLM : une mémoire externe, en couches, que l'IA crée et entretient, partagée avec les personnes qui l'utilisent.
Hippocampus donne à l'IA et aux personnes une même mémoire partagée et bien organisée. Elle est construite comme une encyclopédie : les documents complexes sont condensés en courts résumés, avec des liens profonds vers le texte qu'ils représentent.
La mémoire est de l'hypertexte, une compétence fondamentale des LLM. Les LLM la créent et l'entretiennent comme un wiki moderne, et ces mêmes pages sont celles que les gens parcourent et vérifient.
La recherche part des titres et des liens. Elle suit un lien vers un résumé lorsqu'un titre est pertinent, et n'ouvre le texte intégral que pour le passage dont la question a besoin, sans modèle génératif. Le modèle ne reçoit que ce passage, si bien que le contexte reste petit quelle que soit la taille du corpus.
- 1 Titres et liensUne ligne par document ou section, chacune étant un lien.
- 2 SummariesDe courts abrégés avec des liens profonds vers le texte.
- 3 Texte intégralLe document en Markdown, avec ses pages et ses plages d'octets.
Propriétés essentielles
- Adapté à d'énormes volumes de donnéesLe modèle reçoit un contexte restreint et pertinent : seulement les passages qui comptent, trouvés par la recherche, et non le corpus. La taille du corpus cesse d'être la limite.
- Contrôle qualité intégréLe contrôle qualité fait partie de la mémoire, ce n'est pas un projet à part, et chaque résumé peut être reconstruit à partir de la source.
- Ouvert par conceptionLes réponses sont traçables et vérifiables : chacune renvoie au passage, à la page et au fichier original dont elle provient.
- Humain dans la boucleLes gens travaillent dans le même wiki que l'IA construit. Ils le parcourent et le vérifient, et les cas qui demandent un jugement sont transmis à une personne : une fonction centrale, pas un ajout tardif.
- Sécurité par rôlesL'accès suit les rôles et les permissions : une réponse n'est construite qu'à partir de ce que la personne ou l'agent qui demande a le droit de lire.
Arbre du document
Voici la recherche sur un seul document. Deux entonnoirs parcourent l'arbre construit à l'import : l'un descend du résumé d'index à travers les résumés de sections qui correspondent à la question, l'autre interroge directement les sections feuilles par mots-clés et embeddings. Leurs résultats sont fusionnés en un seul classement, sans modèle génératif.
- Accord de traitement des données index summary · p. 1–14
- 1 Definitions summary · p. 1–2
- 2 Processing summary · p. 3–5
- 3 Mesures de sécurité summary · p. 6–9
- 3.1 Encryption p. 7 octets [18240, 19012) 1
- 3.2 Contrôle d'accès p. 8 octets [19012, 20330)
- 3.3 Incidents p. 9 octets [20330, 21104)
- 4 Sous-traitants ultérieurs summary · p. 10–14
- 4.1 Sous-traitants ultérieurs p. 10 octets [26410, 27388) 2
- 1 3.1 Encryption
Atteint par les deux entonnoirs : le chemin via 3 Mesures de sécurité et la recherche par feuilles. - 2 4.1 Sous-traitants ultérieurs
Recherche par feuilles seulement : le passage nomme l'hébergeur du sous-traitant.
Import
| Fichier | Ce qui se passe |
|---|---|
.pdf | Reconnaissance de texte avec repères de page, pour que les pages numérisées fonctionnent. L'original est conservé. |
.docx | Converti directement en Markdown, sans reconnaissance de texte. |
.md · .markdown · .txt · .text | Lu tel quel, avec ajout de repères de page. Il n'existe pas d'original PDF pour ces fichiers. |
Un fichier déjà importé est signalé comme doublon. La progression peut être diffusée en continu pendant la lecture du document.
Modèles
- Modèles de réponse
- N'importe quel modèle de langage. Vous choisissez le modèle qui répond, réglé pour chaque espace de travail ; sur Corporate, vous pouvez utiliser votre propre clé de modèle. Dans le chat web, chacun peut choisir le modèle à chaque question. Changer de modèle de réponse ne demande aucune réimportation.
- Embeddings
- Fixé pour un espace de travail : changer de modèle d'embedding invaliderait les vecteurs stockés, ce choix n'est donc pas proposé.
- Accès aux modèles
- Inclus dans le service. Aucun compte ni aucune clé de fournisseur à configurer.
Open Knowledge Format
Chaque document est stocké sous forme de dossier Markdown avec un en-tête YAML, conformément à la spécification Open Knowledge Format: un résumé de l'ensemble du document, le texte intégral, le fichier original et un dossier par section, jusqu'aux sections feuilles. Le Markdown de tout document peut être lu via l'API.
contracts/
└── data-processing-agreement/
    ├── index.md                        résumé de l'ensemble du document
    ├── data-processing-agreement.md    texte intégral en Markdown
    ├── data-processing-agreement.pdf   l'original (aucun pour les envois .md ou .txt)
    └── 03-security-measures/
        ├── index.md                    résumé de la section
└── 03-01-encryption.md une section feuilleRéférence API
Chaque endpoint, paramètre et réponse est décrit dans une référence API distincte.
Référence API