Benchmarks · 17. September 2026
Hippocampus mit FDA-Dokumenten zu GLP-1: 97 % korrekt mit Claude Opus 5
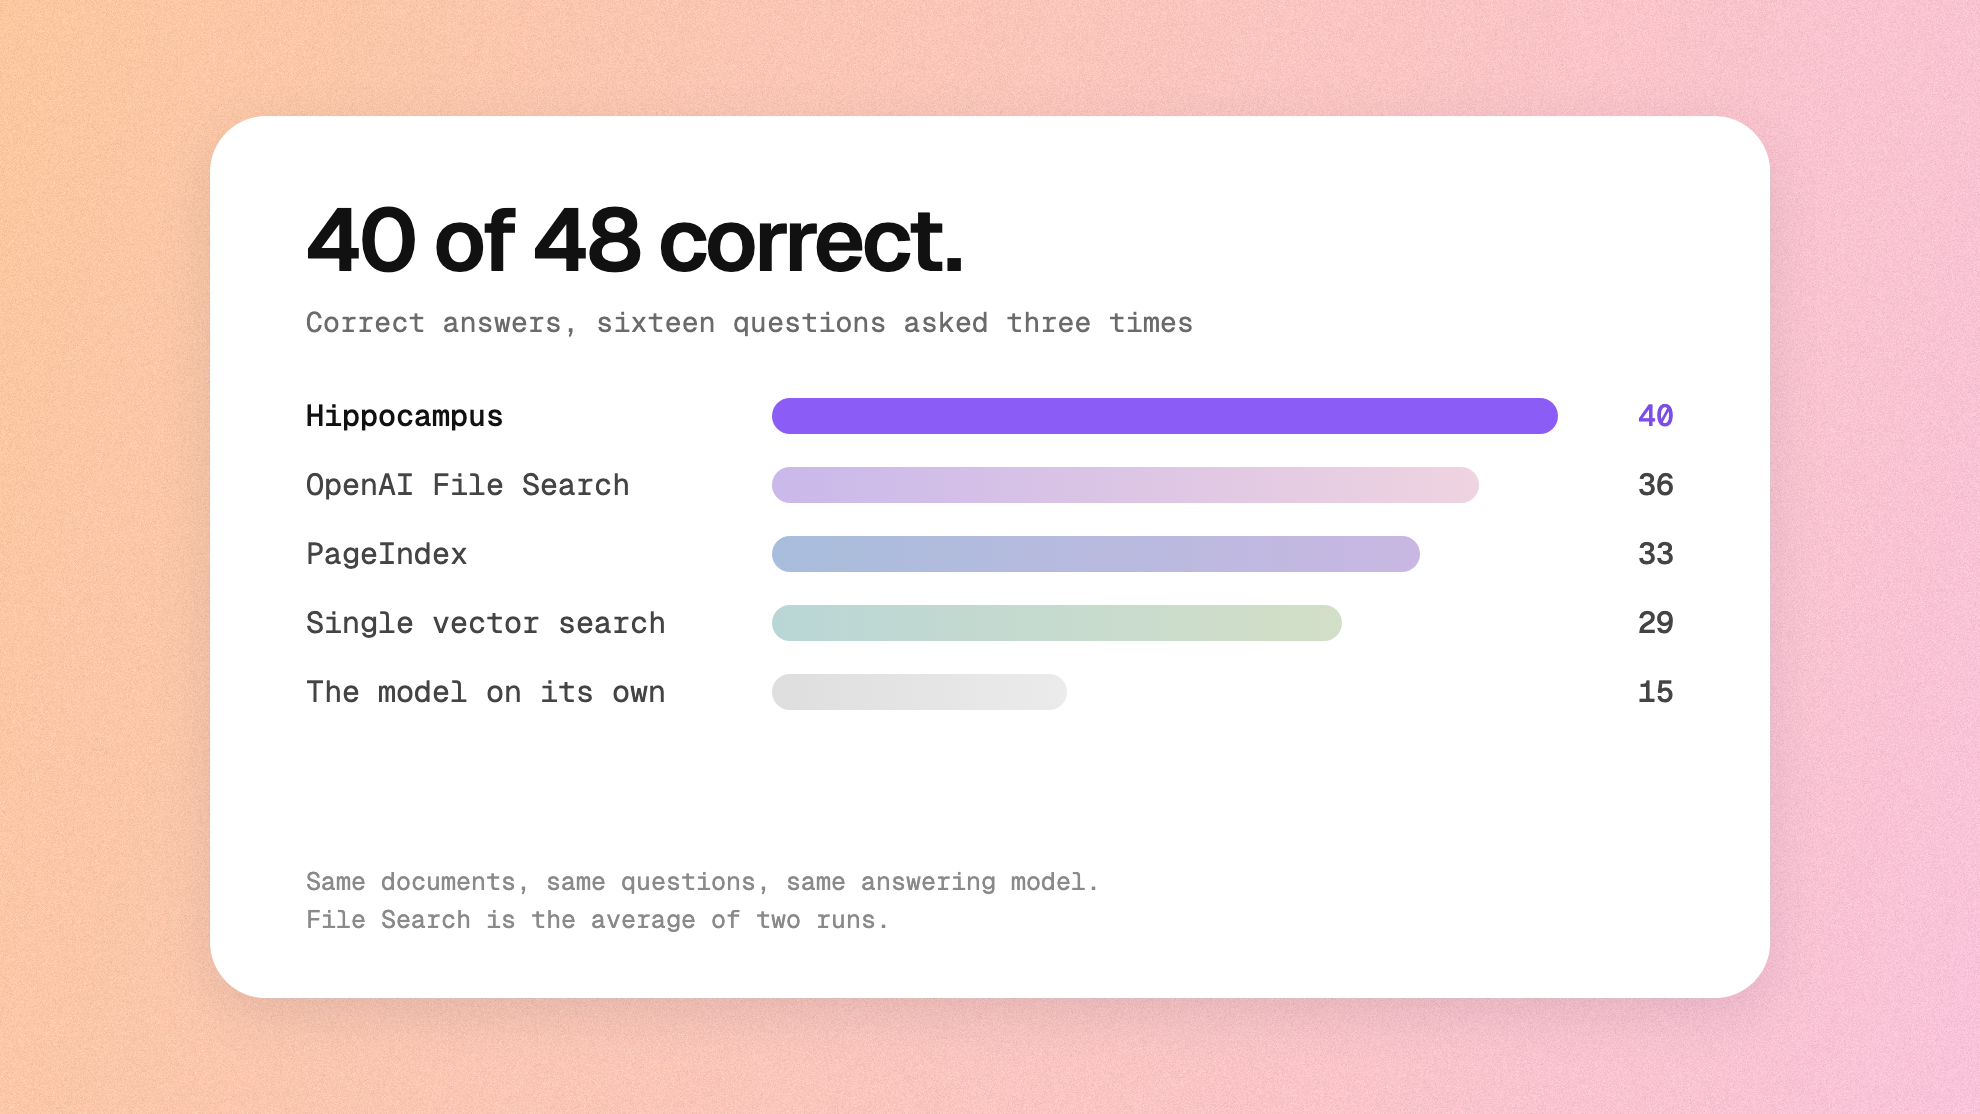
Anhand von 2.198 Seiten öffentlicher FDA-Dokumente gab Hippocampus mit Claude Opus 5 als Antwortmodell 93 von 96 korrekte Antworten (97 %) und erfand nichts. Mit einem kleinen Modell, das für fünf Systeme jede Antwort schrieb, beantwortete Hippocampus 40 von 48 korrekt, die meisten im Vergleich.
Auf dieser SeiteDer Test
Der Test
Zehn öffentliche Dokumente zu drei GLP-1-Therapien zur Gewichtsregulierung: Saxenda und Wegovy von Novo Nordisk, Zepbound von Eli Lilly. Klinische und multidisziplinäre FDA-Prüfberichte mit 230 bis 390 Seiten, Fachinformationen, Zulassungsunterlagen und die STEP-1-Studie im New England Journal of Medicine. Dieselbe Messgröße erscheint an mehreren Stellen, für verschiedene Studien und Zeitpunkte; eine korrekte Antwort hängt daher an der richtigen Passage, nicht nur am richtigen Dokument.
Sechzehn Expertenfragen, gemeinsam mit einem Kunden erarbeitet: 8 leichte (einzelne Fakten), 4 mittlere (Vergleiche über mehrere Dokumente) und 4 schwere (Synthese über die Therapien hinweg, darunter eine Kontrollfrage, die die Dokumente nicht beantworten können und bei der eine Ablehnung richtig ist). Jede Frage wurde dreimal gestellt, in unabhängigen Gesprächen.
Wir berichten über zwei Durchläufe:
- Der Vergleich (17. September 2026): fünf Systeme, ein kleines Antwortmodell, GPT-5.4 mini, für alle.
- Der Frontier-Durchlauf (16. bis 17. September 2026): Hippocampus mit Claude Opus 5 als Antwortmodell, der vollständige Fragensatz zweimal, dazu zwei kostengünstige Modelle.
So lesen Sie die Zahlen
- Korrekt: Ein separates Bewertungsmodell verglich jede Antwort mit der Referenzantwort, drei Stimmen, Mehrheitsentscheid. Die Ablehnung der Kontrollfrage zählt als korrekt.
- Gewichtet: Leichte Fragen zählen einfach, mittlere doppelt, schwere dreifach.
- Richtig in jeder Wiederholung: die Fragen unter den 16, die in jeder Wiederholung korrekt beantwortet wurden; bei Claude Opus 5 in allen sechs Versuchen beider Durchläufe.
- Quelle gefunden: Das Retrieval erreichte mindestens ein Dokument, das die Antwort enthält.
- Kosten: pro Antwort.
Der Vergleich: fünf Systeme, ein kleines Modell
| System | Korrekt von 48 | Gewichtet | Leicht (24) | Mittel (12) | Schwer (12) |
|---|---|---|---|---|---|
| Hippocampus | 40 | 79 % | 23 | 8 | 9 |
| PageIndex | 33 | 65 % | 19 | 6 | 8 |
| OpenAI File Search, Mittel aus 2 Durchläufen | 36 | 64 % | 24 | 6,5 | 5,5 |
| OpenAI Vector Store Search | 29 | 46 % | 21 | 6 | 2 |
| Ohne Dokumente | 15 | 25 % | 12 | 0 | 3 |
OpenAI File Search lief zweimal mit identischen Einstellungen und erreichte 38 und 34; der Abstand zwischen Hippocampus und File Search liegt also innerhalb der Schwankung zwischen Durchläufen. Die Abstände zu PageIndex, zum Vector Store und zum Modell allein sind größer.
Nachschlagefragen sind für alle leicht. Der Unterschied liegt bei Vergleich und Synthese: Von den 24 mittleren und schweren Antworten waren bei Hippocampus 17 richtig, einschließlich der Kontrollfrage, bei PageIndex 14, bei File Search im Mittel 12 (14 und 10) und beim Vector Store 8.
Bei der Kontrollfrage lehnte PageIndex jedes Mal ab. Hippocampus erklärte jedes Mal, dass die Dokumente keine Rangfolge stützen, und bot in zwei von drei Antworten die Zulassungsreihenfolge als gekennzeichneten Näherungswert an. File Search gab in 4 von 6 Versuchen eine Rangfolge als Antwort, der Vector Store in 1 von 3.
Richtige Antworten nach Schwierigkeit, ein kleines Modell für jedes System
Jeder Balken zählt die richtigen Antworten von 24: links die 8 leichten Fragen, rechts die 4 mittleren und 4 schweren Fragen, jede dreimal gestellt.
Leichte Fragen, von 24
- Hippocampus 23 von 24
- PageIndex 19 von 24
- OpenAI File Search, Durchschnitt von 2 Durchläufen 24 von 24
- OpenAI-Vector-Store-Suche 21 von 24
- Keine Dokumente 12 von 24
Mittlere und schwere Fragen, von 24
- Hippocampus 17 von 24
- PageIndex 14 von 24
- OpenAI File Search, Durchschnitt von 2 Durchläufen 12 von 24
- OpenAI-Vector-Store-Suche 8 von 24
- Keine Dokumente 3 von 24
Tabellenansicht: jede Zahl hinter dem Diagramm
| Gruppe | Name | Wert | Hinweis |
|---|---|---|---|
| Leichte Fragen, von 24 | Hippocampus | 23 von 24 | |
| Leichte Fragen, von 24 | PageIndex | 19 von 24 | Unsere Adaption des veröffentlichten Tree-Search-Ansatzes |
| Leichte Fragen, von 24 | OpenAI File Search, Durchschnitt von 2 Durchläufen | 24 von 24 | Durchschnitt aus zwei identischen Durchläufen |
| Leichte Fragen, von 24 | OpenAI-Vector-Store-Suche | 21 von 24 | |
| Leichte Fragen, von 24 | Keine Dokumente | 12 von 24 | Das eigene Wissen des Modells |
| Mittlere und schwere Fragen, von 24 | Hippocampus | 17 von 24 | Enthält die Kontrollfrage |
| Mittlere und schwere Fragen, von 24 | PageIndex | 14 von 24 | |
| Mittlere und schwere Fragen, von 24 | OpenAI File Search, Durchschnitt von 2 Durchläufen | 12 von 24 | Durchschnitt aus zwei Durchläufen: 14 und 10 |
| Mittlere und schwere Fragen, von 24 | OpenAI-Vector-Store-Suche | 8 von 24 | |
| Mittlere und schwere Fragen, von 24 | Keine Dokumente | 3 von 24 |
Der Frontier-Durchlauf: dasselbe Retrieval, drei Antwortmodelle
| Antwortmodell | Korrekt | Richtig in jeder Wiederholung | Erfunden | Quelle gefunden | Kosten |
|---|---|---|---|---|---|
| Claude Opus 5, zwei Durchläufe | 93 von 96 | 15 von 16 | 0 | 100 % | $0.61 |
| GPT-5.4 mini | 40 von 48 | 11 von 16 | 0 | 98 % | $0.12 |
| Claude Haiku 4.5 | 38 von 48 | 11 von 16 | 0 | 93 % | $0.09 |
Claude Opus 5 erreichte in zwei Durchläufen im Abstand weniger Stunden 47 und 46 von 48 und lehnte die Kontrollfrage 6 von 6 Mal ab. Die Spanne von einer Antwort ist das ehrliche Maß für Wiederholbarkeit. Der Durchlauf war auf Genauigkeit ausgelegt, nicht auf Sparsamkeit: erweitertes Reasoning und so viele Suchen, wie jede Frage brauchte. Kostengünstige Modelle mit demselben Retrieval beantworten 38 bis 40 von 48 korrekt, zu 0,09 bis 0,12 $ pro Antwort, ohne je eine Antwort zu erfinden.
Immer richtig beantwortete Fragen, drei Antwortmodelle auf Hippocampus
Jeder Balken zählt die Fragen von 16, die in jeder Wiederholung richtig beantwortet wurden, mit demselben Hippocampus-Retrieval und einem anderen Antwortmodell.
- Claude Opus 5, zwei Durchläufe 15 von 16
- GPT-5.4 mini 11 von 16
- Claude Haiku 4.5 11 von 16
Tabellenansicht: jede Zahl hinter dem Diagramm
| Name | Wert | Hinweis |
|---|---|---|
| Claude Opus 5, zwei Durchläufe | 15 von 16 | Alle sechs Versuche; 93 von 96 Antworten korrekt |
| GPT-5.4 mini | 11 von 16 | Drei Versuche; 40 von 48 Antworten korrekt |
| Claude Haiku 4.5 | 11 von 16 | Drei Versuche; 38 von 48 Antworten korrekt |
Der Fehler
Alle drei Fehler von Opus stammen aus einer Frage: welche Sicherheitssignale alle drei Therapien gemeinsam haben. Ein Anstieg der Herzfrequenz wird für alle drei berichtet, aber die FDA führt ihn bei Saxenda und Wegovy unter „Warnings and Precautions“ und bei Zepbound unter „Adverse Reactions“. Eine Antwort, die nur die Warnhinweislisten vergleicht, schließt aus einer wahren Prämisse, dass das Signal nicht allen gemeinsam ist. Aus dem Gedächtnis gefragt, ordneten zwei von drei Frontier-Modellen die Stelle falsch ein, in entgegengesetzte Richtungen.
Hippocampus leitet das Modell jetzt an, die eigenen Dokumente jedes Produkts zu durchsuchen, bevor es erklärt, dass etwas fehlt. Damit wertete es das Signal in 3 von 6 Wiederholungen als allen gemeinsam; das vorherige Release tat dies in 1 von 6.
Ehrliche Anmerkungen
- Hippocampus-Konfigurationen, die am 16. und 17. September mit GPT-5.4 mini getestet wurden, erreichten zwischen 37 und 40 von 48. Der Vergleich zeigt einen Durchlauf mit 40, früher am selben Tag auf dem produktiv eingesetzten Dienst durchgeführt, getrennt von den anderen Systemen.
- Der Suchleitfaden, den Hippocampus dem Modell gibt, wurde in früheren Durchläufen anhand derselben sechzehn Fragen verfeinert. Die anderen Systeme liefen mit den Standardeinstellungen der Anbieter plus einer Anweisung in einem Satz, nur aus dem Material zu antworten.
- Das Bewertungsmodell des Vergleichs ist GPT-5. Das Antwortmodell und zwei der getesteten Systeme stammen ebenfalls von OpenAI.
- Vor dem Vergleich wurden drei Referenzantworten anhand der Quelldokumente korrigiert, und jedes System wurde gegen denselben korrigierten Satz bewertet.
- PageIndex lief als unsere Adaption seines veröffentlichten Tree-Search-Ansatzes: ein Schritt, bis zu sechs Abschnitte, 12.000 Zeichen pro Abschnitt. Die eigenen Retrieval- und Chat-Dienste von PageIndex wurden nicht genutzt.
- Etwa 410 der 2.198 Seiten haben keine Textebene, darunter alle 300 Seiten eines Pharmakologie-Reviews von 2009. OpenAIs Vector Store enthielt keinen Text aus diesem Review; Hippocampus und PageIndex lesen gescannte Seiten. Kein System zitierte ihn, und die eine Frage, die darauf zurückgreift, lässt sich auch aus einem Label beantworten.
- Drei Wiederholungen trennen stabiles Verhalten von Zufall. Ein Konfidenzintervall liefern sie nicht.
Geschwindigkeit
Die Zeiten gelten jeweils für eine vollständige Antwort, einschließlich aller Suchen, die das Modell selbst veranlasste. Im Vergleich brauchte Hippocampus im Median 20 Sekunden, gegenüber 5 bis 8 Sekunden bei den anderen Systemen mit Dokumenten, und über zwei Minuten bei den langsamsten 5 %. Antworten mit einer einzigen Suche dauerten etwa 10 Sekunden; die langsamen waren Vergleichs- und Synthesefragen, bei denen das Modell viele Male suchte. Mit Claude Opus 5 lag der Median bei 46 Sekunden.
So haben wir getestet
Jedes System arbeitete mit denselben zehn PDFs und denselben sechzehn Fragen. In Hippocampus durchsucht das Modell die Sammlung so oft, wie es nötig ist, mit hierarchischem Retrieval (Patent angemeldet), und zitiert für jede Aussage Dokument, Abschnitt und Seite. Die vollständige Methode finden Sie auf der Nachweisseite im Tab „Gesundheitswesen“.
Die Dokumente sind öffentlich. Die Fragen und Referenzantworten gehören dem Kunden, mit dem sie erarbeitet wurden; mit dessen Zustimmung führen wir qualifizierte Interessenten unter NDA durch jede bewertete Antwort.