
Låt oss dyka ner i artikeln som lade grunden för mycket av den senaste AI-utvecklingen: Scaling Laws for Neural Language Models.
Artikeln studerar hur prestandan hos AI-språkmodeller förändras när de skalas upp. Resultaten ledde till att konkurrensen mellan AI-jättar som OpenAI och Google skiftade från att bygga de ”smartaste” modellerna till att köpa mer hjärnkraft.
Men vad är hjärnkraft?
I det här sammanhanget betyder hjärnkraft inte intelligens i mänsklig mening. Det syftar på tre konkreta resurser:
-
Modellstorlek: hur många parametrar modellen har – i praktiken hur många miljoner eller miljarder tal den kan använda för att lagra mönster och samband
-
Träningsdata: hur mycket text (och annan data) modellen lär sig av
-
Beräkningskraft: hur mycket processorkraft som används under träningen – i praktiken hur många NVIDIA-chip du har råd att köra, och hur länge
Tillsammans utgör dessa tre resurser motorn bakom många av de AI-modeller människor använder varje dag, som ChatGPT eller Gemini. De tre komponenterna är tätt sammanlänkade. Om en är begränsad kan de andra ofta kompensera – men bara genom att öka kostnaden någon annanstans.
Så hur bygger de optimala modeller?
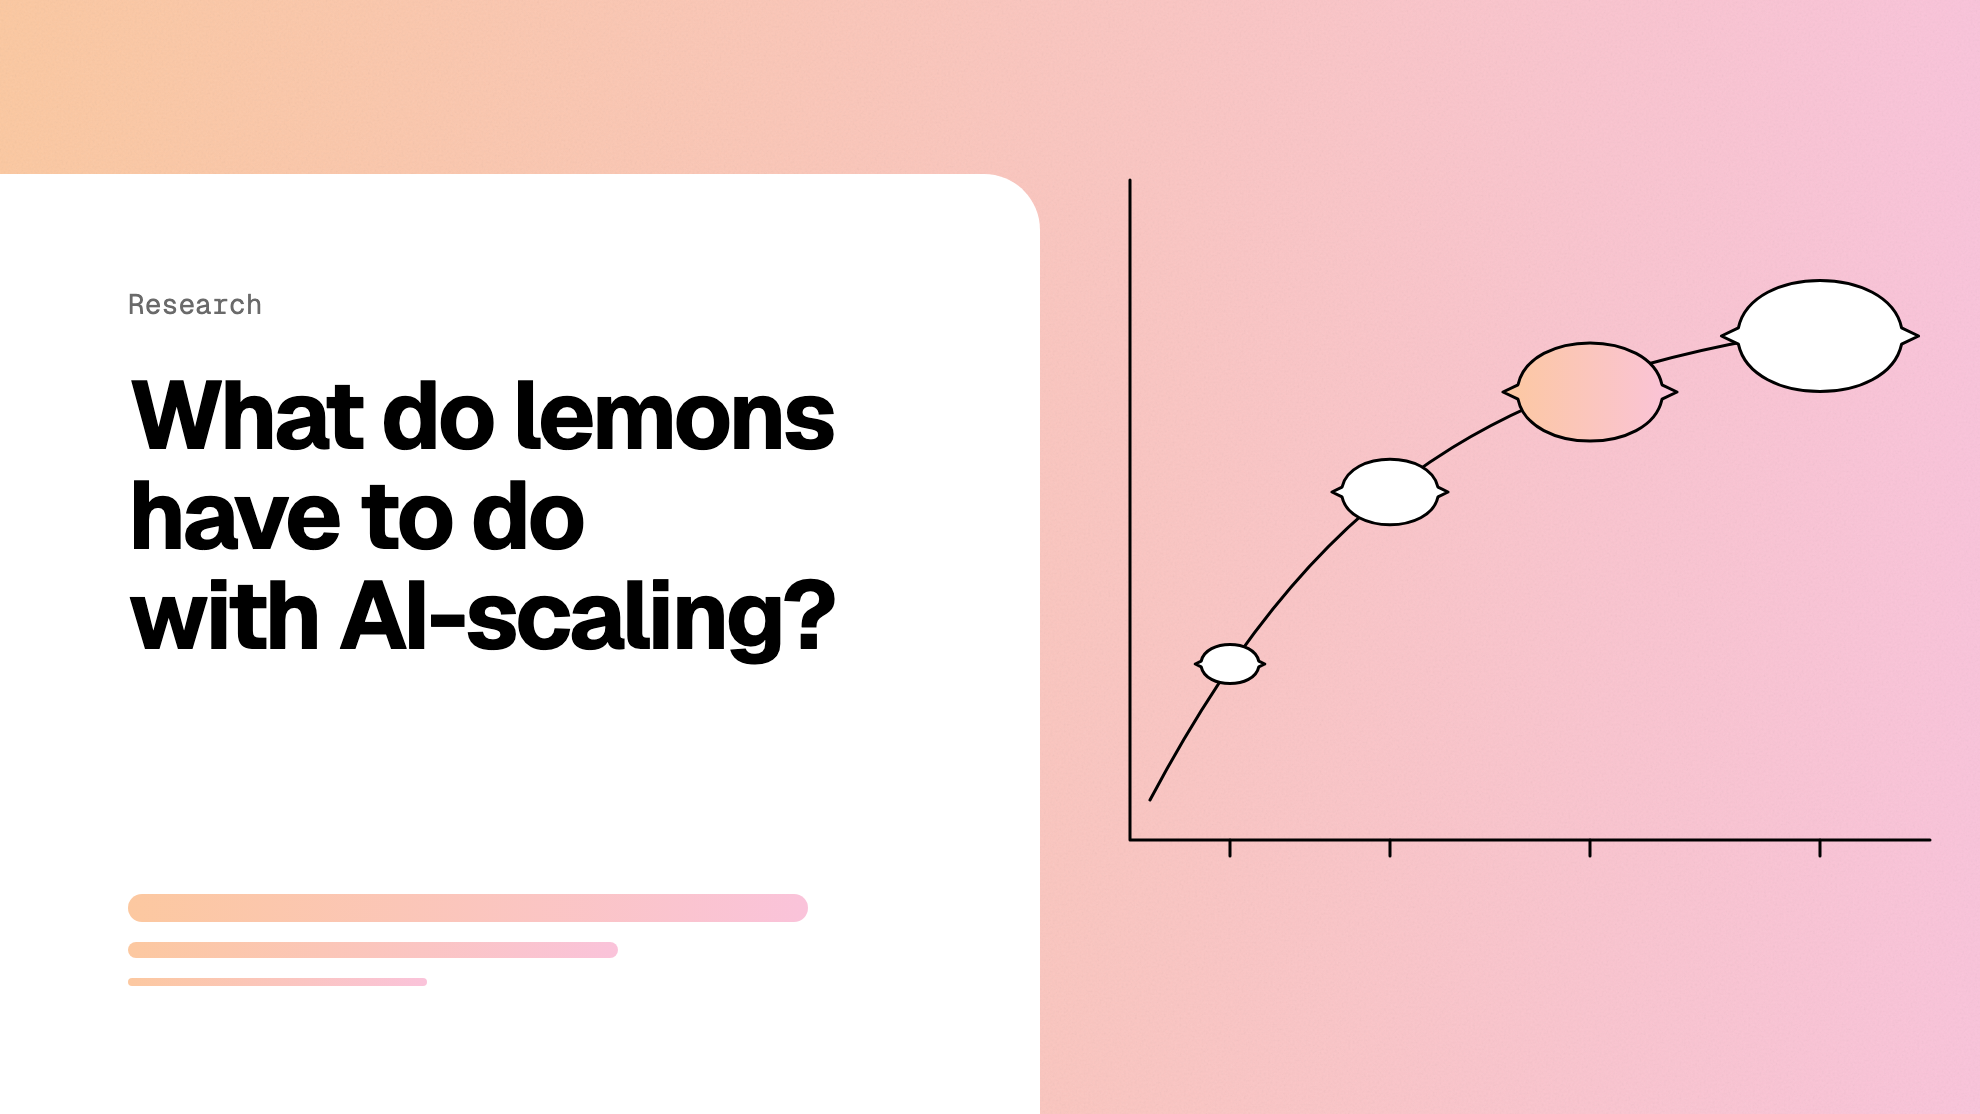
Författarna visar att modellprestanda förbättras förutsägbart när resurserna ökar. När dessa komponenter skalas följer prestandan jämna kurvor snarare än plötsliga hopp. Den förutsägbarheten gör att forskare på förhand kan uppskatta hur stor förbättring de sannolikt får av att lägga mer resurser. De vet alltså att om de köper 4 citroner till får de ungefär 100 ml juice.
Ett andra mönster är att skala betyder mer än smart optimering. När en modell väl är rimligt väl utformad ger ytterligare finjustering begränsade vinster. Att öka kapacitet, data och beräkningskraft tenderar att ge mer tillförlitliga förbättringar än att pressa extra prestanda ur mindre modeller.
Vad betyder ”optimal” egentligen?
Skalning betyder inte att öka allt i blindo. Artikeln visar att det finns en optimal balans mellan modellstorlek och träningsdata. Många modeller är antingen för stora för den data de ser eller tränade på för lite data för sin storlek, vilket leder till bortkastad beräkningskraft.
Författarna finner också att större modeller är mer exempeleffektiva. Större modeller lär sig mer av varje exempel och når ofta högre prestanda med färre träningssteg än mindre, noggrant optimerade modeller. Det hjälper till att förklara varför skalning blev dominerande: det är inte bara enklare, utan ofta ett effektivare sätt att göra framsteg – även om varje förbättring kommer till en högre kostnad.
Så varför samarbetar vi inte bara, lägger biljoner på beräkningskraft och får en megabra AI?
Artikeln gör klart varför det angreppssättet stöter på gränser. Avtagande avkastning är oundviklig. Varje ytterligare enhet beräkningskraft ger en mindre förbättring än den förra. Skalning fortsätter visserligen att fungera, men den blir allt dyrare, både ekonomiskt och operativt.
Vid någon punkt skiftar frågan från ”kan vi skala vidare?” till ”är det värt att betala för de marginella vinster vi får?”
Framtiden
Den här artikeln lade mycket av grunden för dagens stora språkmodeller. Men den blottlägger också en strukturell gräns: framsteg som i första hand bygger på skala blir allt dyrare och allt ineffektivare.
Vi tror att detta markerar början på nästa fas i AI-utvecklingen. En där vinsterna inte kommer från att köpa mer beräkningskraft, utan från att utforma system som använder intelligens mer avsiktligt.
På Thalius arbetar vi med exakt det skiftet. Mer om detta snart.