Atrogi · 18 septembre 2026
Comment Atrogi utilise Hippocampus pour croiser 2 198 pages de documents de la FDA
Une société pharmaceutique en phase clinique qui développe un médicament contre une maladie métabolique utilise Hippocampus pour croiser les thérapies concurrentes avant d'engager ses dépenses de R&D.
Sur cette pageLe problème
Le problème
Avant qu'Atrogi décide où ira le prochain budget de recherche, l'équipe doit savoir ce que les autorités de réglementation et les essais antérieurs ont constaté pour les thérapies ayant la même finalité : doses, taux d'arrêt du traitement, signaux de sécurité, durées de protection des brevets. Pour les trois principales thérapies GLP-1 de gestion du poids, ces preuves se trouvent dans dix évaluations et notices de la FDA et une publication d'essai. 2 198 pages. Les outils d'IA qu'Atrogi avait essayés manquaient la réponse ou en inventaient une.
L'évaluation
L'équipe d'Atrogi a rédigé seize questions, du fait isolé à la synthèse à travers les trois thérapies, plus une question à laquelle les documents ne peuvent pas répondre, pour voir si le système l'admettrait. Chaque question a été posée trois fois dans des conversations distinctes, et la série complète a été exécutée deux fois.
Ce qui s'est passé
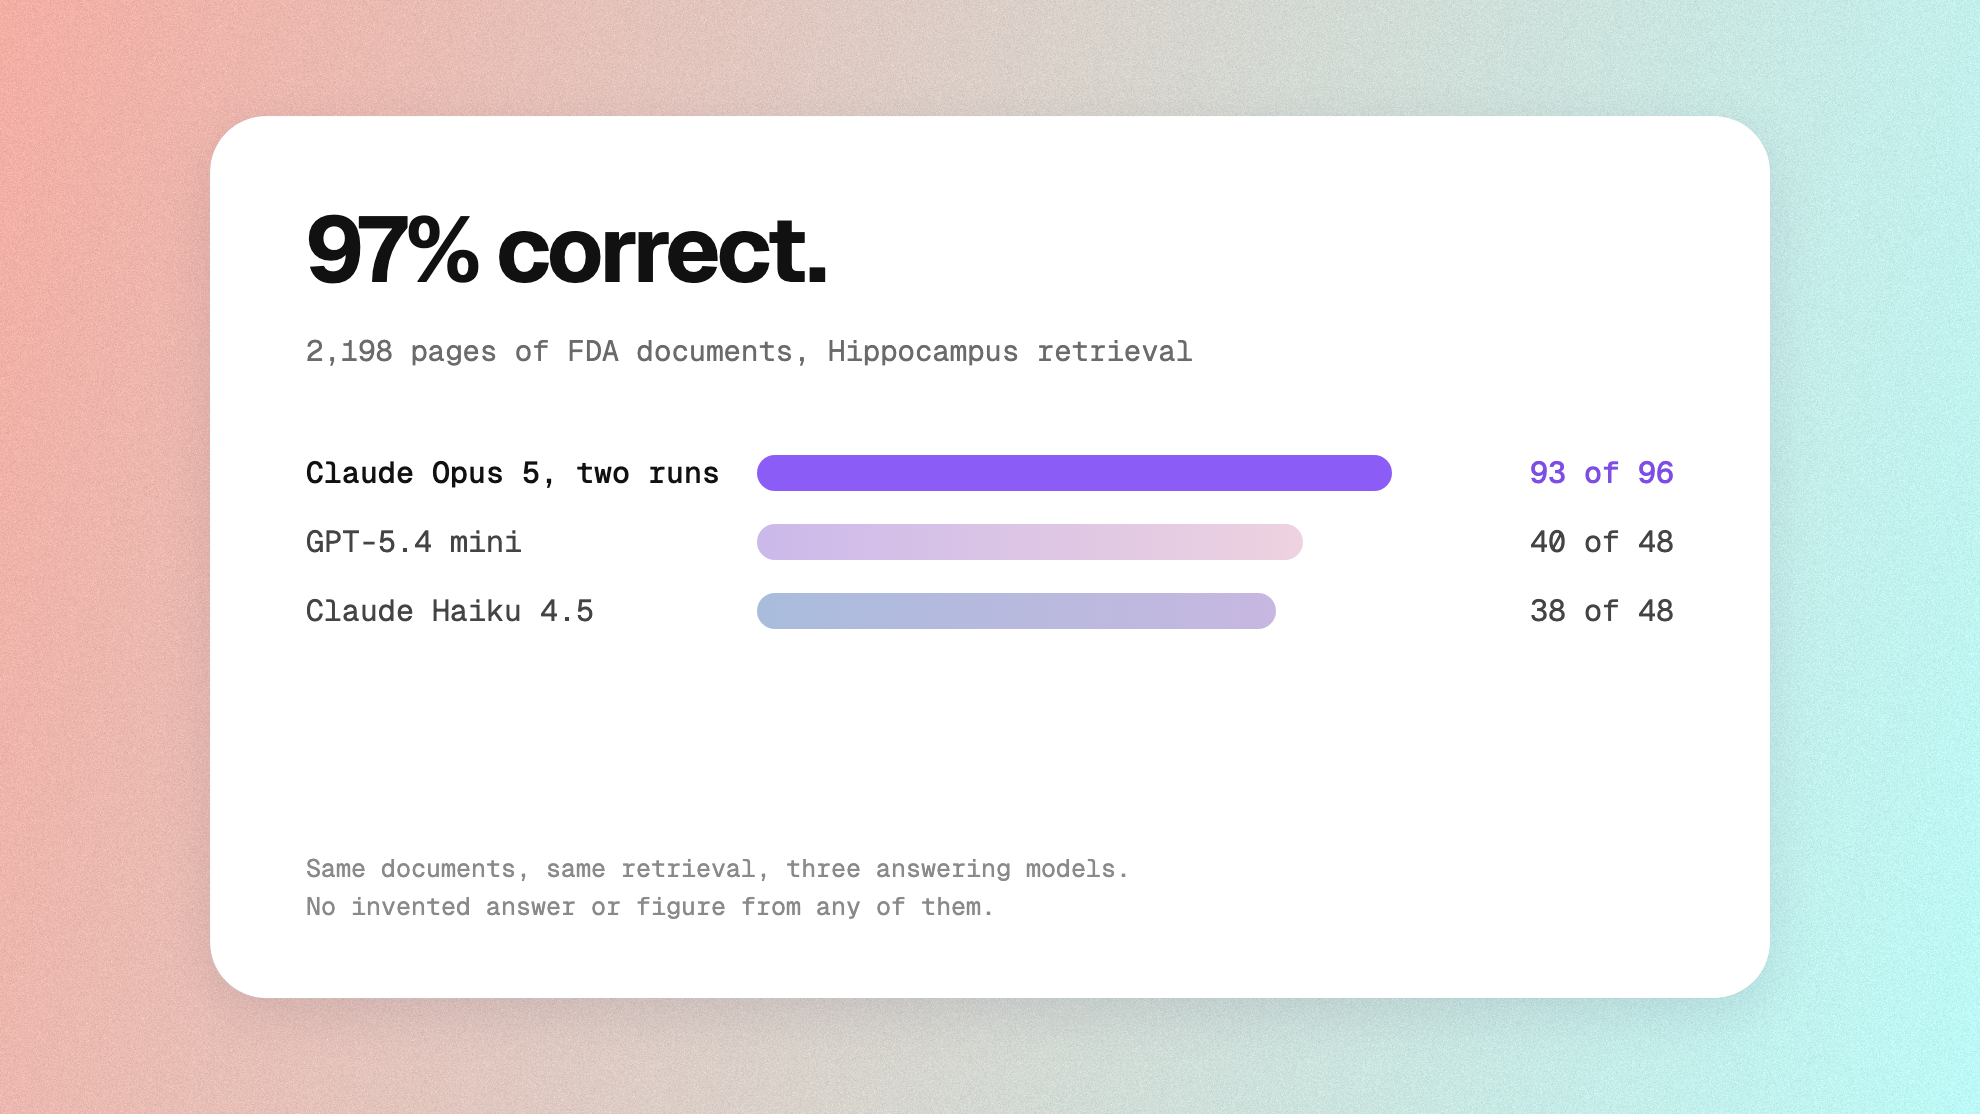
- 93 réponses correctes sur 96. Quinze questions sur seize justes à chacune des six répétitions.
- Zéro réponse ou chiffre inventé.
- La question sans réponse déclinée six fois sur six. Invité à classer les thérapies selon le délai avant la concurrence des génériques, le système a dit ce qui manquait au lieu de produire un classement plausible.
- Chaque réponse citée avec document, section et page.
Les trois erreurs proviennent d'une seule question : quels signaux de sécurité les trois thérapies partagent-elles. La FDA classe la même constatation sur la fréquence cardiaque sous une section différente pour l'une des trois. Deux des trois modèles de pointe répondant de mémoire se trompent. Hippocampus a répondu juste 3 fois sur 6, contre 1 sur 6 dans la version précédente.
Réponses correctes à chaque exécution complète
Chaque barre est une exécution complète des seize questions, chacune posée trois fois, avec Claude Opus 5 comme modèle de réponse : 93 sur 96 au total.
- Une exécution 47 sur 48
- L'autre exécution 46 sur 48
Vue tableau : chaque décompte derrière le graphique
| Nom | Valeur |
|---|---|
| Une exécution | 47 sur 48 |
| L'autre exécution | 46 sur 48 |
La question avec des erreurs, par version
Chaque barre compte les bonnes réponses sur six répétitions de la question portant sur les signaux de sécurité que les trois thérapies partagent.
- Hippocampus, cette version 3 sur 6
- Hippocampus, version précédente 1 sur 6
Vue tableau : chaque décompte derrière le graphique
| Nom | Valeur |
|---|---|
| Hippocampus, cette version | 3 sur 6 |
| Hippocampus, version précédente | 1 sur 6 |
Vérifiez par vous-même
Les dix documents sont publics. Nous les chargerons dans un espace de travail séparé pour que vous puissiez poser vos propres questions, avec le modèle de votre choix. La méthode, le corpus et le score de chaque question sont sur la page du benchmark.
*Claude Opus 5 comme modèle de réponse. 16 questions d'expert, chacune posée trois fois par répétition, série complète exécutée deux fois (96 réponses), sur 10 documents publics de la FDA (2 198 pages) pour trois thérapies GLP-1. Évaluation Thalius, 16 et 17 septembre 2026.