Atrogi · 18 de septiembre de 2026
Cómo Atrogi usa Hippocampus para contrastar 2.198 páginas de documentos de la FDA
Una farmacéutica en fase clínica que desarrolla un fármaco para una enfermedad metabólica usa Hippocampus para contrastar terapias competidoras antes de comprometer inversión en I+D.
En esta páginaEl problema
El problema
Antes de que Atrogi decida adónde va el próximo presupuesto de investigación, el equipo necesita saber qué encontraron los reguladores y los ensayos anteriores para terapias con el mismo fin: dosis, tasas de abandono, señales de seguridad, vigencia de patentes. Para las tres principales terapias GLP-1 de control de peso, esa evidencia está en diez revisiones de la FDA, fichas técnicas y una publicación de ensayo. 2.198 páginas. Las herramientas de IA que Atrogi había probado o no encontraban la respuesta o se la inventaban.
La evaluación
El equipo de Atrogi redactó dieciséis preguntas, desde datos aislados hasta síntesis sobre las tres terapias, más una pregunta que los documentos no pueden responder, para ver si el sistema lo admitiría. Cada pregunta se formuló tres veces en conversaciones separadas, y el conjunto completo se ejecutó dos veces.
Qué ocurrió
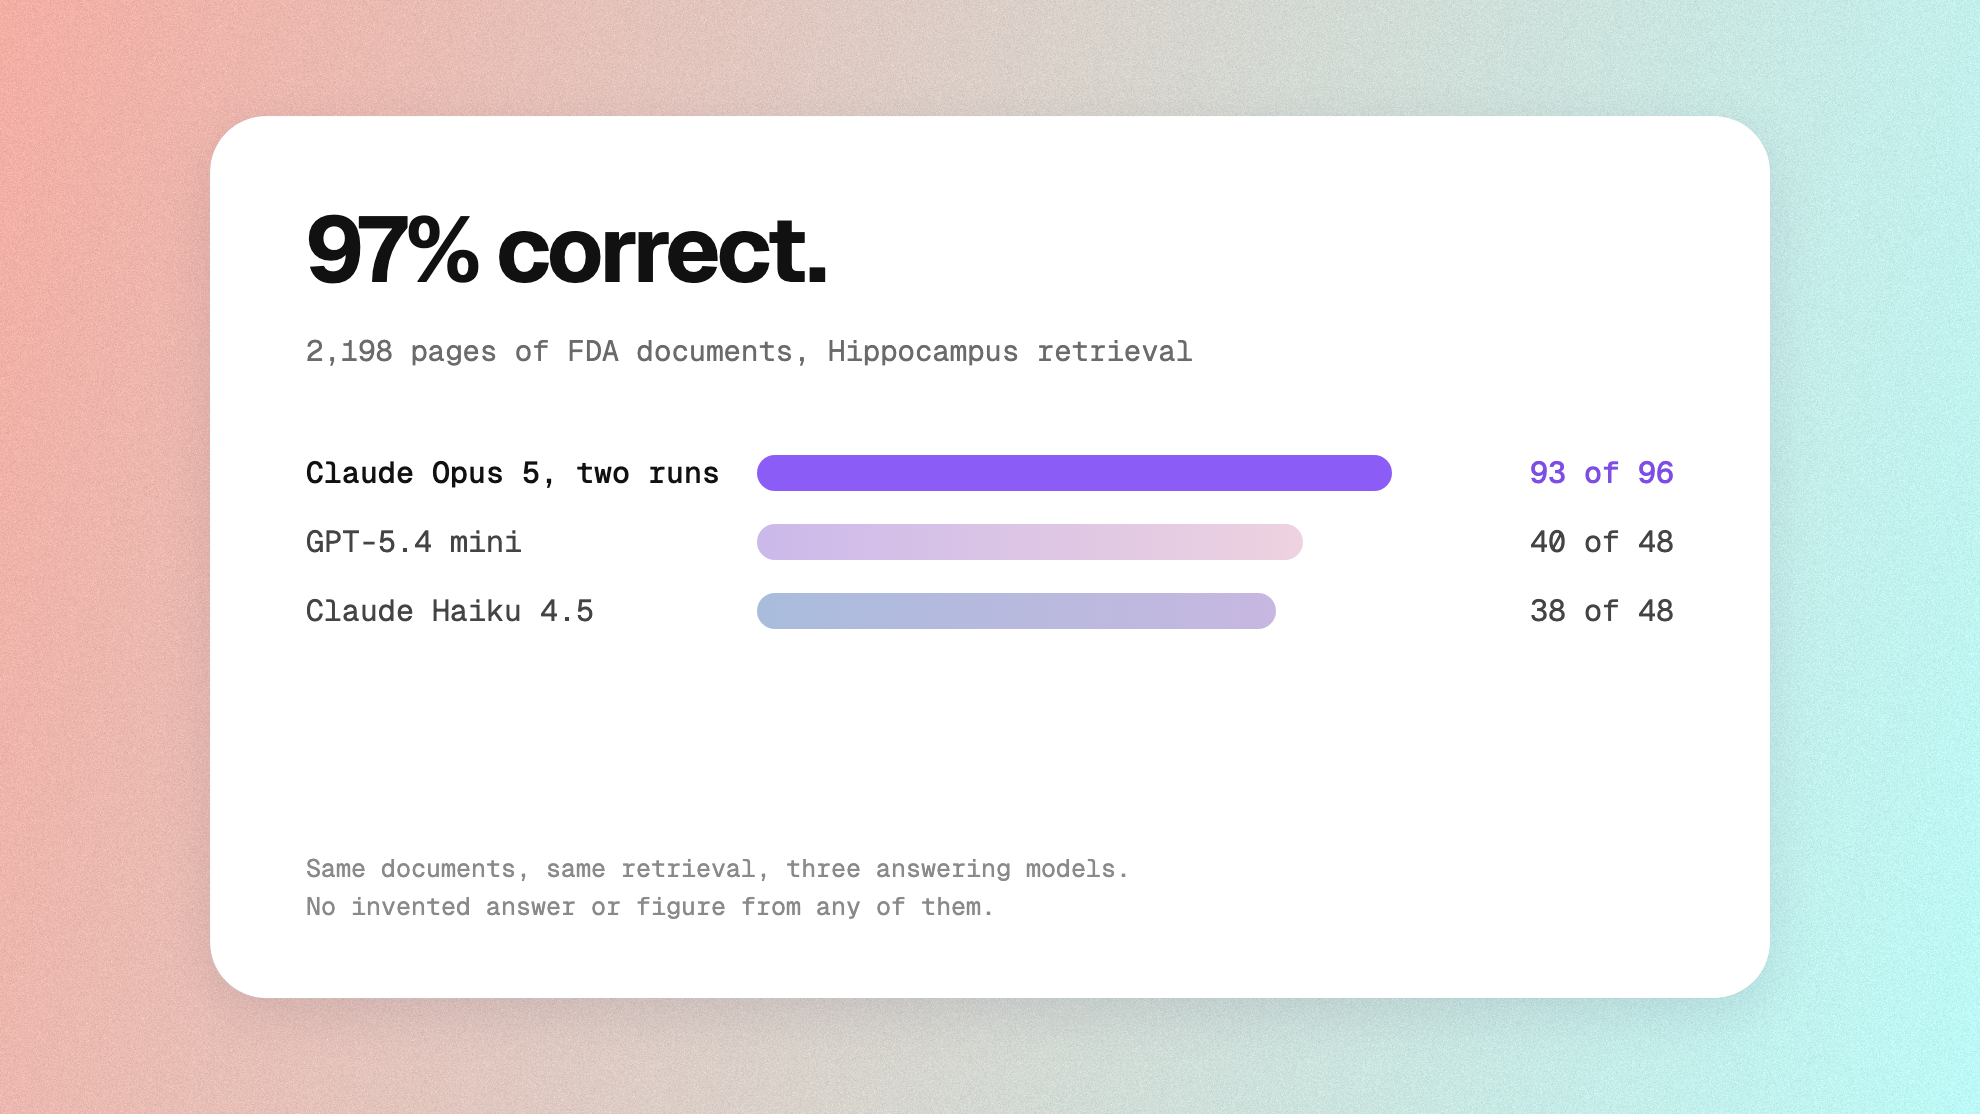
- 93 de 96 respuestas correctas. Quince de las dieciséis preguntas acertadas en cada una de las seis repeticiones.
- Cero respuestas o cifras inventadas.
- La pregunta sin respuesta, rechazada seis veces de seis. Al pedirle que ordenara las terapias por tiempo hasta la competencia de genéricos, el sistema dijo qué faltaba en lugar de producir una clasificación verosímil.
- Cada respuesta citada con documento, sección y página.
Los tres fallos provienen de una sola pregunta: qué señales de seguridad comparten las tres terapias. La FDA archiva el mismo hallazgo de frecuencia cardíaca en una sección distinta para una de las tres. Dos de los tres modelos de frontera que responden de memoria se equivocan. Hippocampus acertó 3 de 6 veces, frente a 1 de 6 en la versión anterior.
Respuestas correctas en cada ejecución completa
Cada barra es una ejecución completa de las dieciséis preguntas, cada una formulada tres veces, con Claude Opus 5 como modelo de respuesta: 93 de 96 en conjunto.
- Una ejecución 47 de 48
- La otra ejecución 46 de 48
Vista de tabla: cada recuento detrás del gráfico
| Nombre | Valor |
|---|---|
| Una ejecución | 47 de 48 |
| La otra ejecución | 46 de 48 |
La única pregunta con fallos, por versión
Cada barra cuenta las respuestas correctas en seis repeticiones de la pregunta sobre las señales de seguridad que comparten las tres terapias.
- Hippocampus, esta versión 3 de 6
- Hippocampus, versión anterior 1 de 6
Vista de tabla: cada recuento detrás del gráfico
| Nombre | Valor |
|---|---|
| Hippocampus, esta versión | 3 de 6 |
| Hippocampus, versión anterior | 1 de 6 |
Compruébalo por tu cuenta
Los diez documentos son públicos. Los cargaremos en un espacio de trabajo independiente para que puedas hacer tus propias preguntas, con el modelo que elijas. El método, el corpus y la puntuación de cada pregunta están en la página del benchmark.
*Claude Opus 5 como modelo de respuesta. 16 preguntas de expertos, cada una formulada tres veces por repetición, conjunto completo ejecutado dos veces (96 respuestas), sobre 10 documentos públicos de la FDA (2.198 páginas) para tres terapias GLP-1. Evaluación de Thalius, 16 a 17 de septiembre de 2026.